
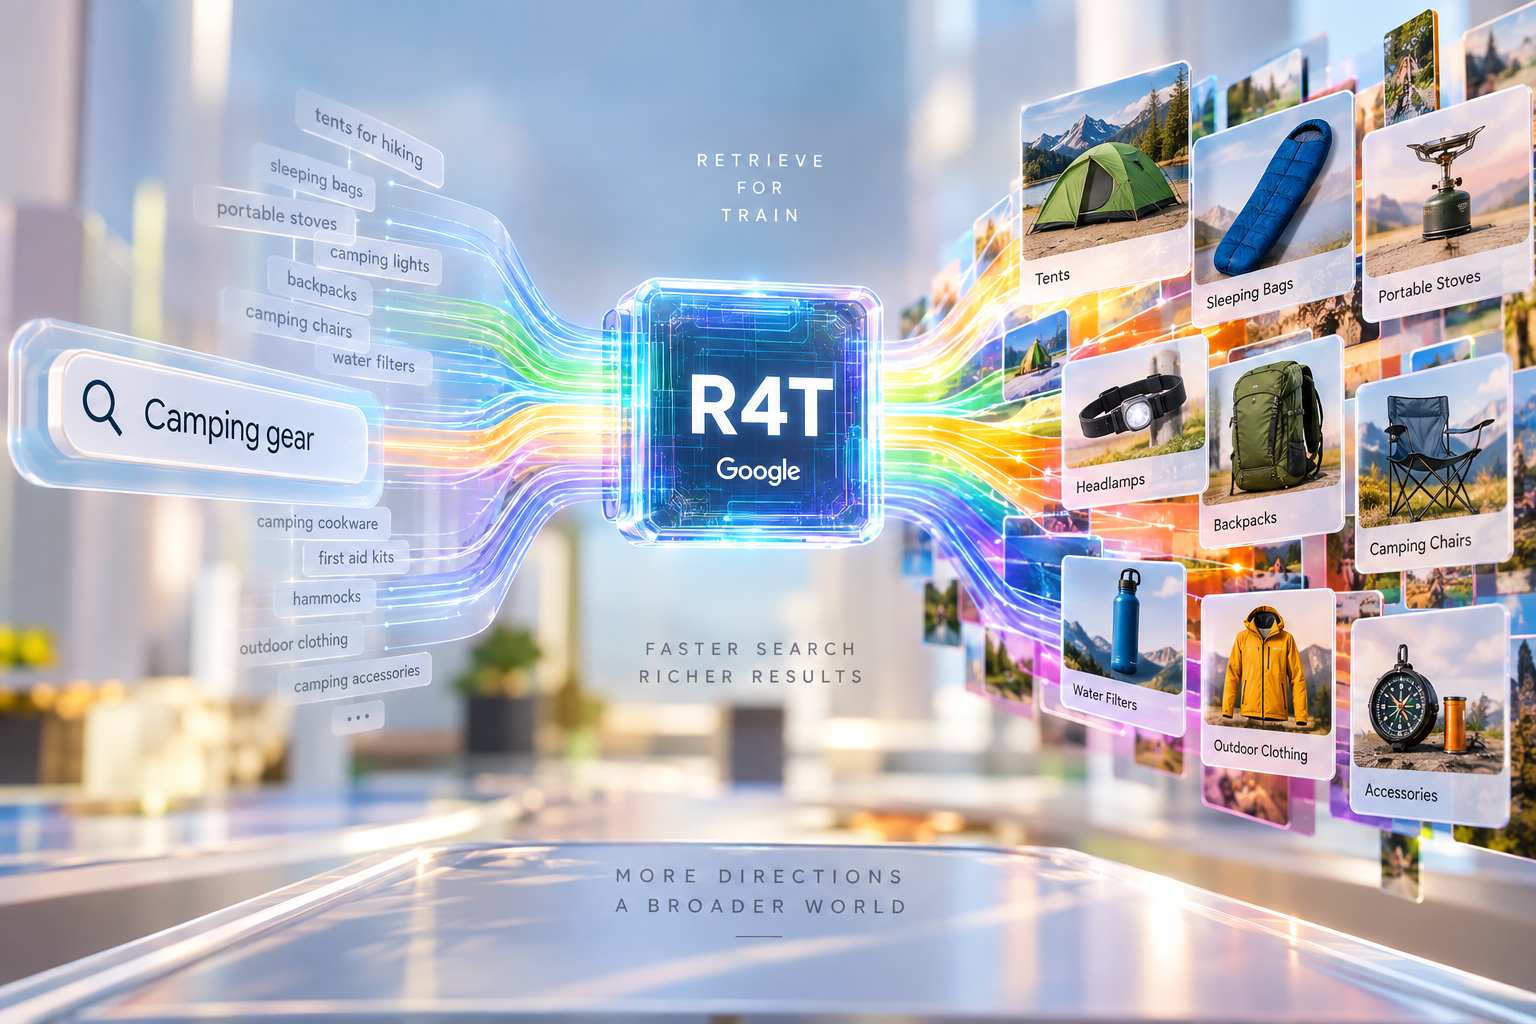
Google ha presentato R4T, acronimo di Retrieve-for-Train, un nuovo framework progettato per ridurre il tempo di inferenza e il costo computazionale delle ricerche AI complesse, intervenendo non durante la fase di ricerca in tempo reale ma a monte, nel processo di addestramento. Nei sistemi di ricerca e raccomandazione più avanzati, infatti, una singola richiesta non deve necessariamente produrre un solo risultato molto simile alla query iniziale, ma spesso deve generare un insieme di risultati complementari tra loro; una ricerca relativa all’attrezzatura da campeggio, per esempio, dovrebbe restituire non soltanto tende differenti, ma anche sacchi a pelo, fornelli portatili, lampade frontali e altri elementi correlati. Per ottenere questo tipo di copertura viene utilizzata una tecnica di query fan-out, nella quale la richiesta originale viene scomposta in più direzioni di ricerca, ma quando il processo viene affidato direttamente a un LLM in tempo reale possono emergere due problemi principali: il modello può produrre ripetutamente query semanticamente molto simili, fenomeno indicato come paraphrastic collapse, e deve inoltre generare in sequenza lunghe catene di ragionamento e numerosi token prima di individuare direzioni di ricerca sufficientemente diverse.
R4T cerca di risolvere entrambi i problemi trasferendo il lavoro di esplorazione e ottimizzazione alla fase di training. In una prima fase vengono utilizzati modelli open source da circa 4 miliardi di parametri, tra cui Gemma 3-4B e Qwen3-4B, che vengono addestrati tramite reinforcement learning affinché imparino a produrre sub-query diverse tra loro ma al tempo stesso coerenti con le caratteristiche del database da interrogare. La valutazione non considera soltanto la bontà di ogni singolo risultato, ma la qualità complessiva dell’insieme generato, utilizzando come segnali di ricompensa la groundedness rispetto al database, la diversità tra i risultati e il livello di allineamento con la query originale. In questo modo il modello impara una strategia di fan-out specifica per il retrieval, cercando di coprire più direzioni informative senza ricadere continuamente in riformulazioni equivalenti dello stesso concetto.
Una volta appresa questa strategia, il modello addestrato con reinforcement learning viene utilizzato offline per generare grandi quantità di query e relativi insiemi di risultati target, creando automaticamente dati destinati a una seconda fase di supervised learning senza richiedere una successiva annotazione manuale. La strategia appresa viene quindi distillata in un modello di diffusione molto più piccolo, composto da circa 53,9 milioni di parametri, che rappresenta il componente utilizzato effettivamente durante la ricerca. La differenza architetturale rispetto agli approcci autoregressivi è sostanziale: invece di produrre una sub-query testuale alla volta e costruire progressivamente lunghe sequenze di reasoning, il modello di diffusione parte dall’embedding della query iniziale e genera direttamente, in parallelo, un insieme di embedding corrispondenti a differenti direzioni di ricerca, che vengono poi associati agli elementi effettivamente presenti nel database.
Questo funzionamento non autoregressivo consente di ridurre drasticamente la latenza durante l’inferenza, perché il sistema non deve più produrre centinaia di token di chain-of-thought ogni volta che riceve una nuova richiesta. Nei test riportati dai ricercatori, con una batch size pari a 8 il query fan-out autoregressivo ha richiesto 1,46 secondi, mentre il modello di diffusione ha completato l’operazione in 0,07 secondi; aumentando la batch size a 1.024, il tempo dell’approccio autoregressivo è cresciuto fino a circa 50 secondi, mentre R4T ha richiesto 4,21 secondi. Sulla base di queste misurazioni, il framework ha ottenuto complessivamente un aumento della velocità compreso tra 12 e 20 volte rispetto ai sistemi autoregressivi utilizzati come confronto.
Il guadagno di velocità non è stato ottenuto sacrificando in modo sostanziale la qualità del retrieval. Nei test condotti su un dataset dedicato alla moda, il modello R4T addestrato con reinforcement learning ha ottenuto risultati superiori rispetto agli approcci zero-shot e Best-of-N sia per diversità sia per allineamento dei risultati, e una parte consistente di queste prestazioni è stata mantenuta anche dopo la distillazione nel più piccolo modello di diffusione. Risultati positivi sono stati osservati anche su un dataset dedicato alle playlist musicali, dove il framework ha prodotto insiemi di risultati con una qualità superiore rispetto alle strategie di ricerca utilizzate come riferimento.
L’elemento centrale di R4T è quindi la separazione tra la fase in cui viene appresa una strategia di ricerca complessa e quella in cui tale strategia viene applicata operativamente. Il reinforcement learning più costoso viene eseguito offline una volta per insegnare al modello come produrre direzioni di ricerca diverse e utili, mentre in produzione questa conoscenza viene affidata a un modello di diffusione leggero che lavora direttamente nello spazio degli embedding e genera più direzioni in parallelo. Google propone così un approccio nel quale la complessità del reasoning non viene eliminata, ma anticipata e condensata durante il training, con l’obiettivo di rendere più rapide le applicazioni di ricerca e raccomandazione che devono gestire richieste articolate e produrre insiemi di risultati eterogenei in tempo reale.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)