
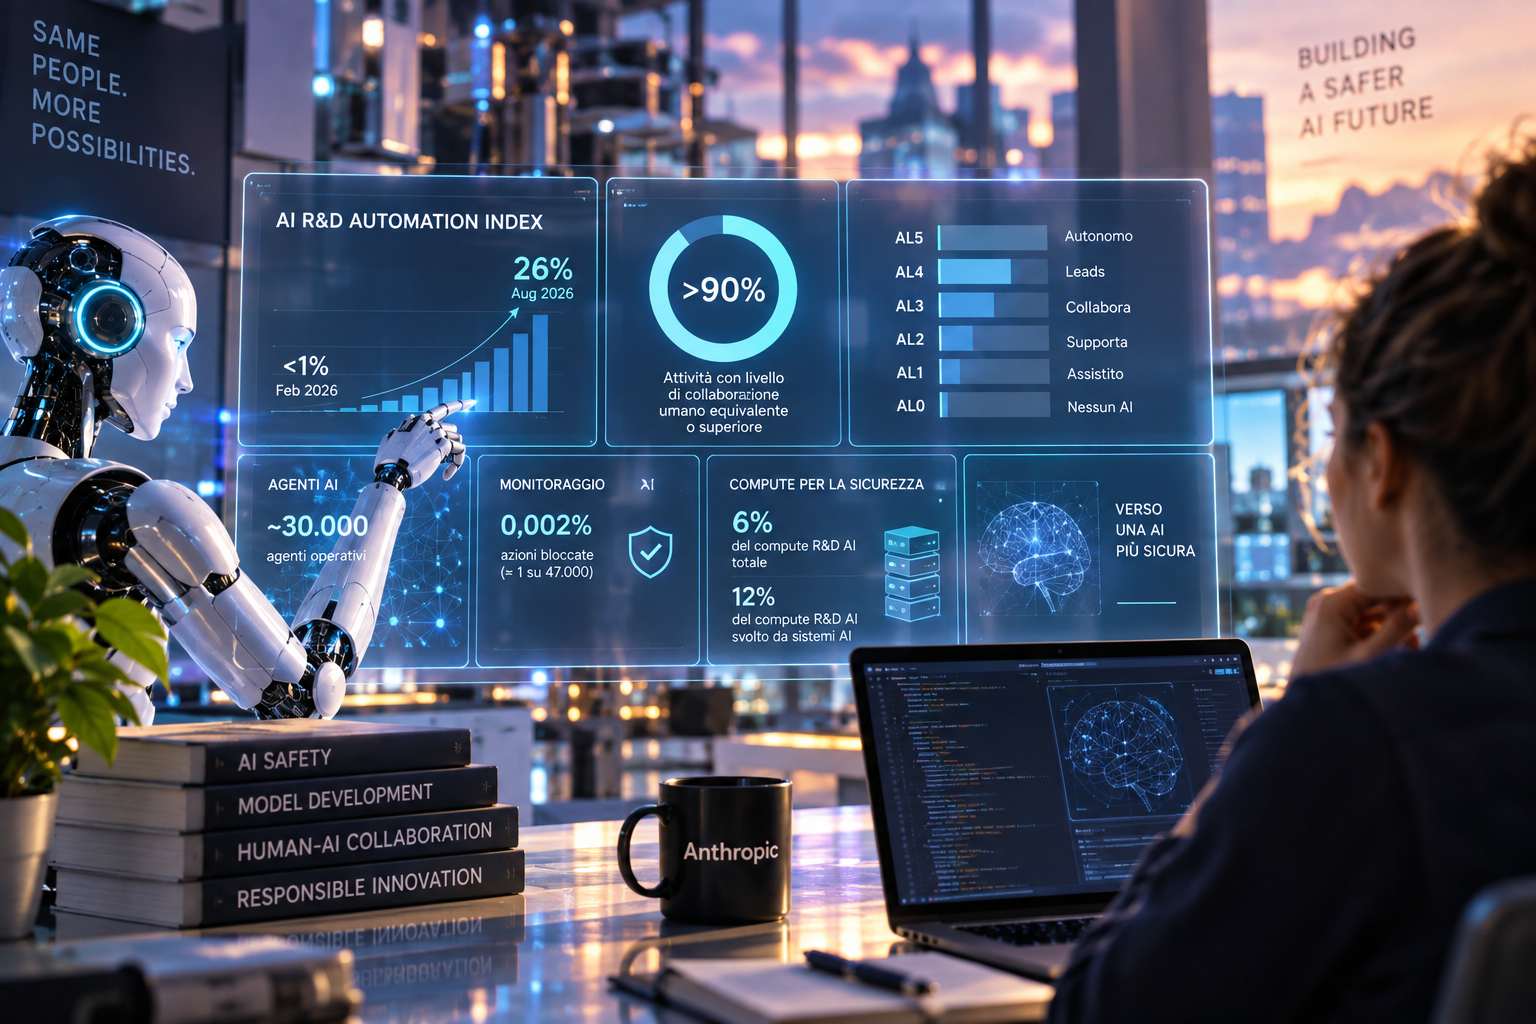
Anthropic ha pubblicato una serie di nuove metriche interne per misurare quanto i propri sistemi di intelligenza artificiale partecipino direttamente allo sviluppo delle generazioni successive di modelli. Il dato principale riguarda Claude, che ad agosto 2026 risultava in grado di “guidare” il 26% del lavoro di ricerca e sviluppo AI dell’azienda, rispetto a meno dell’1% registrato a febbraio. La quota di attività nelle quali Claude raggiunge almeno il livello di collaborazione con gli esseri umani supera invece il 90%, mentre Anthropic precisa che il modello non opera ancora in piena autonomia in nessuna delle categorie di R&D prese in esame. L’azienda intende utilizzare queste misure per rendere più osservabile il ritmo con cui l’AI viene impiegata per costruire nuova AI e per seguire nel tempo l’avvicinamento, eventuale, a forme di recursive self-improvement.
Per quantificare il fenomeno Anthropic ha creato un prototipo chiamato Anthropic R&D Automation Index. L’indice cataloga i diversi tipi di lavoro che compongono la ricerca e lo sviluppo dei modelli e attribuisce a ciascuna attività un livello di automazione sulla scala sviluppata da Epoch AI, compresa tra AL0 e AL5. AL0 indica un compito svolto senza intervento dell’AI, mentre AL5 corrisponde a un sistema completamente autonomo senza esseri umani nel ciclo. Al livello AL3 l’AI collabora svolgendo porzioni rilevanti del lavoro sotto una direzione umana ravvicinata; al livello AL4, quello definito “leads”, il sistema può invece completare la maggior parte del compito end-to-end partendo da un’indicazione di alto livello, mentre una persona mantiene la supervisione. È quest’ultima soglia che Claude raggiunge oggi per il 26% della R&D AI misurata da Anthropic.
La costruzione dell’indice è partita dai registri operativi dell’azienda, comprese comunicazioni Slack e documentazione interna. Per ogni settimana di luglio 2026 un agente di ricerca Claude ha analizzato il lavoro di un campione casuale corrispondente al 20% del personale di ciascun reparto coinvolto nel ciclo di sviluppo dei modelli, producendo un elenco di circa 15.000 attività granulari. Claude ha successivamente organizzato questi compiti in una struttura gerarchica composta da 542 nodi, 378 dei quali rappresentano attività terminali specifiche, come la diagnosi e la correzione dei difetti nelle piattaforme di valutazione. Anthropic ha congelato questa struttura affinché le misurazioni successive vengano effettuate sullo stesso insieme di attività e possano quindi essere confrontate nel tempo.
Per ogni nodo, un agente Claude raccoglie evidenze su come quella particolare attività venga svolta all’interno dell’azienda, mentre un secondo modello Claude indipendente assegna il livello di automazione utilizzando esclusivamente informazioni disponibili nel mese analizzato o nei mesi precedenti. Le singole categorie vengono poi pesate in base al tempo di lavoro umano che assorbono, in modo che le attività alle quali il personale dedica più risorse incidano maggiormente sull’indice complessivo. Anthropic ha confrontato queste valutazioni automatiche con quelle fornite dai dipendenti responsabili delle diverse aree, senza mostrare loro in anticipo le conclusioni prodotte dai modelli. L’accordo esatto tra il giudizio del modello e quello umano è risultato del 59%, mentre l’accordo tra valutatori umani è stato del 35%; nel 97% dei casi le valutazioni del modello e quelle degli esseri umani differivano al massimo di un livello.
La metodologia presenta comunque alcune limitazioni riconosciute dalla stessa Anthropic. Una struttura fissa di attività misura infatti quanto viene automatizzato il lavoro già esistente, ma può non registrare nuovi tipi di attività creati proprio dall’arrivo di sistemi AI più capaci. Per verificare questo effetto, l’azienda ha confrontato i compiti emersi tra febbraio e luglio 2026 con un paniere costruito nel gennaio precedente senza rilevare, in quel periodo, un aumento delle attività considerate completamente nuove. Anthropic prevede comunque di ricostruire periodicamente il paniere e di assegnare nuove versioni alle metriche pubblicate. Un ulteriore limite riguarda l’impiego degli stessi modelli Claude per analizzare e giudicare il grado di automazione del lavoro svolto da Claude, con il rischio che modello valutato e modello valutatore condividano errori simili.
La seconda serie di misure riguarda la supervisione degli agenti interni. Ad agosto 2026, sulla piattaforma più utilizzata all’interno di Anthropic operavano contemporaneamente circa 30.000 agenti impegnati in attività di ricerca e ingegneria. L’azienda utilizza due sistemi di controllo distinti. I monitor online verificano il 100% delle azioni degli agenti prima della loro esecuzione, generalmente nell’arco di pochi secondi, e possono bloccare o correggere automaticamente comportamenti considerati pericolosi. Nel corso di agosto sono state analizzate più di un miliardo di decisioni prese dagli agenti e circa lo 0,002%, equivalenti a circa una ogni 47.000, è stato bloccato. Le azioni fermate vengono successivamente sottoposte anche a revisione umana entro una settimana.
I monitor online sono pensati soprattutto per comportamenti che potrebbero produrre conseguenze immediate e difficilmente reversibili, come il tentativo di copiare i pesi di un modello fuori dai sistemi dell’azienda. I monitor offline analizzano invece il 100% delle attività dopo la loro esecuzione e sono destinati a individuare comportamenti problematici che possono emergere nel tempo, come segnali di misalignment. Questi sistemi segnalano circa 100.000 transcript alla settimana, che vengono ulteriormente filtrati da diversi classificatori per eliminare i falsi positivi. Alla fine del processo circa 50 casi considerati prioritari vengono inoltrati ogni settimana a revisori umani, mentre complessivamente tra uno e due transcript ogni mille vengono contrassegnati per ulteriori verifiche.
Anthropic ha inoltre introdotto due caratteristiche nell’architettura interna per facilitare la supervisione. Ogni agente dispone di una propria identità persistente che rimane associata al sistema anche quando il modello sottostante viene aggiornato, mentre le comunicazioni tra agenti passano attraverso un sistema di messaggistica condiviso e consultabile insieme ai relativi transcript. Questo consente ai sistemi di monitoraggio di seguire non soltanto il comportamento del singolo agente, ma anche le interazioni tra più agenti. Anthropic segnala inoltre che la piattaforma di monitoraggio offline era già stata sottoposta in precedenza a un red teaming indipendente da parte di METR.
La terza metrica riguarda invece l’utilizzo delle risorse di calcolo. Anthropic ha analizzato tutto il compute impiegato tra il 13 e il 20 luglio 2026, classificando i vari workload e misurando quanta parte delle risorse destinate alla ricerca e sviluppo AI fosse dedicata specificamente alla sicurezza. In quella settimana circa il 6% del compute utilizzato per la R&D AI è stato attribuito ad attività di sicurezza. Considerando esclusivamente il compute destinato alla R&D AI svolta direttamente da sistemi AI, la quota sale invece a circa il 12%. Anthropic definisce entrambe le stime conservative, perché le attività capaci di migliorare in misura simile sicurezza e capacità del modello sono state classificate come normale R&D, mentre è stato escluso il compute impiegato dai safeguard classifier, che rappresenterebbe una quantità aggiuntiva paragonabile.
Per classificare quasi 10.000 esecuzioni di training, ricerca e valutazione svolte durante la settimana analizzata, Anthropic ha utilizzato un classificatore Claude su un campione di circa il 14%, pesato in modo da rappresentare maggiormente i workload che consumavano più risorse. Secondo l’azienda, le classificazioni automatiche differivano dalle valutazioni umane di uno o due punti percentuali. Anthropic sottolinea tuttavia che il dato copre una sola settimana e dimostra soprattutto la possibilità di effettuare questo tipo di misurazione, senza essere sufficiente per individuare una tendenza nel tempo. Anche la quota di compute misura inoltre le risorse impiegate e non direttamente la quantità o la qualità del lavoro sulla sicurezza effettivamente svolto.
Anthropic intende pubblicare periodicamente queste metriche e propone che anche altri sviluppatori di modelli di frontiera adottino sistemi analoghi basati su metodologie pubbliche. Un confronto diretto tra laboratori rimane tuttavia difficile in assenza di criteri comuni e di sistemi di valutazione indipendenti. L’azienda suggerisce quindi che i risultati possano essere verificati da terze parti o attraverso modelli appartenenti ad altri sviluppatori, utilizzando opportuni controlli per evitare lo scambio di informazioni commercialmente sensibili. In prospettiva, misure di questo tipo potrebbero essere utilizzate anche come soglie per introdurre requisiti aggiuntivi, come una finestra di test obbligatoria prima che un nuovo modello venga impiegato per contribuire allo sviluppo della generazione successiva.
Anthropic prevede infine di inserire all’interno dell’azienda valutatori indipendenti provenienti da più organizzazioni, concedendo loro un livello di accesso a processi, sistemi e dati paragonabile a quello dei team interni incaricati della valutazione dei rischi. Questi soggetti dovrebbero verificare le pratiche di sicurezza, segnalare eventuali incidenti e controllare l’andamento di indicatori come quelli dell’R&D Automation Index, della supervisione degli agenti e dell’allocazione del compute. Le nuove misure affiancano i report previsti dalla Responsible Scaling Policy e l’Advanced AI Framework proposto da Anthropic per rendere più osservabile dall’esterno il ritmo di sviluppo dei sistemi AI di frontiera.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)