
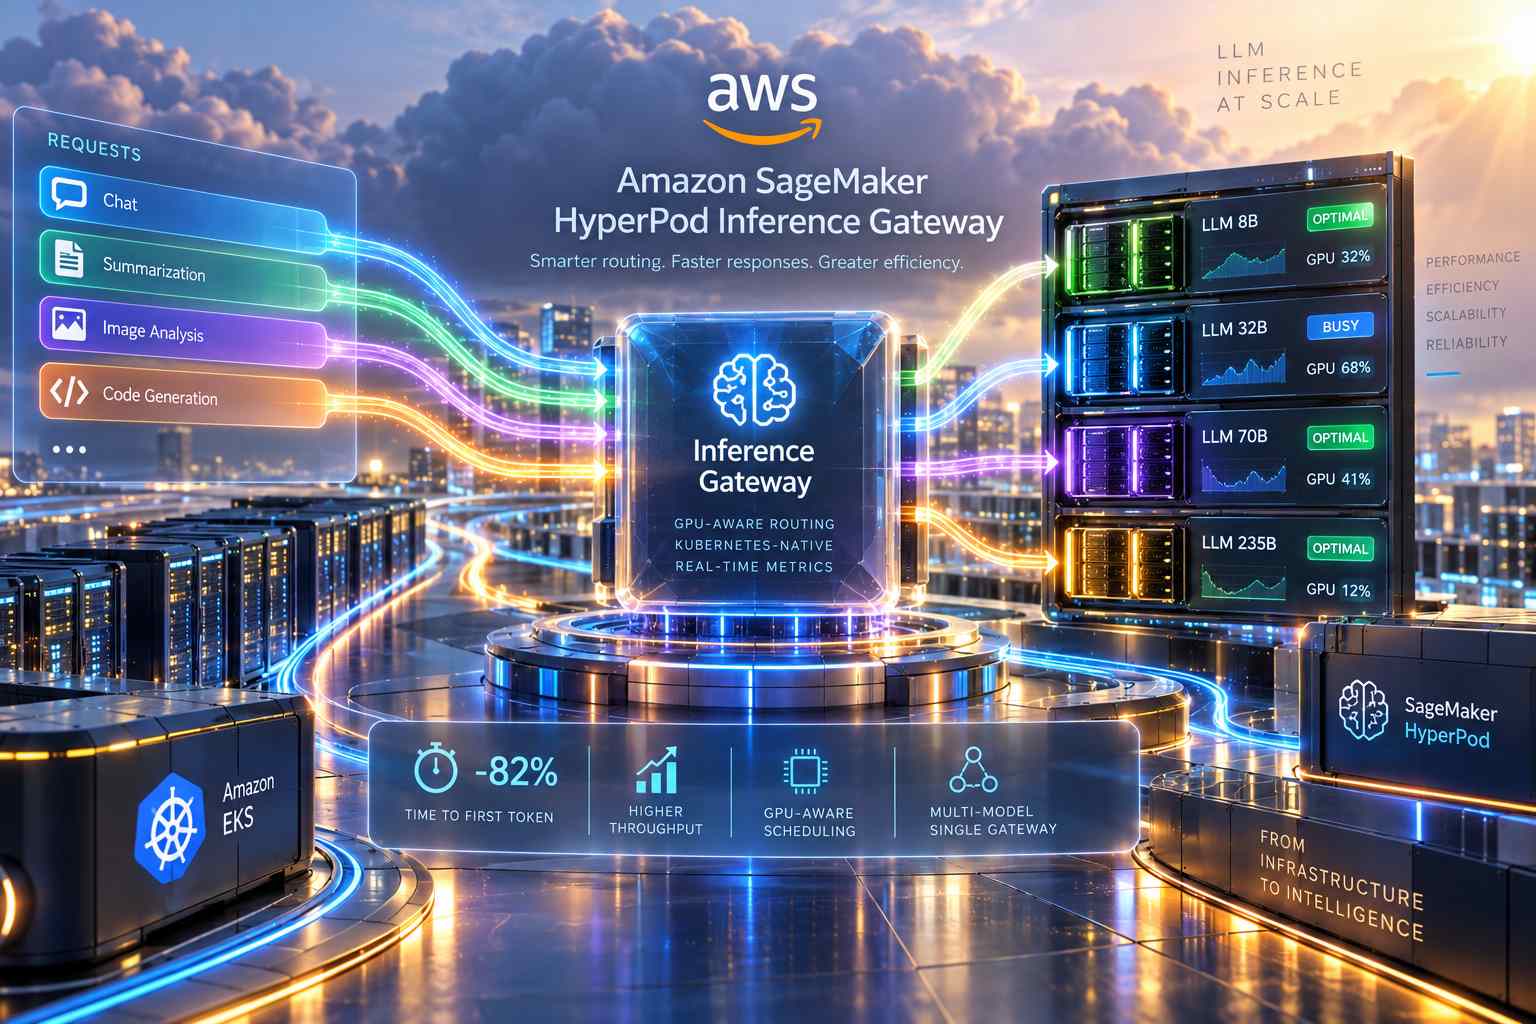
AWS ha introdotto Amazon SageMaker HyperPod Inference Gateway, un sistema di routing Kubernetes-native progettato per distribuire le richieste di inferenza dei grandi modelli linguistici in base allo stato effettivo delle GPU. Il gateway viene distribuito come add-on gestito di Amazon EKS sull’infrastruttura SageMaker HyperPod esistente e utilizza segnali raccolti in tempo reale dai pod che eseguono i modelli per decidere dove inoltrare ogni richiesta. L’obiettivo è superare i limiti dei normali algoritmi Kubernetes, come round-robin e least-connections, che non tengono conto di parametri come saturazione della KV cache, richieste di generazione già in corso, profondità delle code o presenza in memoria di specifici adattatori LoRA. Secondo AWS, questa gestione può ridurre fino all’82% il tempo necessario per produrre il primo token rispetto a configurazioni meno consapevoli dello stato delle GPU.
Con un bilanciamento tradizionale, una richiesta può essere inviata a un pod già sovraccarico mentre un’altra GPU rimane sottoutilizzata. Questo comportamento diventa particolarmente evidente nei carichi LLM, nei quali due pod apparentemente equivalenti possono trovarsi in condizioni molto diverse a causa della lunghezza dei contesti, dello stato delle cache o delle generazioni già attive. AWS indica che durante i picchi di traffico questo può portare il time-to-first-token oltre i quattro secondi e spingere gli operatori a sovradimensionare l’infrastruttura per compensare l’imprevedibilità del carico. In uno degli scenari riportati dall’azienda, un’attesa di circa 4,4 secondi per il primo token viene ridotta a meno di 800 millisecondi utilizzando il nuovo gateway.
L’architettura è organizzata su due livelli. Il primo, già disponibile, opera all’interno del singolo cluster HyperPod o EKS attraverso l’add-on amazon-sagemaker-hyperpod-inference e si basa su componenti costruiti attorno alla Kubernetes Gateway API e alla relativa Inference Extension. Envoy Gateway funziona come proxy Layer 7, termina il traffico HTTPS in ingresso ed espone un endpoint privato per il cluster. Il Body-Based Router analizza invece il corpo delle richieste compatibili con l’API OpenAI, legge il campo model e indirizza il traffico verso il pool corrispondente, permettendo a un unico gateway di servire contemporaneamente più modelli. Nella documentazione AWS il router può inoltre risolvere il nome di un adattatore LoRA nel relativo modello di base e aggiungere intestazioni utilizzate successivamente dalle regole HTTPRoute.
La selezione finale del pod viene effettuata dall’Endpoint Picker, indicato anche come EPP o scheduler, che utilizza metriche Prometheus raccolte dai server di inferenza. Il sistema assegna un punteggio ai possibili endpoint considerando parametri quali utilizzo della KV cache, profondità della coda, numero di richieste in esecuzione, probabilità di un prefix cache hit e presenza in memoria dell’adattatore LoRA richiesto. I singoli criteri possono essere pesati in modo differente, così da privilegiare per esempio la latenza nei servizi conversazionali oppure il throughput nei carichi batch. Ogni modello può avere il proprio scheduler definito all’interno della risorsa personalizzata InferenceGatewayConfig.
Il gateway si integra con HyperPod Inference Operator senza sostituirlo. L’operator continua a occuparsi della distribuzione dei modelli, della creazione dei Deployment e dei Service Kubernetes, del bilanciamento tramite Application Load Balancer, dell’autoscaling KEDA, dei certificati e della registrazione degli endpoint SageMaker AI. Il gateway interviene invece nel percorso delle richieste e genera le risorse necessarie al routing, tra cui InferencePool, Endpoint Picker, HTTPRoute ed EnvoyExtensionPolicy. Per associare un modello al gateway è possibile abilitare il campo spec.inferenceGateway.enabled all’interno della relativa configurazione; più modelli nello stesso namespace possono condividere il medesimo gateway. La nuova funzionalità è inclusa nella release HyperPod Inference Amazon EKS v2.0.0-eksbuild.2 insieme all’Inference Operator v3.6.
Particolare attenzione è dedicata ai modelli che condividono una base comune con diversi adattatori LoRA. Il LoRA Affinity Scorer dell’Endpoint Picker verifica quali pod possiedono già in memoria GPU l’adattatore richiesto e indirizza preferenzialmente la richiesta verso uno di questi endpoint. In questo modo viene evitato il tempo necessario a rimuovere un adattatore e caricarne un altro. Se nessun pod dispone già dell’adattatore richiesto, il gateway seleziona invece quello con maggiore capacità disponibile per effettuare il caricamento.
La distribuzione è stata progettata per richiedere modifiche limitate alle applicazioni esistenti. Il gateway può essere installato tramite il normale ciclo di vita degli add-on EKS e viene configurato con una risorsa InferenceGatewayConfig, mentre le distribuzioni dei model server esistenti vengono individuate attraverso le label dei pod. AWS indica che non sono necessari sidecar, service mesh o modifiche al codice delle applicazioni client. L’endpoint utilizza un’interfaccia compatibile con OpenAI su HTTP e può quindi essere utilizzato da client esistenti senza introdurre un nuovo SDK. La documentazione segnala tuttavia che gli endpoint non applicano autenticazione o autorizzazione a livello di richiesta per impostazione predefinita: se non viene configurata l’autenticazione JWT, l’accesso dipende esclusivamente dai controlli di rete e dalla VPC, motivo per cui AWS raccomanda di attivare JWT sui gateway.
Il sistema comprende anche comportamenti specifici per la gestione dei guasti. Se un pod smette di aggiornare le proprie metriche, l’Endpoint Picker lo esclude temporaneamente dalla selezione e continua a utilizzare i pod considerati sani, reintegrandolo automaticamente quando le metriche tornano disponibili. Se un intero pool esaurisce la capacità, il gateway restituisce una risposta HTTP 429 con header Retry-After mentre l’autoscaling aggiunge nuove risorse. AWS prevede inoltre un secondo livello architetturale, denominato Global Inference Router, che consentirà di coordinare più cluster e più regioni. In questa configurazione, un cluster non più raggiungibile potrà essere rilevato attraverso un heartbeat non aggiornato e il traffico potrà essere reindirizzato entro circa 35 secondi; in caso di indisponibilità regionale entrerà invece in funzione il routing cross-region, con un aumento della latenza ma senza interruzione prevista della disponibilità.
L’osservabilità viene gestita a diversi livelli. I singoli pod espongono attraverso Prometheus dati quali utilizzo della KV cache, profondità delle code, richieste in esecuzione e residenza degli adattatori. A livello di pool vengono raccolti numero delle richieste, distribuzione delle durate e conteggio dei token, utilizzabili anche con Grafana. Amazon CloudWatch può invece monitorare indicatori aggregati per cluster, come utilizzo medio della KV cache, tasso di errore e latenza P99, mentre il futuro livello globale registrerà decisioni di routing, eventi di failover e interventi dei meccanismi di rate limiting.
AWS ha valutato il gateway su quattro modelli compresi tra 8 e 235 miliardi di parametri, utilizzando istanze p5.48xlarge con GPU NVIDIA H100 e istanze g5 con GPU A10G. Il traffico dei test è stato instradato attraverso Application Load Balancer interni, replicando il percorso previsto per una richiesta in produzione, con nodi client dedicati alla generazione del carico e model server collocati su un gruppo di nodi separato. Tutti i confronti sono stati effettuati utilizzando la configurazione di routing predefinita del gateway e come riferimento un bilanciamento round-robin Kubernetes eseguito sulle stesse repliche dei modelli.
Nei test con una flotta composta da differenti generazioni di GPU, Llama 3.1 8B ha registrato una riduzione del 97% sia della latenza P95 sia della P99 del time-to-first-token e un aumento dell’8% del throughput. Qwen3 32B ha ottenuto riduzioni rispettivamente del 98% e del 97%, con un incremento del throughput del 50%. In presenza di traffico a raffiche, Llama 3.1 70B ha mostrato una diminuzione del 94% della latenza P95 e del 98% della P99, insieme a un throughput superiore del 12%. Per Qwen3 235B il valore P95 è rimasto sostanzialmente comparabile al round-robin, mentre la latenza P99 è risultata inferiore dell’89%. Nei workload con prefissi condivisi, Llama 3.1 8B ha invece registrato riduzioni del 26% al P95 e del 43% al P99.
AWS precisa che su una flotta completamente uniforme e sottoposta a traffico stabile il nuovo gateway offre prestazioni sostanzialmente equivalenti al round-robin. I vantaggi diventano quindi maggiori soprattutto negli scenari in cui lo stato dei singoli pod diverge: hardware eterogeneo, richieste improvvise, contesti di lunghezza variabile e prompt che condividono prefissi già presenti nella cache. Il gateway rimane compatibile con server di inferenza che espongono API in formato OpenAI, inclusi vLLM, SGLang e TGI; la documentazione AWS richiede almeno vLLM 0.9.2 o SGLang 0.3.5.post1 per le configurazioni indicate. La gestione può essere integrata nei normali workflow Kubernetes tramite kubectl, Helm, GitOps e Argo CD.
Il primo livello di routing per cluster è disponibile dal 18 settembre 2026 nelle regioni nelle quali viene distribuito il relativo add-on HyperPod Inference. Il secondo livello Global Inference Router è invece ancora previsto per una fase successiva e dovrebbe introdurre coordinamento tra cluster e regioni, failover, rate limiting globale e distribuzione del traffico sensibile ai costi. Tra le funzionalità indicate nella roadmap figurano inoltre il canary traffic splitting, per inviare una percentuale del traffico verso nuove versioni dei modelli attraverso risorse InferenceModelRewrite, e un meccanismo di flow control capace di classificare le richieste come Critical, Standard o Sheddable e applicare differenti politiche di ammissione per ciascuna categoria.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)