
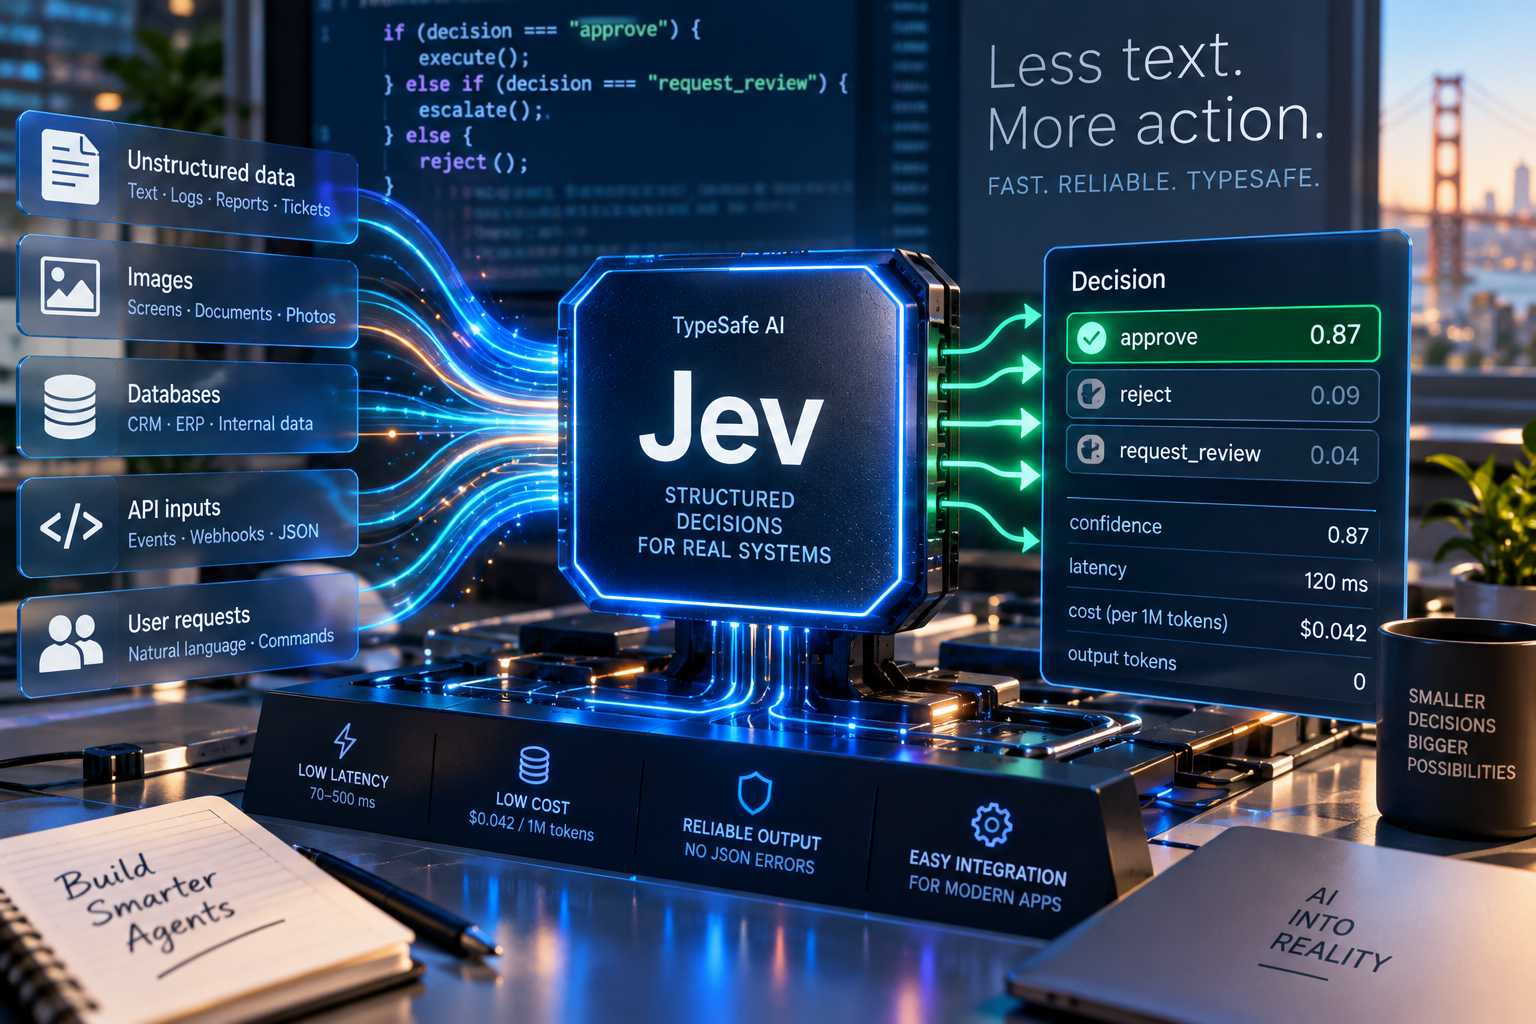
TypeSafe AI ha presentato Jev, un modello di intelligenza artificiale progettato non per generare testo, ma per produrre decisioni strutturate direttamente utilizzabili all’interno di applicazioni software e sistemi backend. La società è guidata da Diogo Almeida, ricercatore che in precedenza aveva lavorato allo sviluppo di ChatGPT, e il modello è stato presentato il 15 settembre 2026 attirando rapidamente l’attenzione della comunità degli sviluppatori. Dopo il lancio, Jev è salito ai primi posti delle discussioni su Hacker News, raccogliendo centinaia di commenti e voti, mentre il post di presentazione pubblicato da Almeida su X ha superato 37 milioni di visualizzazioni e generato migliaia di citazioni.
L’obiettivo del modello è intervenire su una categoria di operazioni per le quali l’utilizzo di un grande modello linguistico tradizionale può risultare sovradimensionato. Attività come la classificazione di dati, la valutazione di un livello di rischio, la selezione dell’azione successiva di un agente o il routing di una richiesta richiedono spesso una decisione tra opzioni già definite, non la produzione di una risposta in linguaggio naturale. Con gli LLM convenzionali, anche una decisione di questo tipo passa normalmente attraverso la generazione token per token di una sequenza testuale, che deve poi essere interpretata dal software. Questo introduce latenza, costi computazionali e la possibilità che il modello non rispetti il formato richiesto, produca JSON non valido o generi nomi di funzioni e metodi inesistenti, provocando errori a runtime nei sistemi che utilizzano l’output.
Jev elimina completamente questo passaggio di generazione. Il sistema riceve dati non strutturati insieme a una domanda o a un insieme di opzioni precedentemente definite e restituisce in un singolo passaggio una scelta, una distribuzione di probabilità e un punteggio di confidenza, senza attraversare un decoder incaricato di produrre una sequenza di parole. L’architettura consente di ottenere tempi di risposta compresi indicativamente tra 70 e 500 millisecondi, quindi sensibilmente inferiori a quelli richiesti da una normale chiamata a un LLM generativo. Il prezzo indicato per l’elaborazione degli input è di circa 0,042 dollari per un milione di token e non è previsto un costo associato ai token di output, dal momento che il modello non genera testo nel senso tradizionale.
Dal punto di vista dell’integrazione software, Jev funziona quindi come un sistema di decisione tipizzato. Lo sviluppatore stabilisce preventivamente quali valori possono essere restituiti e il modello opera esclusivamente all’interno di quell’insieme. Se, per esempio, un’applicazione prevede soltanto le opzioni approva, rifiuta e richiedi_verifica, Jev non può inventare una quarta azione, produrre una stringa non prevista o modificare arbitrariamente la struttura della risposta. È questa caratteristica ad aver portato diversi sviluppatori a descriverlo come una sorta di “if intelligente”, collocato tra la rigidità delle normali regole deterministiche e la maggiore capacità di interpretazione semantica dei modelli linguistici.
La stessa impostazione rende strutturalmente impossibili alcune forme di errore tipiche dell’utilizzo degli LLM nei backend. Un modello generativo può, per esempio, restituire una proprietà JSON con un nome differente da quello previsto, inserire testo aggiuntivo dove l’applicazione si aspetta esclusivamente un valore strutturato oppure suggerire l’utilizzo di uno strumento che in realtà non esiste. Jev non dispone invece della libertà necessaria per generare questi output, perché può restituire soltanto valori appartenenti al tipo dichiarato. La sicurezza del tipo riguarda però esclusivamente la forma della risposta e non garantisce che la decisione presa dal modello sia corretta: Jev può comunque selezionare l’opzione sbagliata o assegnare una probabilità non adeguata. Per questo motivo, nelle applicazioni sensibili è necessario utilizzare anche il punteggio di confidenza restituito dal sistema e definire soglie oltre le quali la decisione viene accettata automaticamente o inoltrata a un altro livello di verifica.
Il modello ha suscitato particolare interesse anche nello sviluppo degli agenti AI, dove una singola attività può richiedere decine o centinaia di decisioni intermedie. Ogni passaggio può riguardare, per esempio, la scelta dello strumento da utilizzare, l’instradamento verso una determinata procedura o la valutazione dello stato corrente dell’esecuzione. Utilizzare un LLM completo in ciascuno di questi punti moltiplica latenza e costi anche quando non è necessaria una vera capacità generativa. Alcuni sviluppatori che hanno sperimentato Jev hanno riferito di avere sostituito centinaia di queste decisioni intermedie, riducendo la latenza complessiva degli agenti da diversi secondi a poche centinaia di millisecondi e abbattendo i costi fino a una frazione dell’esecuzione precedente.
L’interesse prodotto dall’approccio si è esteso rapidamente anche all’ecosistema open source. Nelle 48 ore successive alla presentazione sono comparsi su X e GitHub almeno sei progetti che tentavano di riprodurre il principio di funzionamento di Jev. Le implementazioni mostrate comprendevano modelli abbastanza leggeri da poter essere eseguiti localmente su un MacBook e dimostrazioni dedicate al controllo in tempo reale di videogiochi come Doom e StarCraft, nelle quali lo stato del gioco viene fornito continuamente al modello affinché selezioni le azioni da compiere. In alcune demo il sistema viene interrogato fino a dieci volte al secondo, sfruttando la bassa latenza per trasformare la decisione del modello direttamente in un comando di controllo.
L’approccio rappresentato da Jev suggerisce una separazione più netta tra due funzioni che nei sistemi basati esclusivamente su LLM vengono spesso affidate allo stesso modello. Le decisioni frequenti, rapide e delimitate da un insieme conosciuto di possibilità possono essere eseguite da modelli specializzati e a bassa latenza, mentre i grandi modelli generativi possono essere richiamati soltanto quando sono realmente necessarie capacità più complesse di ragionamento, elaborazione o produzione di contenuti. In un’architettura di questo tipo, attività come routing di grandi quantità di dati, monitoraggio, classificazione e valutazione della confidenza possono essere gestite in pochi millisecondi da un modello decisionale, lasciando a sistemi come ChatGPT o Claude i passaggi nei quali è richiesta la generazione libera o un’elaborazione più articolata.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)