
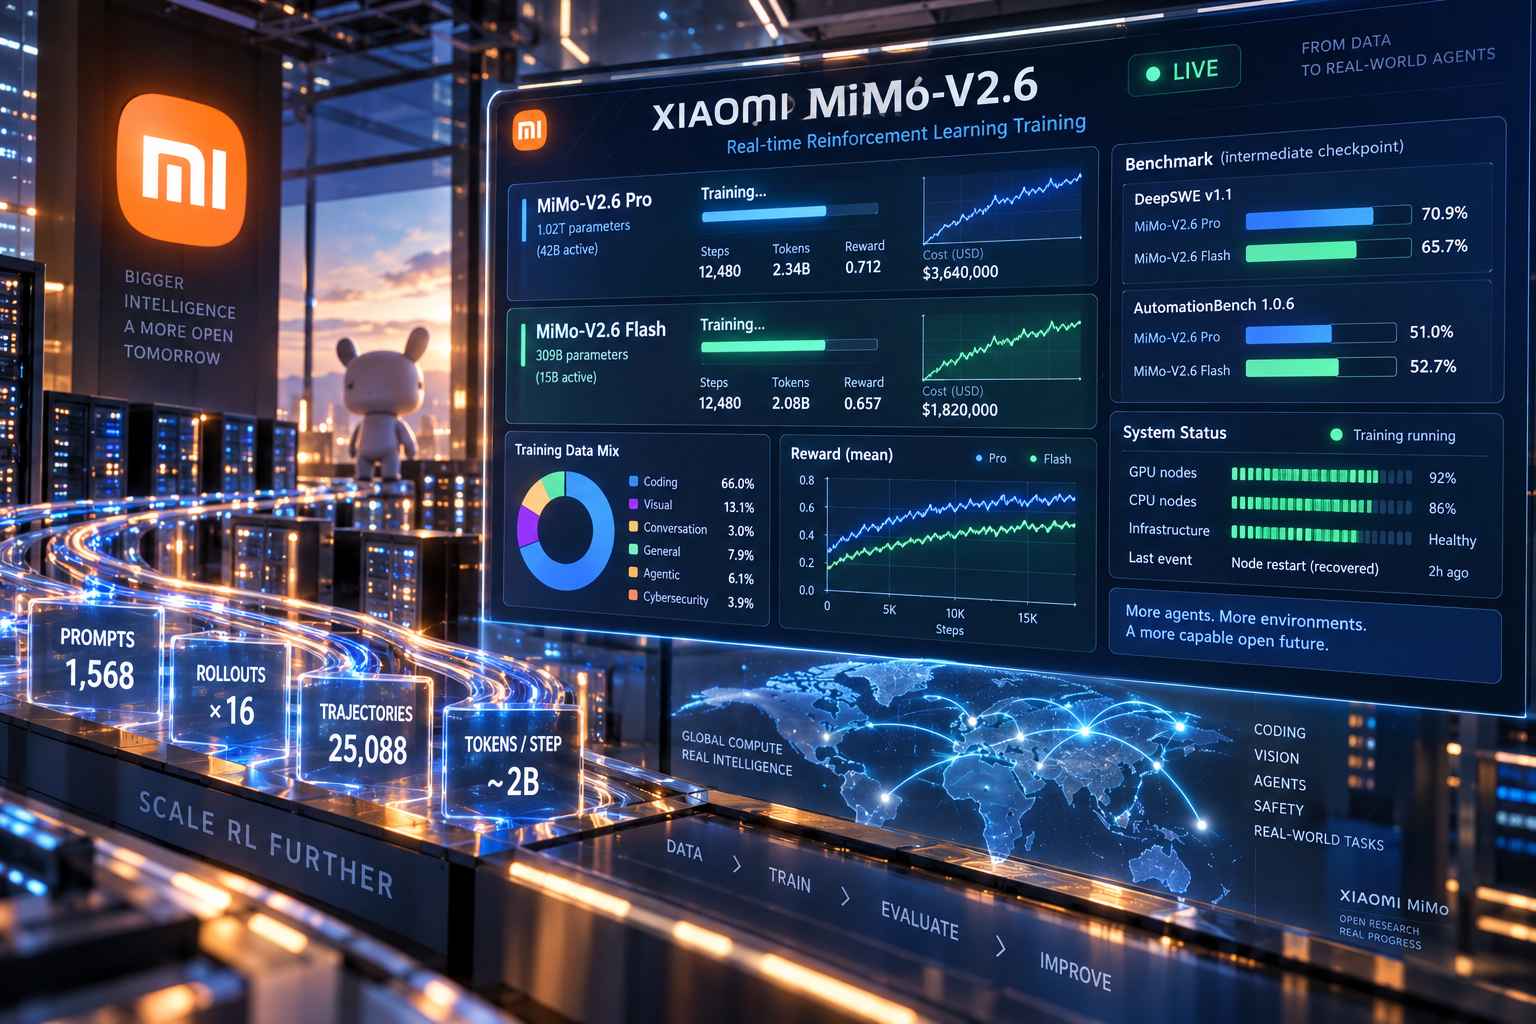
Xiaomi ha reso pubblicamente osservabile in tempo reale la fase di post-training con reinforcement learning di MiMo-V2.6, mostrando attraverso un dashboard l’evoluzione di due varianti ancora in addestramento, MiMo-V2.6 Pro e MiMo-V2.6 Flash. Il progetto è stato avviato dal team Xiaomi MiMo il 15 settembre 2026 e permette di seguire direttamente dati estratti dai log del trainer, invece di limitarsi a risultati selezionati e pubblicati al termine dell’esperimento. La responsabile del team MiMo, Luo Fuli, ha spiegato che il gruppo ha trascorso quasi sei mesi concentrandosi su una domanda precisa: fino a che punto sia possibile aumentare la scala del reinforcement learning. L’esperimento riguarda quindi non soltanto la quantità di calcolo impiegata, ma contemporaneamente la varietà degli ambienti e degli harness utilizzati dagli agenti e la capacità computazionale destinata alla valutazione delle loro traiettorie. I due modelli vengono addestrati attraverso un sistema completamente asincrono e, mentre il processo prosegue, il pubblico può osservare numero di step completati, token elaborati, reward, loss, risultati intermedi sui benchmark, distribuzione dei task, costi e problemi hardware incontrati durante l’esecuzione.
La scala del training è particolarmente elevata. Ogni step parte da 1.568 prompt e genera 16 rollout per ciascuno, equivalenti a 25.088 traiettorie agentiche prima di considerare le differenze nella loro lunghezza. Il volume elaborato è nell’ordine di circa 2 miliardi di token per singolo step, anche se durante alcune fasi il valore osservato sul dashboard è salito oltre 2,3-2,5 miliardi. Un ciclo completo comprendente soluzione dei problemi, funzionamento dei valutatori e aggiornamento dei parametri richiede nell’ordine di circa due ore, con variazioni legate alla complessità delle traiettorie e allo stato dell’infrastruttura. L’architettura asincrona permette di non attendere necessariamente che tutte le traiettorie della stessa generazione abbiano terminato il proprio lavoro prima di proseguire con valutazione e addestramento, aspetto rilevante in un sistema in cui alcuni agenti possono completare rapidamente un task mentre altri devono utilizzare strumenti, eseguire codice e mantenere interazioni molto più lunghe. Il training viene inoltre svolto contemporaneamente su più categorie di attività e più harness, invece di separare completamente la fase di reinforcement learning per ogni singola competenza.
La composizione dei dati mostra una forte concentrazione sullo sviluppo software. Circa due terzi del materiale utilizzato nel reinforcement learning riguarda il coding, mentre i dati visuali rappresentano il 13,1% e quelli di conversazione generale circa il 3%; il resto comprende attività generaliste, agentiche e di cybersecurity. In totale il sistema lavora su molteplici dataset e ambienti con sistemi di valutazione differenti, combinando reward basati su test verificabili con criteri definiti tramite rubriche. Xiaomi utilizza inoltre un meccanismo di agentic in-group credit assignment, attraverso il quale il sistema deve attribuire correttamente il merito alle diverse traiettorie prodotte all’interno dello stesso gruppo di rollout. Questa impostazione è particolarmente importante nei task agentici lunghi, dove il risultato finale dipende da una sequenza di decisioni, uso di strumenti, modifiche intermedie ed eventuali tentativi falliti e non soltanto da una singola risposta testuale. Il numero elevato di rollout per prompt consente inoltre di confrontare strategie differenti applicate allo stesso problema e utilizzare le relative valutazioni come segnale per l’aggiornamento del modello.
Il dashboard rende visibile anche l’andamento delle prestazioni durante l’addestramento. Tra le metriche pubblicate figurano i reward medi delle traiettorie e i risultati ottenuti sui checkpoint intermedi di DeepSWE v1.1, benchmark composto da 113 attività di software engineering di lunga durata. L’obiettivo è osservare se l’aumento del reward ottenuto durante il reinforcement learning corrisponda anche a un miglioramento misurabile nell’esecuzione di compiti esterni al batch utilizzato per l’aggiornamento. Snapshot successivi del training hanno mostrato MiMo-V2.6 Pro arrivare intorno al 70,9% su DeepSWE v1.1 e MiMo-V2.6 Flash intorno al 65,7%, mentre su AutomationBench 1.0.6 i valori osservati sono stati rispettivamente circa 51,0% e 52,7%. Trattandosi di checkpoint prodotti durante un training ancora in corso, questi numeri non rappresentano risultati finali del modello né benchmark ufficiali di una release commerciale, ma servono a seguire l’evoluzione delle capacità mentre i parametri continuano a essere aggiornati. Xiaomi non ha ancora pubblicato i modelli V2.6, i prezzi delle API o una scheda tecnica definitiva della nuova generazione.
L’esperimento permette inoltre di osservare direttamente il costo economico di una fase di reinforcement learning su questa scala. Dopo appena due giorni il contatore aveva già superato 1,13 milioni di dollari e, con il proseguimento del training, la spesa complessiva è salita oltre 3,6 milioni di dollari. MiMo-V2.6 Pro è la variante più costosa: le stime ricavate dal dashboard hanno indicato circa 493.000 dollari di calcolo al giorno e circa 70.000 dollari per singolo step, mentre Flash si colloca intorno a 247.000 dollari al giorno. Le due varianti hanno dimensioni molto differenti: Pro è associato a un’architettura mixture-of-experts con circa 1,02 trilioni di parametri complessivi e 42 miliardi attivi per token, mentre Flash utilizza circa 309 miliardi di parametri complessivi e 15 miliardi attivi. Questa differenza permette di confrontare durante lo stesso esperimento non soltanto le curve di apprendimento, ma anche il rapporto tra quantità di calcolo, costo, dimensione del modello e miglioramento delle prestazioni ottenuto attraverso ulteriori step di reinforcement learning.
La quantità di informazioni esposte non riguarda soltanto i momenti in cui il sistema funziona correttamente. Nel registro pubblico compaiono infatti anche problemi operativi come errori out-of-memory sulla memoria delle GPU, riavvii dei nodi e interruzioni o ripartenze del training. In uno dei casi MiMo-V2.6 Pro ha dovuto essere riavviato dopo un problema di VRAM, evento registrato pubblicamente insieme alle altre metriche. Il dashboard mostra inoltre indicatori come entropy loss e divergenze tra differenti sistemi di valutazione, rendendo osservabili fenomeni che normalmente rimangono all’interno delle infrastrutture dei laboratori. Questo livello di telemetria è significativo perché l’addestramento con reinforcement learning di agenti non dipende soltanto dalla stabilità del modello, ma da un’intera catena composta da generazione delle traiettorie, ambienti, tool, grader, distribuzione dei carichi sulle GPU e aggiornamento dei parametri. Un errore infrastrutturale o un comportamento anomalo del sistema di valutazione può quindi modificare direttamente la qualità del segnale utilizzato per addestrare il modello.
La strategia di Xiaomi differisce dalla normale pubblicazione di un technical report successivo alla conclusione del training perché rende visibile un esperimento mentre il risultato è ancora incerto. Curve dei reward, checkpoint intermedi, composizione del training set e costi di elaborazione sono informazioni generalmente considerate sensibili dai laboratori che sviluppano modelli di frontiera, perché possono fornire indicazioni sulla ricetta utilizzata, sull’efficienza dell’infrastruttura e sui punti nei quali ulteriori investimenti in calcolo producono ancora miglioramenti. In questo caso il processo permette di osservare direttamente anche gli eventuali plateau: se ulteriori step richiedono milioni di dollari ma producono incrementi sempre più piccoli nei reward e nei benchmark, diventa possibile valutare pubblicamente il rendimento marginale del reinforcement learning su modelli già molto grandi. Al contrario, miglioramenti continuativi durante una lunga sequenza di step fornirebbero indicazioni sulla possibilità di spingere ulteriormente questa tecnica nel post-training di sistemi agentici, che è precisamente la questione che il team MiMo dichiara di voler studiare.
Xiaomi ha anticipato che, una volta concluso l’esperimento, pubblicherà progressivamente in open source le principali tecniche e i dettagli metodologici sviluppati durante il reinforcement learning. Al momento il dashboard costituisce quindi soprattutto una finestra sul processo, mentre non sono ancora disponibili una descrizione tecnica completa della ricetta, i pesi finali di MiMo-V2.6 o tutti gli elementi necessari per riprodurre autonomamente il training. Le informazioni già rese visibili permettono però di ricostruire i principali parametri operativi: migliaia di prompt per batch, 16 traiettorie per ciascun problema, miliardi di token per step, più categorie di agenti addestrate contemporaneamente, reward basati sia su test sia su rubriche, elaborazione completamente asincrona e valutazioni continue attraverso benchmark esterni. L’esperimento costituisce quindi anche una dimostrazione concreta della quantità di infrastruttura richiesta per spostare il reinforcement learning dai tradizionali problemi con risposte brevi verso agenti capaci di affrontare attività di coding, cybersecurity, visione e utilizzo di strumenti che possono estendersi per decine di migliaia di token e numerosi passaggi operativi.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)