
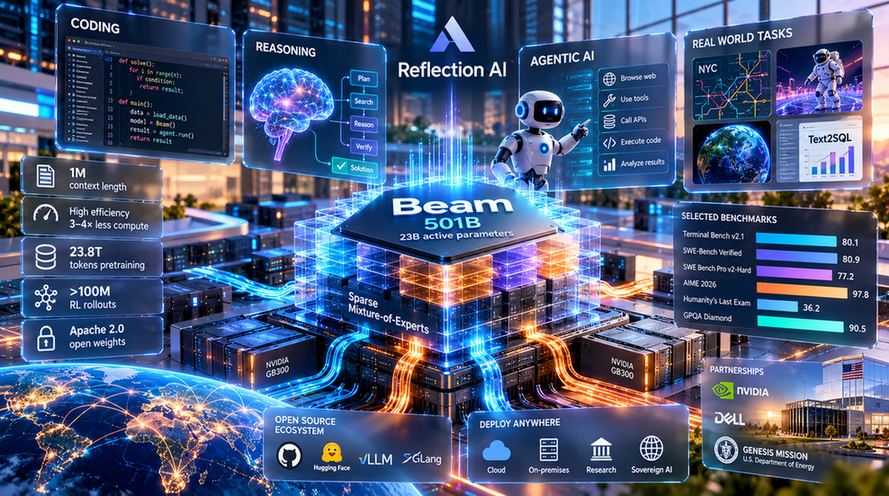
Reflection AI ha presentato Beam, il suo primo modello open-weight, costruito con un’architettura sparse Mixture-of-Experts da 501 miliardi di parametri complessivi, dei quali 23 miliardi vengono attivati durante l’inferenza. Il modello è stato sviluppato con un’attenzione particolare al coding, al reasoning e ai workload agentici ed è attualmente sottoposto alle ultime attività di red-teaming e valutazione prima del rilascio più ampio. Una versione preliminare è già disponibile per un gruppo selezionato di utenti attraverso una waitlist, mentre Reflection AI ha indicato Beam come il primo modello di una nuova famiglia e ha confermato di essere già al lavoro sull’addestramento dei successori. Sul piano delle prestazioni dichiarate, Beam viene posizionato in competizione con modelli open di dimensioni superiori come GLM-5.2 e vicino a Qwen 3.8-Max nei compiti di coding e agentici, mentre Kimi K3 mantiene un vantaggio nelle capacità complessive. Reflection AI concentra però il confronto soprattutto sull’efficienza in inferenza, sostenendo che Beam raggiunga risultati comparabili a GLM-5.2 nei benchmark avanzati di reasoning utilizzando tra tre e quattro volte meno capacità computazionale e che il vantaggio cresca ulteriormente rispetto a modelli con oltre due trilioni di parametri. Nei test pubblicati dal team, Beam ha ottenuto 80,1 su Terminal Bench v2.1, 80,9 su SWE-Bench Verified, 77,2 su SWE Bench Pro v2-Hard, 97,8 su AIME 2026, 36,2 su Humanity’s Last Exam senza strumenti e 90,5 su GPQA Diamond. Le stime relative all’efficienza utilizzano dati di Artificial Analysis e DataCurve e approssimano il compute di generazione moltiplicando per due il numero di parametri attivi per il numero medio di token generati per tentativo; il calcolo non comprende però il prefill del prompt, le operazioni di attention e l’overhead dell’infrastruttura di serving, per cui Reflection AI lo considera una misura comparativa del compute e non una stima diretta del costo effettivo dell’inferenza.
L’efficienza nella generazione è stata affrontata anche durante l’addestramento attraverso una penalizzazione controllabile della lunghezza, progettata per premiare le soluzioni corrette evitando allo stesso tempo la produzione di token non necessari. Beam espone inoltre un parametro dedicato al reasoning effort, che consente di modificare il compromesso tra quantità di calcolo utilizzata e prestazioni: impostazioni inferiori favoriscono risposte più brevi, mentre livelli superiori permettono al modello di dedicare maggiore capacità ai problemi complessi. Durante il reinforcement learning, condotto principalmente su reasoning, software engineering e utilizzo del terminale, Reflection AI ha osservato anche una generalizzazione verso capacità non direttamente presenti nel mix di addestramento. Le prestazioni di browsing, per esempio, sarebbero migliorate pur in assenza di task specificamente dedicati alla navigazione, mentre con accesso al web il modello avrebbe imparato autonomamente a interrogare altri large language model e a utilizzare API OCR per leggere documenti. Le dimostrazioni pubblicate comprendono la realizzazione di una mappa della metropolitana di New York aggiornata in tempo reale attraverso dati pubblici della MTA, un gioco tridimensionale con un astronauta sviluppato in p5.js e un test di classificazione geografica nel quale Beam ha dovuto determinare se 16.200 coordinate distribuite a livello globale corrispondessero a terra o acqua, raggiungendo una copertura del 95,5%, rispetto al 92,5% ottenuto da Opus 5 e al 97,8% di Fable 5. In un ulteriore esperimento Beam ha generato autonomamente un notebook per eseguire il fine-tuning del più piccolo modello Gemma-4 su un’attività Text2SQL, operazione che secondo Reflection AI ha aumentato del 66,5% l’accuratezza del modello sul test set held-out.
La fase di pretraining è stata condotta su 23,8 trilioni di token provenienti dal web, da fonti pubbliche e da dataset proprietari concessi in licenza, utilizzando 6.144 GPU NVIDIA GB300 NVL72 e completando l’intero ciclo in meno di quattro settimane. Durante l’addestramento sono stati effettuati nove rewind semi-automatici, resi necessari da picchi nella gradient norm o da sospetti episodi di silent data corruption, mentre il goodput, definito come la percentuale del tempo complessivo effettivamente dedicata a step di training poi mantenuti nel modello finale, ha raggiunto il 92,3%. La pipeline dei dati ha eliminato circa il 95% dei token grezzi provenienti da Internet attraverso processi di parsing, deduplicazione e selezione qualitativa, ma Reflection AI sostiene di avere preservato circa 1,8 trilioni di token di elevata qualità che sarebbero stati invece esclusi attraverso tecniche di filtraggio più convenzionali; tra questi rientra l’87% dei token appartenenti alla raccolta curata di codice web. Una pipeline separata è stata inoltre utilizzata per elaborare contenuti PDF impiegando un modello vision-language OCR accompagnato da classificatori qualitativi sviluppati internamente e distribuiti su migliaia di GPU. Una successiva fase di midtraining ha esteso la lunghezza effettiva del contesto di Beam fino a un milione di token. Dal punto di vista architetturale, il modello combina meccanismi di local e global attention alternati, routed expert a granularità fine e un sistema di bilanciamento del carico privo di auxiliary loss, basato anche sul decadimento cosine degli aggiornamenti all’expert bias. L’architettura incorpora inoltre depth-based residual scaling, SandwichNorm, gating element-wise dell’attention e accumulo dei residual in FP32. Al termine del pretraining, Reflection AI ha registrato una distribuzione pressoché uniforme del carico tra gli expert, con il nodo più utilizzato attestato mediamente a 1,04 volte il carico medio, mentre le norme del residual stream sono rimaste controllate lungo tutti i 52 layer del modello.
Particolarmente estesa è stata anche la fase di reinforcement learning ad alto carico computazionale, durante la quale sono stati generati più di 100 milioni di rollout utilizzando 10.500 GPU NVIDIA GB300 per un periodo di quattro settimane. Il training ha utilizzato una lunghezza massima del contesto pari a 256.000 token e circa 1,3 miliardi di sandbox per l’addestramento e la valutazione automatizzata. Reflection AI afferma di avere raccolto quasi un milione di ambienti dedicati a coding, attività agentiche e discipline STEM, in gran parte costruiti mediante pipeline di dati sintetici, e descrive il processo come uno dei più grandi training RL realizzati fino a oggi da un laboratorio open. L’infrastruttura ha sostenuto mediamente 110.000 rollout concorrenti e raggiunto picchi di 170.000 sandbox simultanee, gestendo oltre un miliardo di richieste di creazione di sandbox distribuite tra più di venti cluster, due cloud provider e quattro regioni. I nuovi pesi prodotti durante il training venivano distribuiti alla flotta di inferenza con una latenza mediana di circa 12 secondi, mentre 71 incidenti nell’infrastruttura di inferenza sono stati gestiti senza interrompere il job di addestramento. Il dynamic packing ha mantenuto i batch di training pieni mediamente al 99,99%, mentre l’architettura asincrona del sistema è rimasta stabile anche quando il modello apprendeva da campioni generati da pesi vecchi fino a 107 versioni, corrispondenti a circa un giorno di ritardo rispetto alla policy corrente.
Reflection AI ha adottato un percorso separato anche per l’allineamento e la sicurezza. A partire dallo stesso checkpoint pretrained è stato addestrato un secondo modello attraverso una pipeline indipendente di supervised fine-tuning e reinforcement learning orientata a specifici principi comportamentali; questo modello è stato successivamente combinato con il teacher proveniente dal reinforcement learning su larga scala utilizzando una procedura di multi-teacher on-policy distillation. I principi di comportamento sono organizzati su tre livelli: regole che il modello non deve violare, qualità che dovrebbe mantenere con continuità e uno stile di interazione predefinito. Il dataset di sicurezza è stato costruito in modo avversariale e iterativo, reinserendo in ogni nuova fase di training gli attacchi che erano riusciti a superare le difese nelle iterazioni precedenti. Il reinforcement learning dedicato alla safety ha incluso interazioni single-turn e multi-turn, jailbreak e scenari agentici nei quali un avversario simulato esercitava pressione su un modello dotato di strumenti. Reflection AI sostiene inoltre di avere sviluppato un metodo di previsione dei miglioramenti ottenibili attraverso il reinforcement learning che ha raggiunto una correlazione di 0,79 con i risultati effettivi, rispetto allo 0,46 ottenuto utilizzando soltanto un limite Best-of-N. I risultati completi delle valutazioni di sicurezza saranno pubblicati nel technical report di Beam e la società ha dichiarato l’intenzione di rendere open source anche le proprie valutazioni interne dedicate alla safety.
Beam sarà distribuito con licenza Apache 2.0 e Reflection AI prevede di pubblicarne i pesi entro la fine di ottobre 2026 insieme a technical report, model card, documentazione e all’intero stack necessario per eseguire, valutare e sottoporre il modello a fine-tuning. Il lancio dovrebbe comprendere anche partnership di distribuzione e integrazioni con librerie open source e framework di valutazione. L’azienda ha impostato la propria strategia sul rilascio dei pesi dei modelli, sulla pubblicazione dei risultati di ricerca e sull’apertura di software, strumenti di reinforcement learning e ambienti di training. Reflection AI risulta inoltre validata su Dell AI Factory con NVIDIA ed è membro certificato del consorzio collegato alla Genesis Mission del Dipartimento dell’Energia degli Stati Uniti, attraverso il quale i suoi modelli open-weight sono destinati ai 17 National Laboratories statunitensi. Parallelamente, l’azienda sta sviluppando con Shinsegae una cloud AI sovrana da 250 megawatt in Corea del Sud, progetto sostenuto dai governi statunitense e sudcoreano.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)