
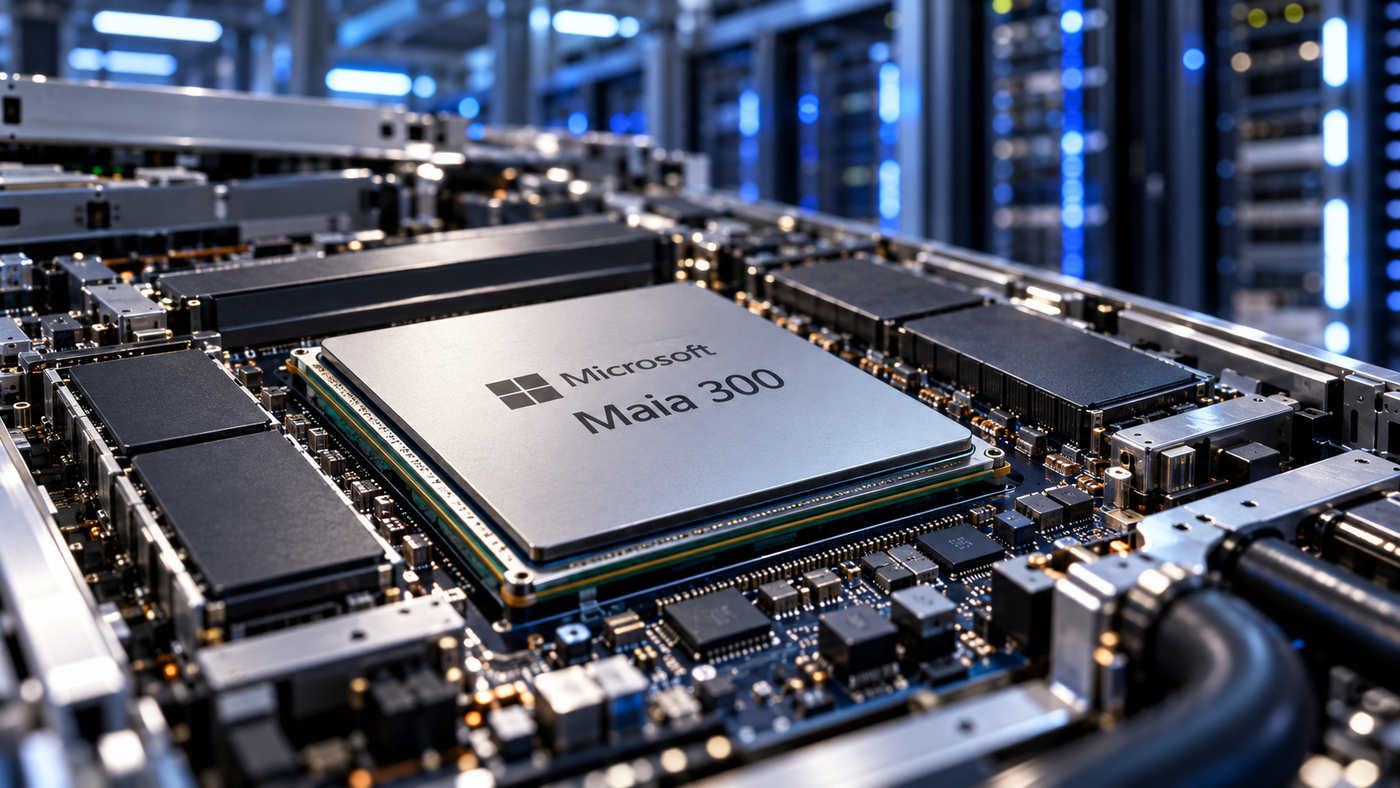
Microsoft ha presentato Azure Maia 300, la terza generazione degli acceleratori proprietari destinati all’esecuzione dei modelli di intelligenza artificiale nei propri data center. Il nuovo sistema è stato progettato specificamente per l’inferenza su larga scala, con particolare attenzione ai modelli dotati di finestre di contesto estese, ai carichi computazionali dominati dalla generazione sequenziale dei token e alle applicazioni agentiche che richiedono numerose operazioni consecutive. L’architettura è sviluppata congiuntamente alle componenti software, di rete, alimentazione e raffreddamento, anziché considerare il processore come un elemento indipendente. Microsoft prevede di avviare l’implementazione produttiva nel 2027 e di espandere progressivamente la famiglia Maia fino a installazioni con potenze complessive nell’ordine di diversi gigawatt. L’obiettivo dichiarato è utilizzare gli acceleratori proprietari come piattaforma principale per l’inferenza dei servizi Microsoft, aumentando la capacità di elaborazione disponibile entro i limiti energetici e termici delle infrastrutture Azure.
Il processore Maia 300 utilizza un’architettura multi-chiplet che separa le unità di calcolo dalle componenti dedicate al controllo della memoria e alle interfacce di comunicazione. I chiplet computazionali sono realizzati da TSMC mediante il processo produttivo N2P, mentre la suddivisione funzionale permette di adottare soluzioni differenti per le altre componenti del package. Ogni acceleratore dispone di otto stack HBM4, per una capacità complessiva di 288 GB e una larghezza di banda teorica massima di 18 TB/s, con un Thermal Design Power di 950 W. Rispetto a Maia 200, Microsoft dichiara un incremento del 33% nella capacità della memoria, una larghezza di banda superiore di 2,5 volte e un rapporto fra banda HBM e consumo energetico approssimativamente doppio. La nuova organizzazione della memoria passa inoltre da un modello di accesso sostanzialmente uniforme a una struttura NUMA, nella quale la collocazione dei dati tiene conto della vicinanza fisica alle unità di elaborazione. Le memorie SRAM integrate vengono gestite dal software come aree temporanee di lavoro, riducendo gli accessi alla HBM e il trasferimento di dati fra regioni computazionali differenti.
La gestione dei flussi di dati deriva dall’architettura Software Defined Locally Accessed Dataflow Architecture, già adottata nella precedente generazione Maia. Il sistema separa la programmazione del percorso di controllo dall’esecuzione delle operazioni e consente di coordinare esplicitamente il posizionamento dei tensori, gli spostamenti tramite motori DMA, le conversioni numeriche e la sincronizzazione fra unità di calcolo e memoria. Maia 300 introduce ottimizzazioni nel set di istruzioni vettoriali per operazioni quali softmax e conversione dei tipi numerici, oltre al supporto per formati a precisione ridotta, fra cui una versione migliorata di MXFP4 e rappresentazioni di archiviazione inferiori a tre bit. Queste caratteristiche sono destinate principalmente a limitare la quantità di memoria necessaria per i pesi dei modelli e per le strutture KV-cache, utilizzate per conservare le informazioni intermedie durante la generazione del testo. Secondo i dati architetturali Microsoft, le modifiche consentono un incremento del 36% nella capacità computazionale espressa in FLOPS e del 14% nella larghezza di banda delle comunicazioni scale-up rispetto alla generazione precedente. I vantaggi effettivi dipendono tuttavia dal formato numerico utilizzato, dai kernel disponibili e dalla distribuzione delle operazioni nei singoli modelli.
La configurazione rack comprende 96 acceleratori distribuiti in 24 moduli da quattro chip, con processori host, memoria, archiviazione e raffreddamento integrati nei rispettivi tray. L’assorbimento previsto per l’intero rack è di 167 kW, mentre la capacità HBM aggregata raggiunge 27,6 TB e la larghezza di banda complessiva dichiarata arriva a circa 1,7 PB/s. La rete locale utilizza sei ASIC di switching distribuiti in tre moduli raffreddati a liquido, collegando gli acceleratori mediante connessioni elettriche dirette e percorsi commutati. Per l’espansione oltre il singolo rack, Microsoft adotta una topologia a due livelli che permette di collegare fino a 128 rack e 12.288 acceleratori in un unico dominio denominato superpod. Le comunicazioni fra rack utilizzano collegamenti ottici e un protocollo di trasporto AI proprietario basato su infrastruttura Ethernet. L’organizzazione distingue collegamenti diretti fra acceleratori appartenenti allo stesso tray, percorsi attraverso uno switch all’interno del rack e percorsi fino a tre passaggi di switching fra rack differenti. In determinate configurazioni di allocazione della banda, Microsoft indica una capacità di comunicazione fino a 750 GB/s per acceleratore verso altri elementi del superpod, senza presentarla come una banda simultaneamente garantita verso tutti i dispositivi.
L’architettura di rete consente di mantenere all’interno dello stesso dominio scale-up le operazioni di tensor parallelism, expert parallelism e pipeline parallelism, distribuendole in funzione delle dimensioni del modello e della disponibilità degli acceleratori. Microsoft descrive anche la possibilità di separare fisicamente le fasi di prefill e decode: dopo l’elaborazione iniziale della richiesta, lo stato KV può essere trasferito direttamente agli acceleratori incaricati della generazione successiva, senza ricorrere necessariamente a un percorso di comunicazione mediato dal processore host. Il sistema prevede inoltre la riallocazione dei carichi verso acceleratori di riserva collocati in rack differenti, accettando un possibile aumento della latenza di rete per mantenere disponibili le risorse computazionali. L’alimentazione utilizza due ingressi ridondanti, busbar a 50 V e un sistema automatico di trasferimento dell’alimentazione. Il raffreddamento a liquido rimuove, secondo il progetto, oltre l’80% del carico termico del rack, mentre il raffreddamento ad aria rimane destinato alle componenti ausiliarie. Sono previste configurazioni con collegamento diretto all’acqua dell’impianto oppure mediante scambiatori termici per strutture prive di distribuzione idraulica dedicata.
Microsoft stima che Maia 300 possa fornire il 40% di token utili in più per megawatt rispetto ai principali sistemi basati su GPU e fino a sette volte il throughput di token per rack rispetto a Maia 200, utilizzando la configurazione completa da 96 acceleratori. Per il sistema rack viene inoltre indicato un miglioramento superiore a 2,5 volte nelle prestazioni per watt rispetto alla generazione precedente. Questi valori sono prestazioni dichiarate dal produttore e non costituiscono, al momento dell’annuncio, risultati di una comparazione indipendente condotta su carichi omogenei e pubblicamente riproducibili. La precedente generazione Maia 200 risulta invece già impiegata nei servizi Microsoft Copilot e nelle attività del gruppo MAI, con ulteriori implementazioni previste per GitHub Copilot e Microsoft Foundry. Il percorso di sviluppo della nuova piattaforma riguarda quindi sia la sostituzione graduale di capacità d’inferenza attualmente affidate ad altre architetture hardware, sia l’integrazione più stretta fra acceleratori, modelli e infrastruttura cloud, la cui effettiva scala operativa sarà verificabile con l’avvio delle installazioni commerciali nel 2027.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)