
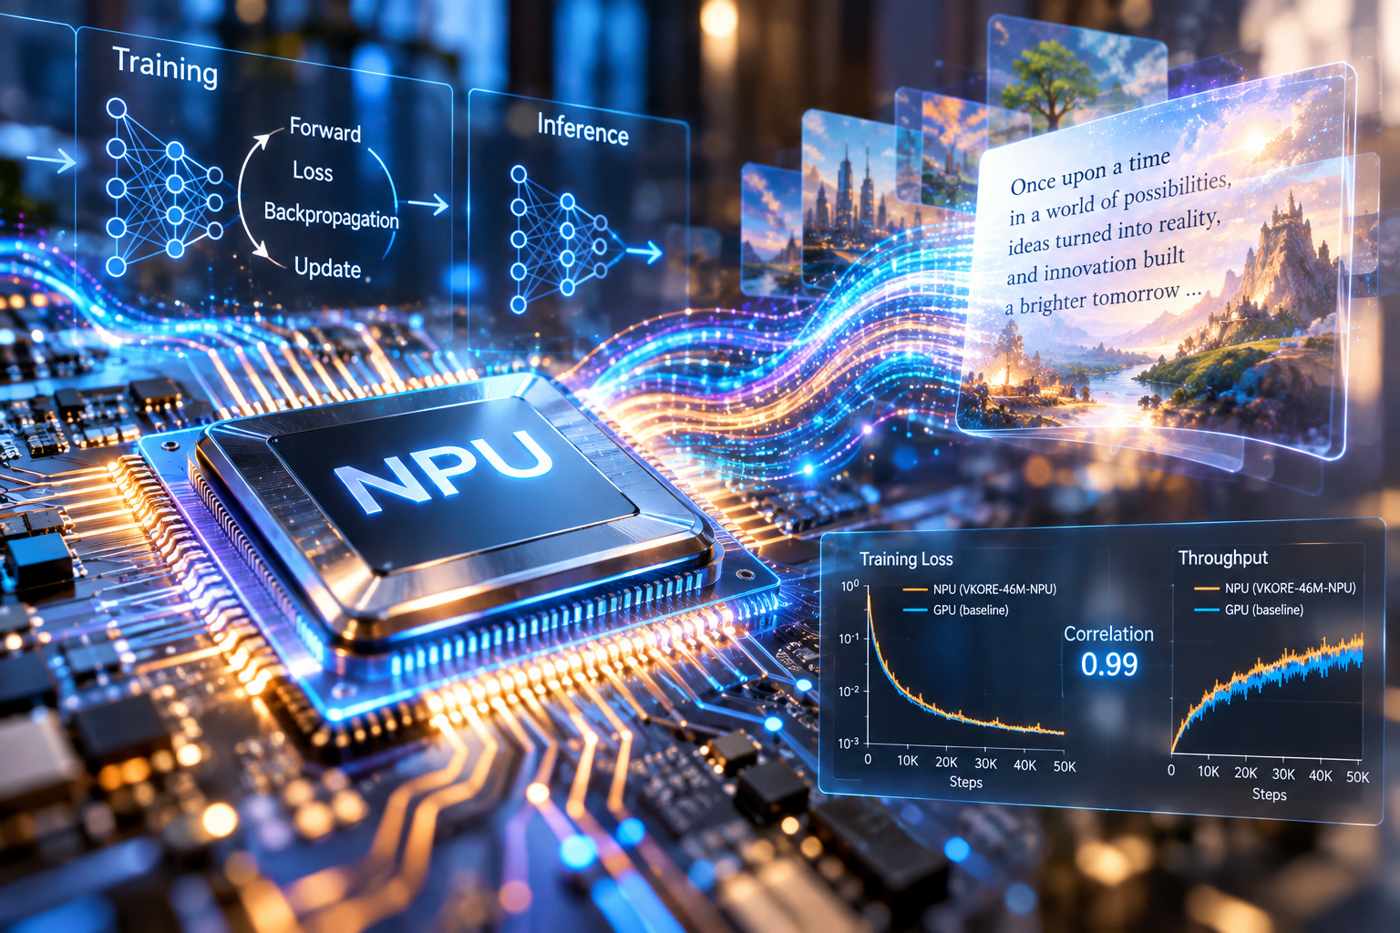
La società sudcoreana VDraft ha annunciato il 15 ottobre 2026 di essere riuscita ad addestrare da zero un piccolo modello linguistico utilizzando esclusivamente una Neural Processing Unit progettata originariamente per le operazioni di inferenza, senza ricorrere a GPU Nvidia durante il processo. Il modello, denominato VKORE-46M-NPU, è stato sviluppato impiegando un acceleratore di prima generazione introdotto nel 2025 e dimostrando, secondo l’azienda, la possibilità di eseguire operazioni di pre-addestramento su una categoria di hardware generalmente destinata all’esecuzione di reti neurali già addestrate. VDraft ha reso disponibili attraverso Hugging Face i pesi del modello, la documentazione tecnica e i risultati delle analisi comparative, sostenendo di non aver individuato nella letteratura pubblica precedenti equivalenti relativi a un addestramento completo effettuato con queste modalità. La caratteristica principale del progetto riguarda l’esecuzione della retropropagazione, necessaria per calcolare i gradienti e aggiornare progressivamente i parametri della rete, su un processore specializzato che normalmente non dispone del supporto software richiesto per queste operazioni.
Le NPU dedicate all’inferenza sono progettate per accelerare le operazioni matematiche necessarie all’esecuzione dei modelli, spesso privilegiando un’elevata efficienza energetica, l’impiego di rappresentazioni numeriche compatte e la riduzione della complessità hardware. L’addestramento richiede invece ulteriori funzionalità, poiché il sistema deve elaborare i dati in avanti, calcolare l’errore rispetto agli obiettivi previsti, propagare i gradienti attraverso i livelli della rete e aggiornare i pesi. VDraft dichiara di aver sviluppato una tecnica proprietaria in grado di eseguire queste operazioni attraverso acceleratori normalmente utilizzati soltanto per l’inferenza, permettendo di inizializzare un modello senza pesi preaddestrati e completarne il processo di apprendimento. VKORE-46M-NPU è stato addestrato utilizzando dataset pubblici ed è in grado di generare brevi racconti in lingua inglese; la sua dimensione contenuta consente di verificare sperimentalmente il metodo senza ricorrere alle risorse normalmente necessarie per l’addestramento dei grandi modelli linguistici.
Per valutare il comportamento del sistema, VDraft ha eseguito un addestramento comparativo dello stesso modello su una GPU ad alte prestazioni, mantenendo condizioni sperimentali equivalenti. Secondo i dati diffusi dall’azienda, i due processi hanno mostrato curve di perdita e andamento della capacità di elaborazione convergenti, con un coefficiente di correlazione pari a 0,99 tra le traiettorie della funzione di perdita. Il risultato viene presentato come evidenza della capacità del metodo di riprodurre un processo di ottimizzazione coerente con quello eseguito su hardware tradizionalmente utilizzato per l’apprendimento automatico. L’azienda non ha pubblicato il codice fondamentale della tecnica di addestramento, poiché la relativa proprietà intellettuale è oggetto di una procedura di brevettazione; sono invece disponibili il modello, la model card e i materiali relativi alla comparazione con la GPU. Una pubblicazione scientifica successiva dovrebbe descrivere nel dettaglio il funzionamento del metodo proprietario.
La tecnologia è inserita all’interno di VKORE, il livello software sviluppato da VDraft per integrare accelerazione dell’inferenza e funzionalità di addestramento sulle NPU. La società intende costruire un ambiente capace di gestire, attraverso una stessa infrastruttura hardware, pre-addestramento, fine-tuning mediante LoRA, inferenza accelerata e quantizzazione dei modelli. Nell’ambito delle verifiche condotte, VDraft ha applicato la propria soluzione anche a modelli pubblici differenti da quelli sviluppati internamente, controllando il corretto funzionamento delle operazioni di inferenza e registrando miglioramenti nella velocità di esecuzione per i modelli quantizzati. L’obiettivo dichiarato è sviluppare un livello software per le NPU paragonabile, per ampiezza funzionale, al ruolo che CUDA svolge nell’ecosistema delle GPU Nvidia, rendendo possibile l’impiego di acceleratori alternativi per un numero maggiore di operazioni lungo il ciclo di sviluppo dei modelli.
VDraft collega questa evoluzione alla possibilità di ridurre i costi di acquisizione e gestione delle infrastrutture AI, soprattutto per le aziende che non necessitano di addestrare modelli di dimensioni particolarmente elevate. I server basati sulle più recenti GPU Nvidia Blackwell comportano investimenti significativi, tempi di approvvigionamento e requisiti energetici rilevanti, mentre alcune NPU possono essere installate in ambienti aziendali di dimensioni più contenute, con consumi e costi inferiori. L’azienda ritiene che il supporto delle operazioni di addestramento su acceleratori già diffusi per l’inferenza possa favorire lo sviluppo di modelli personalizzati direttamente all’interno delle organizzazioni, evitando in determinati contesti il trasferimento di dati sensibili verso infrastrutture esterne. Il risultato ottenuto con VKORE-46M-NPU riguarda per il momento un modello sperimentale di piccole dimensioni, mentre l’estensione della tecnica a sistemi più grandi dovrà essere verificata attraverso ulteriori prove. Kim Min-sik, amministratore delegato di VDraft, ha indicato nello sviluppo della piattaforma VKORE il principale percorso di evoluzione della tecnologia, con l’obiettivo di ampliare le capacità operative delle NPU e ridurre la dipendenza da specifiche architetture hardware e software per l’addestramento e l’esecuzione dei modelli linguistici.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)