
L’Allen Institute for AI (Ai2) ha presentato il 3 novembre 2026 StateBench, un benchmark accompagnato da dataset e codice sorgente destinato a valutare la capacità dei modelli linguistici di mantenere e aggiornare correttamente lo stato di variabili durante l’elaborazione di sequenze testuali molto estese. Il lavoro, sviluppato da Jackson Petty, William Merrill e Ashish Sabharwal, introduce una classificazione gerarchica di quattro livelli di difficoltà fondata sulla natura delle operazioni che modificano lo stato, anziché considerare esclusivamente la lunghezza della finestra di contesto. L’impostazione nasce dall’esigenza di distinguere le capacità di recupero delle informazioni dalla gestione delle dipendenze tra aggiornamenti successivi. Le valutazioni precedenti si erano concentrate anche sul problema algebrico S₅, basato sul tracciamento di permutazioni tra cinque elementi, senza separare sistematicamente le operazioni più semplici da quelle che richiedono forme differenti di memoria computazionale. StateBench organizza invece i problemi in categorie riconducibili alla teoria algebrica di Krohn–Rhodes, mantenendo condizioni sperimentali confrontabili attraverso sequenze derivate da una medesima rappresentazione generale, nelle quali vengono conservati il numero di variabili, i valori distinti e le posizioni delle assegnazioni, modificando soltanto le regole di aggiornamento.
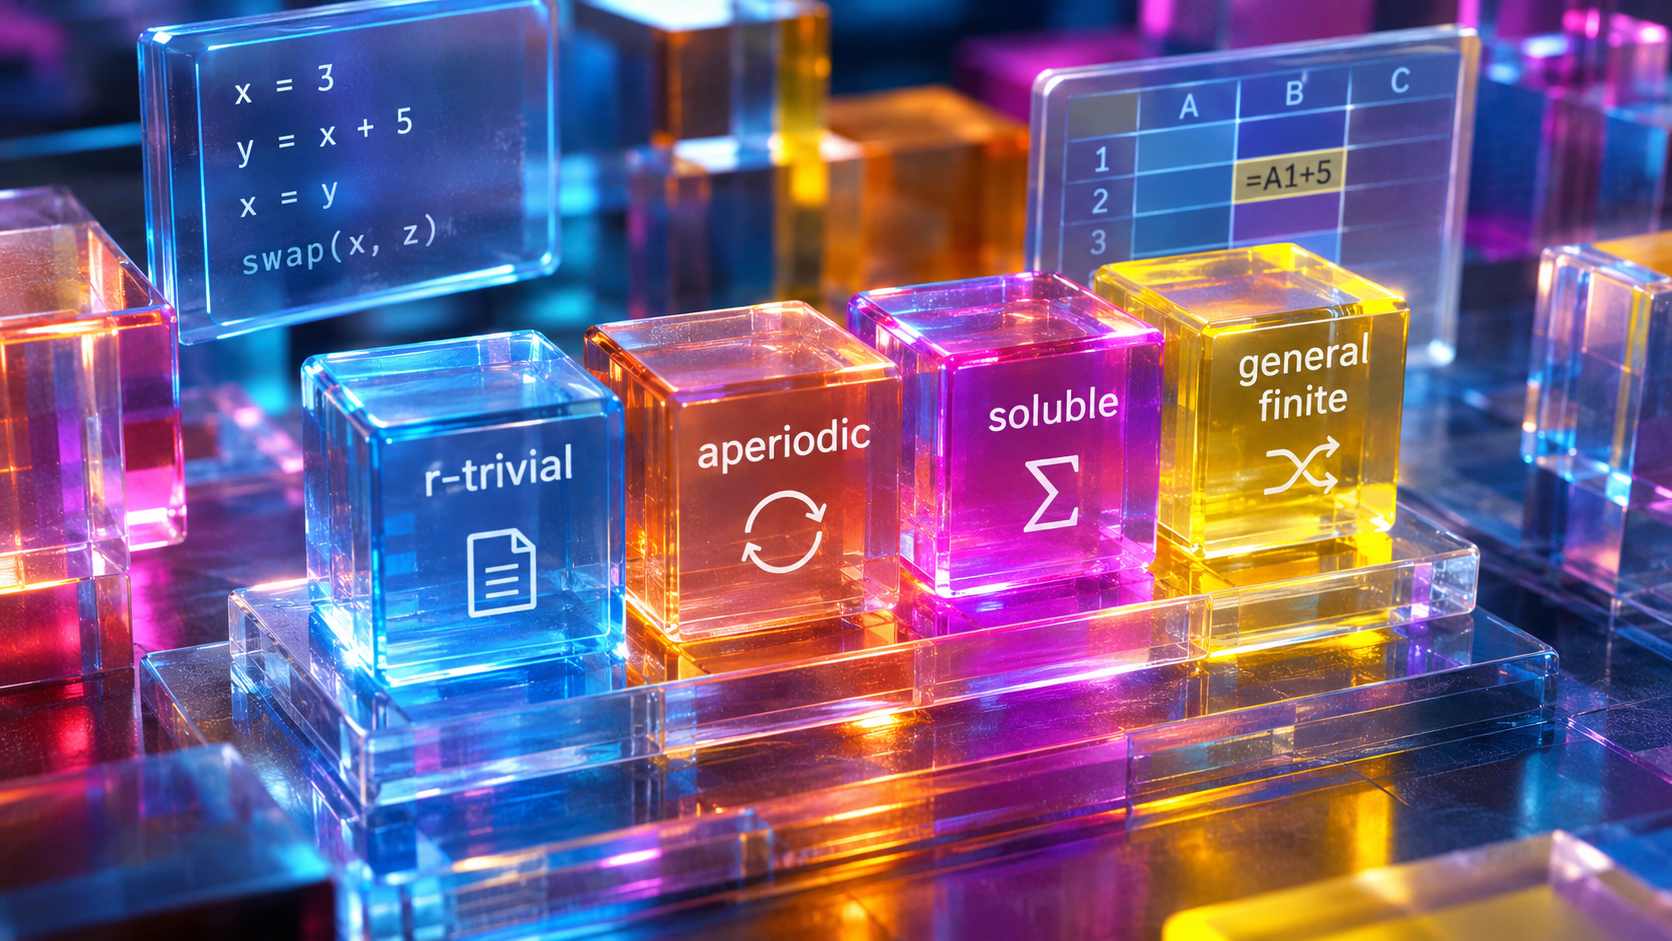
Il primo livello, denominato r-trivial, comprende assegnazioni immutabili nelle quali il modello deve recuperare il valore originario di una variabile. Il secondo, aperiodic, introduce riassegnazioni dirette che rendono determinante l’ultimo valore attribuito. Il terzo, soluble, richiede di seguire aggiornamenti autoreferenziali, come l’incremento progressivo di una variabile attraverso istruzioni del tipo x = x + 5, accumulando correttamente tutte le modifiche precedenti. Il quarto, general finite, comprende assegnazioni per riferimento e scambi tra variabili, creando dipendenze che non possono essere risolte considerando ciascun elemento separatamente. Le prove comprendono sequenze da 8 fino a 64.000 assegnazioni e prevedono sia risposte generative sia valutazioni a scelta multipla con uno stato finale corretto e quattro alternative errate. Gli stessi problemi vengono presentati mediante differenti formati testuali, tra cui istruzioni con valori interi e modifiche a celle di fogli elettronici, per misurare quanto la rappresentazione superficiale influenzi la capacità del modello di eseguire un identico processo logico.
Le valutazioni sui modelli aperti hanno coinvolto Olmo 3 da 7 miliardi di parametri, basato su transformer, Olmo Hybrid, che integra livelli Gated DeltaNet, e modelli di dimensioni inferiori addestrati sui medesimi dati. Nessuno dei sistemi considerati aveva incontrato durante l’addestramento contesti superiori a 64.000 token e gran parte delle prove è stata eseguita oltre tale limite. I risultati mostrano prestazioni generalmente elevate nei problemi r-trivial, un deterioramento progressivo nei problemi aperiodic all’aumentare della sequenza e risultati vicini alla probabilità casuale nei casi general finite. La forma di presentazione modifica sensibilmente le prestazioni: alcuni piccoli modelli ibridi e Gated DeltaNet raggiungono accuratezze prossime al massimo su determinati problemi r-trivial, ma scendono vicino al livello casuale quando gli stessi aggiornamenti sono rappresentati come modifiche a un foglio elettronico. Ai2 ha inoltre valutato Gemini 3.8 Flash, Claude Opus 5.5, GPT-6 Sol e GPT-6 Luna, richiedendo la generazione dei valori finali di tutte le variabili. I quattro modelli hanno ottenuto risultati soddisfacenti nei livelli r-trivial e aperiodic, mentre le prestazioni sono diminuite sensibilmente nei problemi soluble e general finite, fino a raggiungere un’accuratezza del 13% o inferiore nei casi general finite più lunghi.
Per distinguere i limiti architetturali da quelli introdotti dal preaddestramento, i ricercatori hanno costruito e addestrato da zero sei modelli da 275 milioni di parametri, comprendenti due varianti transformer, due architetture ibride e due Gated DeltaNet caratterizzati da differenti vincoli sugli aggiornamenti della memoria. L’addestramento è stato limitato a sequenze di 256 assegnazioni, mentre la valutazione si è estesa fino a lunghezze 250 volte superiori. I modelli ricorrenti e ibridi hanno mostrato una generalizzazione quasi perfetta sui livelli r-trivial, aperiodic e soluble anche nelle sequenze più estese, mentre i transformer hanno perso precisione oltre la distribuzione di addestramento e non sono riusciti ad apprendere i problemi general finite neppure nelle condizioni interne alla distribuzione. Nei problemi più complessi, la variante Gated DeltaNet che ammette autovalori positivi e negativi ha mantenuto prestazioni prossime al massimo fino a circa dieci volte la lunghezza di addestramento, mentre quella vincolata ad autovalori non negativi ha mostrato un decadimento immediato oltre tale soglia. La ricerca presenta anche una dimostrazione teorica della capacità delle Gated DeltaNet a precisione fissa con autovalori non negativi di risolvere tutti i problemi aperiodic e alcuni periodici, compreso il riconoscimento della parità mediante una costruzione che utilizza arrotondamenti. Restano aperte la classificazione esatta di questa variante nella gerarchia, la possibilità di risolvere tutti i problemi soluble e l’influenza della precisione numerica e dell’integrazione di livelli di attenzione. Il dataset pubblico comprende 68.000 record per 1,05 GB, con tracce canoniche delle operazioni, stati finali, prompt, risposte, alternative errate, classificazioni di complessità e metadati di generazione. Il repository distribuito con licenza Apache 2.0 consente di generare nuove sequenze e mantenere separazioni semantiche tra dati di addestramento e valutazione.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)