
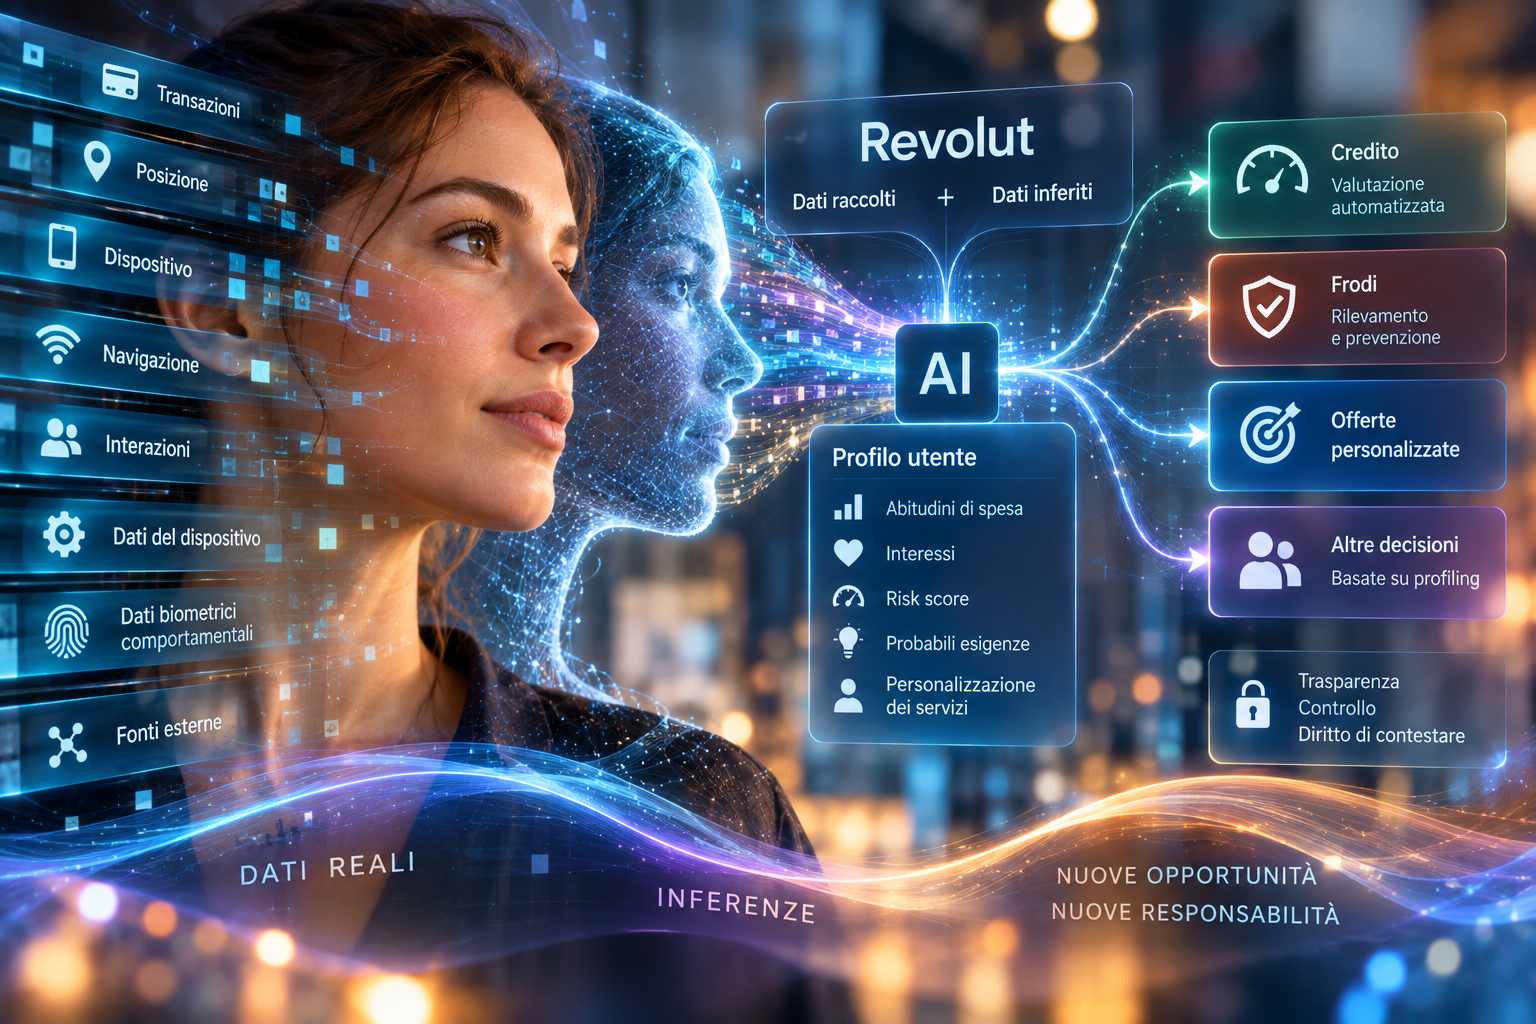
L’utilizzo dell’intelligenza artificiale nei servizi digitali sta modificando il concetto stesso di dato personale, perché le piattaforme non si limitano più a elaborare le informazioni fornite direttamente dagli utenti ma possono produrre nuove informazioni attraverso correlazioni, classificazioni e inferenze. Un esempio particolarmente esplicito arriva dal settore finanziario: nella propria informativa sulla privacy Revolut distingue infatti i dati raccolti direttamente dalle informazioni che la società “inferisce o crea” analizzando quelle già disponibili. Da una cronologia delle transazioni, dai dettagli forniti durante una richiesta, dal comportamento nell’applicazione e da altre informazioni possono così derivare profili basati sulle abitudini di spesa e sugli interessi, punteggi che stimano il rischio di credito o di frode e previsioni relative alle probabili esigenze o alla situazione finanziaria dell’utente. Il dato iniziale può quindi essere perfettamente fattuale, come un pagamento, la visita a una determinata sezione dell’applicazione o una richiesta di un prodotto, mentre ciò che viene successivamente memorizzato e utilizzato è una valutazione costruita algoritmicamente sulla persona. La distinzione è importante perché il profilo derivato può influenzare l’esperienza dell’utente e alcune decisioni future pur contenendo informazioni che quell’utente non ha mai dichiarato esplicitamente.
La quantità di segnali utilizzabili per costruire queste inferenze è inoltre molto più ampia dei soli dati finanziari. Revolut indica tra le informazioni raccolte indirizzo IP, dispositivo utilizzato, sistema operativo, lingua e fuso orario, identificatori del dispositivo e della rete mobile, pagine e servizi consultati, durata delle visite, clic e modalità di interazione, transazioni effettuate, valuta, importi, destinatari e commercianti coinvolti, oltre ai dati conservati sul dispositivo quando l’utente ne autorizza l’accesso. Il sistema può utilizzare anche informazioni biometriche comportamentali, come il modo in cui una persona scorre le schermate o digita, per finalità di rilevamento delle frodi. Questi dati possono essere integrati con informazioni provenienti da agenzie di credito, fornitori di verifica dell’identità, istituzioni finanziarie, registri ufficiali, sistemi antifrode e altre fonti esterne. Ciò significa che un modello non deve necessariamente ricevere una singola informazione particolarmente sensibile per costruire una valutazione significativa: può arrivarci combinando numerosi segnali apparentemente ordinari. Il passaggio tecnologico fondamentale è proprio questo, perché l’AI trasforma una raccolta di eventi separati in un modello probabilistico dell’individuo, capace di attribuirgli caratteristiche, interessi, livelli di rischio o possibili esigenze future.
Queste informazioni derivate possono poi entrare direttamente nei sistemi decisionali. Revolut specifica che, a seconda del prodotto utilizzato, alcune decisioni possono essere automatizzate e realizzate mediante intelligenza artificiale senza un intervento umano iniziale, mentre tecnologie di profiling vengono impiegate per valutare circostanze personali e prevedere rischi o risultati. Nel settore finanziario ciò può riguardare, per esempio, l’idoneità a richiedere un prodotto di credito, la valutazione delle relative domande, il contrasto alle frodi o la presentazione di prodotti ritenuti pertinenti per un determinato cliente. Diventa quindi necessario distinguere tra dato osservato e dato inferito: una transazione appartiene alla prima categoria, mentre il rischio attribuito sulla base di quella transazione e di molte altre variabili è un risultato prodotto dal sistema. La stessa logica è applicabile a numerosi altri settori. Un sistema utilizzato nelle risorse umane potrebbe derivare dai comportamenti digitali indicatori relativi alla produttività, al sentiment o alla probabilità che un dipendente lasci l’azienda; una piattaforma commerciale può costruire segmenti e preferenze a partire dalla navigazione; un sistema predittivo può utilizzare correlazioni presenti in una popolazione per stimare caratteristiche o comportamenti di un singolo individuo. In questi casi l’AI non recupera semplicemente una voce già esistente in un database, ma ne genera una nuova che può successivamente diventare essa stessa un dato utilizzato da altri processi.
Il problema assume una dimensione ulteriore quando l’inferenza risulta più sensibile dei dati dai quali è stata ottenuta. Informazioni quotidiane e apparentemente poco significative, analizzate in quantità sufficientemente elevate e combinate con dati provenienti da altre fonti, possono permettere a modelli statistici e sistemi di machine learning di stimare caratteristiche che una persona non aveva intenzione di comunicare. È proprio questo uno dei motivi per cui il profiling viene trattato separatamente dalla semplice conservazione dei dati in diversi sistemi di protezione della privacy: non conta soltanto ciò che un’organizzazione conosce perché è stato esplicitamente fornito, ma anche ciò che può dedurre attraverso l’elaborazione automatizzata. Il fenomeno non implica che ogni inferenza sia corretta. Un risk score, una previsione sulle esigenze finanziarie o un profilo di interesse sono per definizione risultati calcolati e possono contenere errori, distorsioni o correlazioni che non descrivono accuratamente la singola persona. Quando però questi risultati vengono conservati e riutilizzati, un’inferenza può acquisire nella pipeline informativa lo stesso ruolo di un dato direttamente osservato e influenzare ulteriori classificazioni o decisioni. Il rischio tecnico non riguarda quindi solamente l’accesso non autorizzato ai dati originali, ma anche la propagazione di informazioni derivate inesatte, obsolete o costruite su presupposti non più validi.
La differenza fra dati forniti e dati inferiti incide anche sulla trasparenza richiesta ai servizi che utilizzano sistemi automatizzati. Nel caso di Revolut, l’informativa distingue esplicitamente questa categoria e prevede che, quando una decisione automatizzata o un profilo producono effetti significativi, l’interessato possa chiedere che il risultato venga riesaminato da una persona, esprimere il proprio punto di vista e contestare l’esito. Il modello riflette una questione più generale della governance dell’AI: controllare l’accesso ai dati in ingresso non è sufficiente se non viene governato anche ciò che il sistema produce su una determinata persona. Per un’organizzazione questo comporta la necessità di sapere quali inferenze vengono generate, con quali fonti, per quale finalità, per quanto tempo vengono conservate e in quali processi successivi vengono utilizzate. Diventano quindi importanti audit trail, politiche di retention, procedure di correzione e cancellazione e sistemi in grado di distinguere le informazioni originarie dalle valutazioni elaborate automaticamente. Anche le normali strategie di minimizzazione dei dati devono essere estese a questa seconda categoria, perché limitare le informazioni raccolte ma conservare indefinitamente profili, punteggi e previsioni derivati dalle stesse informazioni non elimina il problema della proliferazione dei dati personali.
L’evoluzione verso sistemi AI più persistenti e integrati rende questo tema ancora più rilevante. Un’applicazione tradizionale poteva raccogliere informazioni per eseguire una funzione specifica, mentre un sistema moderno può analizzare continuamente la cronologia di utilizzo, combinare segnali provenienti da più servizi e aggiornare nel tempo un profilo dell’utente. Il risultato è un patrimonio informativo formato non soltanto da ciò che la persona ha fatto o comunicato, ma anche da ciò che algoritmi e modelli ritengono probabile sul suo comportamento futuro, sui suoi interessi o sul suo livello di rischio. Da un punto di vista tecnico, questi dati derivati possono essere estremamente utili per prevenire frodi, personalizzare servizi, ridurre attriti e automatizzare decisioni; dal punto di vista della governance richiedono però controlli specifici proprio perché la persona può non essere consapevole della loro esistenza e perché una previsione generata automaticamente può finire per influenzare servizi e decisioni successive. La gestione dei dati nell’era dell’intelligenza artificiale deve quindi estendersi all’intero ciclo dell’inferenza: dalle informazioni utilizzate come input alla generazione del profilo, fino alla conservazione, all’impiego nelle decisioni automatiche e all’eventuale modifica o eliminazione del dato derivato.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)