
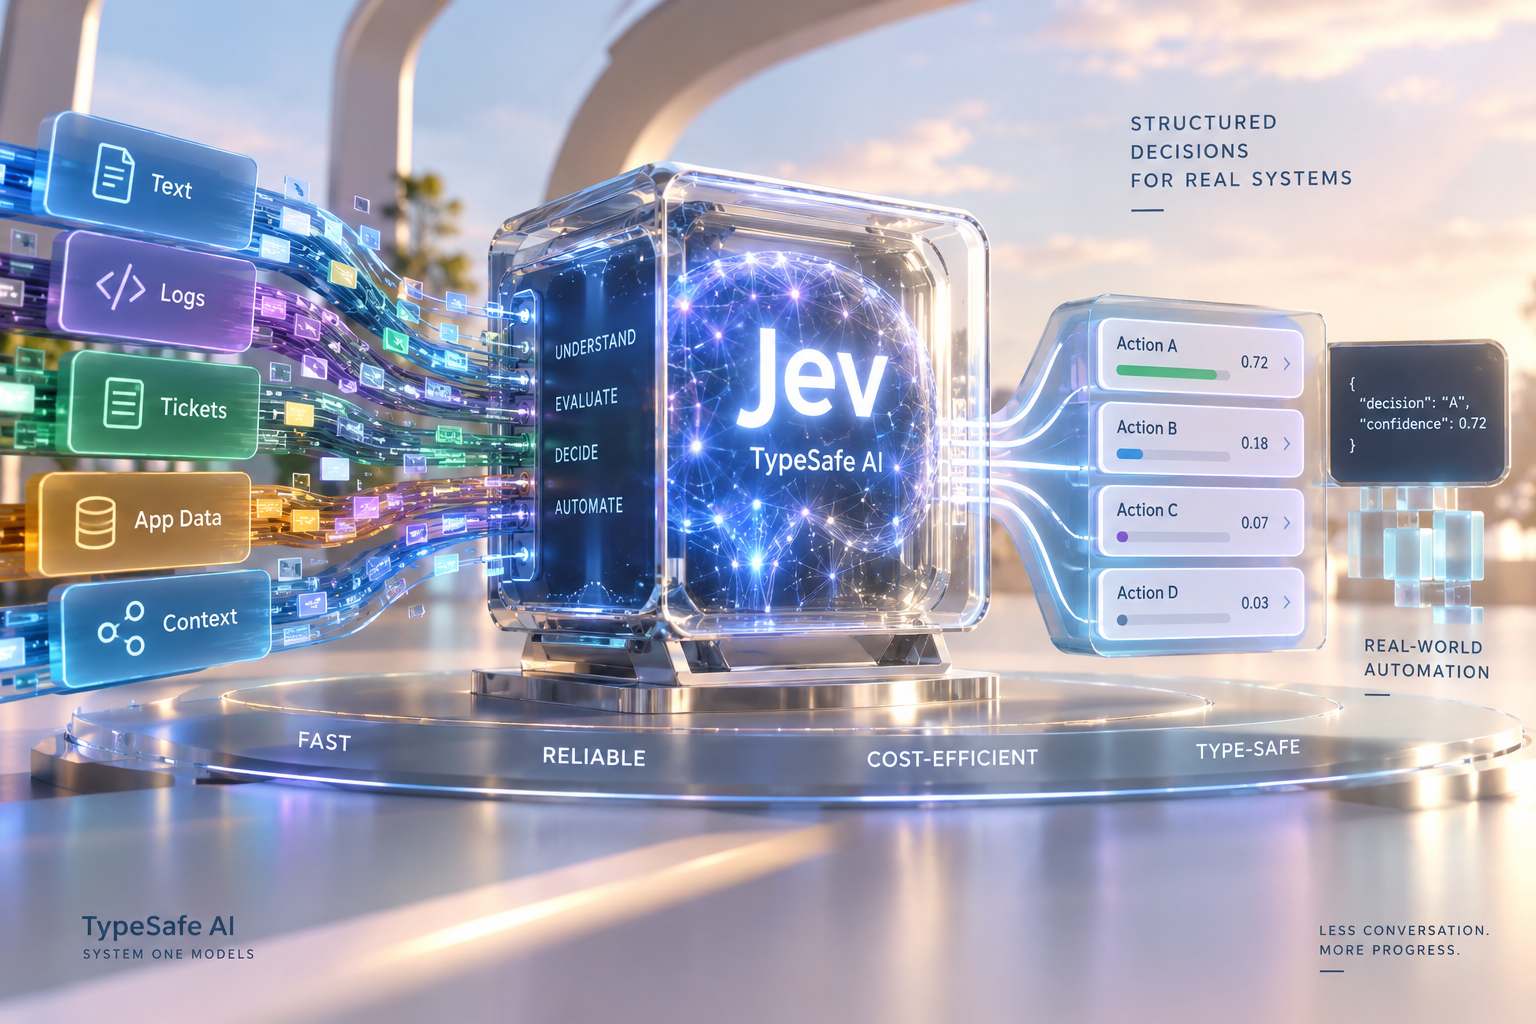
Jev sta attirando rapidamente l’attenzione degli sviluppatori perché affronta un problema molto concreto dei moderni workflow AI: usare un grande modello linguistico per ogni piccola decisione è spesso troppo lento, troppo costoso e tecnicamente sovradimensionato rispetto al compito da svolgere. Il modello sviluppato da TypeSafe AI non è pensato per generare paragrafi, conversazioni o contenuti destinati direttamente agli utenti, ma per prendere decisioni strutturate che il software può utilizzare immediatamente. Dal lancio del 15 settembre è stato sperimentato in routing tra agenti, classificazione dei contenuti, filtraggio delle e-mail, gestione del contesto, rilevamento delle frodi, revisione delle pull request e scelta degli strumenti che un agente deve utilizzare. TypeSafe descrive Jev come il primo modello “System One”, costruito cioè per prendere decisioni rapide e intuitive, e sostiene che possa essere da 20 a 200 volte più veloce e da 40 a 400 volte più economico dei modelli tradizionali nei workload per cui è stato progettato. L’interesse degli sviluppatori nasce proprio da questa specializzazione: invece di sostituire ChatGPT, Claude o Gemini, Jev può essere inserito accanto a loro e assumersi il lavoro ripetitivo costituito da centinaia di microdecisioni che oggi rallentano e rendono costosi i sistemi agentici.
Il vantaggio tecnico principale è il formato dell’output. Un LLM convenzionale riceve un prompt e genera token uno dopo l’altro, anche quando l’applicazione ha bisogno soltanto di stabilire se una richiesta appartenga alla fatturazione, all’assistenza o alle vendite, se un messaggio sia spam oppure quale agente debba ricevere un compito. Jev riceve invece dati contestuali non strutturati e una serie di domande predefinite, quindi restituisce direttamente risposte tipizzate accompagnate da probabilità e punteggi di affidabilità. Le domande supportate possono selezionare un’opzione da un elenco, attribuire un punteggio secondo una scala oppure produrre una risposta binaria sì/no, mentre le decisioni vengono generate in parallelo anziché token per token. È proprio questa impostazione a ridurre la latenza e a rendere il risultato immediatamente utilizzabile dal software senza dover interpretare testo libero. TypeSafe afferma inoltre che la struttura matematicamente vincolata impedisce errori di tipo e descrive Jev come una “function call” dotata di intelligence di frontiera. La società usa anche l’espressione secondo cui il modello “non può avere allucinazioni”, ma precisa che il dato riguarda la corrispondenza garantita dello schema dell’output e non equivale a una dimostrazione empirica che ogni decisione presa dal modello sia corretta.
La combinazione tra latenza e prezzo spiega un’altra parte importante dell’interesse. TypeSafe indica tempi di risposta compresi tra 70 e 500 millisecondi e un costo di 0,042 dollari per milione di token di input, mentre i token di output sono gratuiti. Per un agente che deve prendere decine o centinaia di decisioni durante una singola esecuzione, la differenza può diventare sostanziale rispetto all’invocazione continua di un modello di frontiera. Jev può stabilire, per esempio, quale agente debba ricevere una richiesta, se sia necessario chiamare uno strumento, se un risultato debba essere verificato, se un workflow debba essere ripetuto oppure se sia necessario passare il controllo a una persona. In questo tipo di architettura il grande modello linguistico resta disponibile per ragionamento complesso, generazione e analisi approfondita, mentre Jev funziona come livello decisionale veloce e poco costoso che mantiene in movimento l’intero workflow. È questa possibilità di distribuire l’intelligenza su più livelli, anziché affidare tutto a un unico LLM, che sta spingendo diversi sviluppatori a ripensare la struttura dei propri agenti.
I primi test pubblici mostrano perché questa impostazione abbia prodotto così tanta attenzione in pochi giorni. Hassan El Mghari di Together AI ha utilizzato Jev per classificare 1.018 articoli di ricerca spendendo circa 0,08 dollari e registrando una latenza media di 256 millisecondi. Romàn Czerny, cofondatore di Gojiberry AI, lo ha impiegato per valutare 700 lead altamente qualificati e personalizzare i relativi messaggi di contatto: il sistema ha previsto le prestazioni dei messaggi, assegnato punteggi di affidabilità e individuato incongruenze tra lead e contenuto in circa 40 secondi, con un costo dichiarato di 0,09 dollari. Jev può inoltre essere utilizzato per valutare segnali di acquisto, associare prospect e messaggi e identificare le campagne con maggiori probabilità di successo sulla base dei dati disponibili. Questi esempi sono particolarmente rilevanti per gli sviluppatori perché mostrano casi nei quali non serve una risposta linguistica sofisticata, ma migliaia di decisioni economiche e sufficientemente rapide da poter essere inserite direttamente in una pipeline applicativa.
Anche i dati di adozione su Vercel indicano quanto rapidamente l’idea sia stata recepita. Entro 24 ore dalla disponibilità di Jev su Vercel AI Gateway, quasi il 13% dei team a pagamento della piattaforma lo aveva già utilizzato, un tasso che Vercel descrive come più che doppio rispetto a quello registrato da qualsiasi altro modello lanciato in precedenza nello stesso intervallo temporale. L’ingegnere Pranit Sharma ha inoltre riferito che sostituire un classificatore basato su GPT-5.6 Luna con Jev ha reso il sistema da 5 a 18 volte più veloce, migliorando contemporaneamente la precisione nei test aziendali. Anche Harshil Mathur, cofondatore e CEO di Razorpay, ha evidenziato che un’intelligenza sufficientemente veloce e a bassa latenza può essere utilizzata “all’interno di ogni ciclo”, trasformando l’AI da chiamata relativamente rara a componente sempre presente del software. Arpit Bhayani, creatore di DiceDB, dopo circa due ore e mezza di test ha invece osservato che numerosi workflow oggi costruiti intorno agli LLM potrebbero essere ripensati proprio sfruttando questo modello decisionale più leggero.
La dimostrazione con Doom chiarisce ulteriormente il tipo di utilizzo che TypeSafe vuole rendere possibile. Jev controlla il videogioco prendendo rapidamente decisioni sulla base di informazioni strutturate relative allo stato dell’ambiente e del personaggio; non osserva direttamente lo schermo e non svolge quindi un compito di computer vision paragonabile a quello di un essere umano. Il valore della demo sta invece nel mostrare che una decisione AI può essere inserita in un ambiente interattivo con una latenza sufficientemente bassa da influenzare continuamente ciò che accade. Lo stesso principio può essere trasferito a software aziendali, sistemi di sicurezza, automazioni, motori di raccomandazione e agenti, dove una serie di decisioni veloci e frequenti può essere più importante della capacità di produrre una lunga risposta articolata.
Restano comunque diversi aspetti ancora poco trasparenti. TypeSafe descrive Jev come un modello transformer basato su una nuova architettura, campionamento parallelo e Reinforcement Learning for Calibrated Decisions, ma non ha pubblicato né la struttura completa né le dimensioni del modello. La società afferma inoltre che Jev sia stato addestrato esclusivamente con dati sintetici e di avere sviluppato un proprio programma di ricerca basato su dataset sintetici statisticamente significativi. Sono già comparsi progetti open source ispirati all’idea di Jev per browser automation, agent routing e altri workload, ma non devono essere considerati repliche dell’architettura proprietaria. Per ora, quindi, parte dell’entusiasmo deriva da risultati comunicati dalla stessa TypeSafe e da test iniziali condotti dagli sviluppatori, mentre mancano ancora informazioni sufficienti per valutare in modo indipendente parametri come dimensioni, costo computazionale, metodologia di training e comportamento su benchmark standardizzati.
La ragione per cui Jev sta conquistando gli sviluppatori è quindi meno legata alla promessa di un nuovo “modello più intelligente” e più alla possibilità di usare l’intelligenza artificiale in punti del software dove finora risultava troppo lenta o costosa. Il nome stesso deriva da William Stanley Jevons e dal paradosso secondo cui un aumento dell’efficienza può far crescere il consumo complessivo di una risorsa: TypeSafe applica la stessa logica all’AI e sostiene che, se una decisione automatizzata diventa abbastanza economica e veloce, gli sviluppatori inizieranno a inserirla praticamente ovunque. In questo scenario piccoli modelli decision-oriented possono lavorare continuamente su classificazione, routing, controllo e selezione delle azioni, mentre i grandi modelli vengono riservati ai passaggi che richiedono realmente ragionamento complesso o generazione. È questa separazione dei compiti, più che la semplice velocità dichiarata, a rendere Jev interessante come possibile nuovo componente dell’infrastruttura per agenti AI.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)