
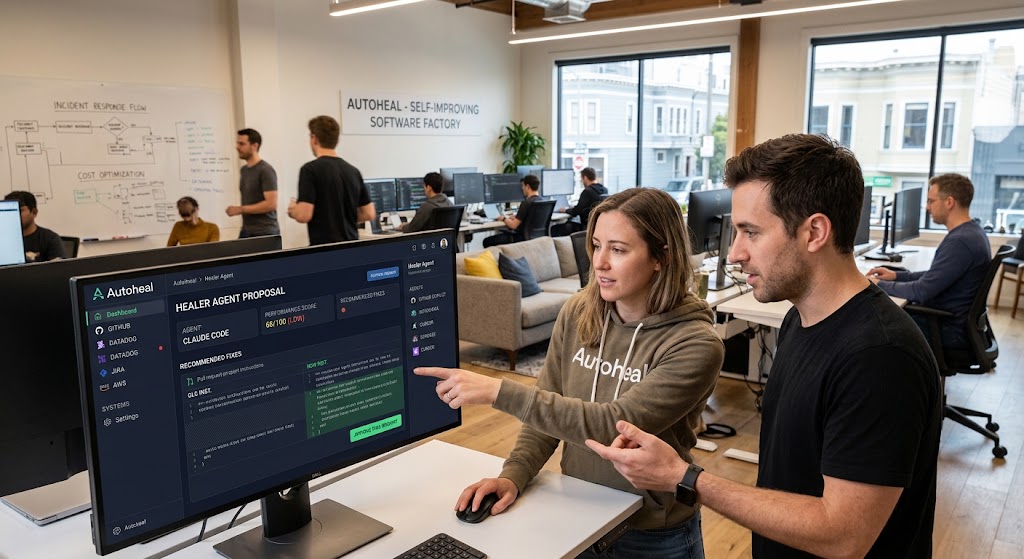
Autoheal ha reso generalmente disponibile una piattaforma progettata per gestire il lavoro operativo che rimane dopo che gli agenti AI hanno generato o modificato codice, con attività che comprendono investigazione degli incidenti, remediation delle vulnerabilità, preparazione delle release, escalation di supporto e controllo dei costi associati agli agenti di coding. La startup di San Francisco descrive il sistema come una “self-improving software factory” nella quale più agenti specializzati condividono lo stesso contesto ingegneristico, vengono valutati in base ai risultati ottenuti e possono essere modificati quando le loro prestazioni peggiorano. La piattaforma collega repository, strumenti di build e deployment, sistemi di monitoring, ambienti cloud, issue tracker e agenti già utilizzati dai team, tra cui Claude Code, Codex, GitHub Copilot, Cursor e agenti personalizzati, così che l’analisi non rimanga limitata a una singola fonte. Nel caso di un incidente, per esempio, Autoheal può raggruppare gli alert, correlare log, trace, deployment recenti e differenze nel codice, proporre una root cause nel canale operativo e, per eventi meno gravi, testare una correzione in sandbox e aprire una pull request che rimane comunque soggetta all’approvazione degli ingegneri. Il sistema può inoltre generare automaticamente una bozza di postmortem utilizzando la cronologia dell’incidente.
L’elemento più caratteristico della piattaforma è il meccanismo con cui gli agenti vengono valutati e corretti da altri agenti. Un Evaluator Agent assegna un punteggio al lavoro prodotto utilizzando segnali come commenti nelle code review, build fallite e incidenti in produzione, mentre un Healer Agent può proporre modifiche alle istruzioni, alle skill, agli strumenti o al modello utilizzato dall’agente che ha mostrato prestazioni insufficienti. Prima di essere applicate, le modifiche vengono confrontate con test storici e quindi proposte attraverso una pull request che richiede approvazione umana; i cambiamenti comportamentali vengono tracciati in Git. Lo stesso feedback può servire anche a migliorare il contesto condiviso, così che una correzione effettuata manualmente durante un incidente possa diventare informazione disponibile per esecuzioni future. I team possono definire budget e soglie di confidenza per ciascun agente, riprodurre e confrontare run differenti e analizzare costi, latenza e accuratezza per agente o per team; gli agenti possono essere richiamati tramite CLI, API, webhook, MCP, Slack e Microsoft Teams. Autoheal dichiara inoltre di offrire sandbox sicure, audit trail, controlli sui costi e model routing, riservando i frontier model alle attività più complesse e instradando i compiti ad alto volume verso modelli open-weight meno costosi quando appropriato.
La gestione dei costi è uno dei punti centrali della proposta. Autoheal può leggere le execution trace prodotte dagli agenti di coding già presenti in azienda, trasformare sessioni reali in task di valutazione, confrontare modelli e configurazioni differenti e proporre modifiche tramite pull request. La società mostra come esempio una riduzione del 30% del costo per task ottenuta abbassando l’effort del modello e un ulteriore 10% assegnando il lavoro più semplice a un modello companion di dimensioni inferiori, ma non specifica workload, campione o cliente utilizzati per calcolare queste percentuali e i dati vanno quindi interpretati come dimostrazione del metodo, non come risparmio garantito. Il modello commerciale di Autoheal è principalmente basato sul consumo e viene calcolato in dollari per sessione dell’agente: l’amministratore stabilisce il budget disponibile e l’azienda cita come esempi circa 20 dollari per una risposta complessa a un incidente di produzione e 2 dollari per una semplice correzione di vulnerabilità. Non sono invece pubblicati un listino completo, impegni minimi, sconti per volume o costi standard della valutazione iniziale di tre settimane, durante la quale un embedded engineer definisce gli obiettivi, collega i sistemi del cliente, esegue gli agenti su attività reali e analizza i risultati prima dell’eventuale adozione.
Autoheal riporta anche alcuni esempi di utilizzo aziendale, pur precisando che si tratta di risultati forniti dalla società e non di benchmark indipendenti. Nomura avrebbe ridotto il tempo medio di risoluzione degli incidenti da due ore a 15 minuti utilizzando la piattaforma per correlare informazioni provenienti da monitoring, codice, cloud, pipeline di deployment e knowledge base interne; AvidXchange la impiega per incident response, controlli di release readiness e onboarding di nuovi ingegneri e dichiara un risparmio di migliaia di ore di lavoro al mese; Nauto afferma invece che i propri tecnici on-call chiudono del 50% più rapidamente i problemi segnalati dai clienti collegando log dei dispositivi, dati di warehouse, release recenti e ticket interni. La società ha contemporaneamente annunciato un round seed da 7,9 milioni di dollari guidato da Innovation Endeavors con la partecipazione di Emergent Ventures, U&I Ventures, Darkmode Ventures, Batch Ventures e Param Hansa Values e conta attualmente 13 ingegneri tra Silicon Valley e Bengaluru. Dopo circa tre mesi di attività commerciale, Autoheal prevede ricavi a sette cifre entro la fine dell’anno e indica come direzione futura l’addestramento di modelli più piccoli sui dati ingegneristici privati dei singoli clienti, utilizzando il feedback accumulato su attività ricorrenti come incident analysis; al momento, però, questa capacità viene indicata come sviluppo futuro e non come funzione già dimostrata del prodotto disponibile oggi.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)