
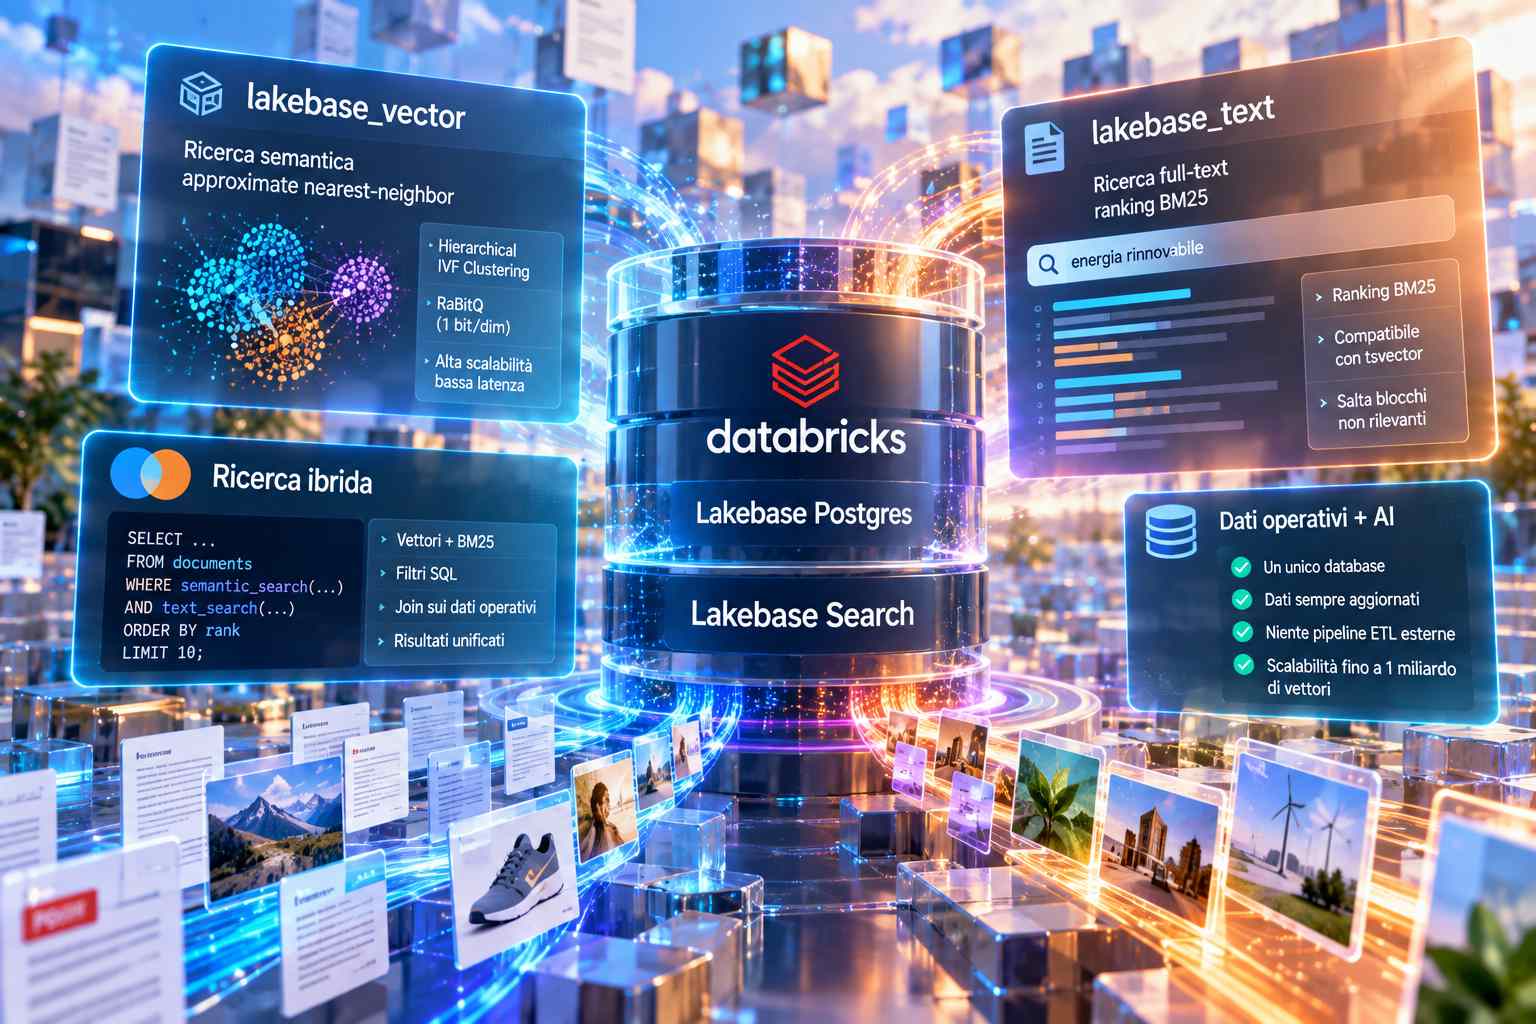
Databricks ha reso generalmente disponibile Lakebase Search, un motore di ricerca integrato in Lakebase Postgres che consente di eseguire direttamente nel database ricerche semantiche, keyword e ibride senza dover affiancare a Postgres un motore esterno e una pipeline ETL dedicata. La funzione viene distribuita attraverso due estensioni: lakebase_vector, destinata alla approximate nearest-neighbor search sui vettori, e lakebase_text, che introduce la ricerca full-text basata sul ranking BM25. Entrambe sono disponibili su AWS e Azure e permettono di interrogare nello stesso ambiente sia i dati operativi sia gli indici utilizzati dalle applicazioni AI. Databricks collega il progetto in particolare ai workload agentici, nei quali una singola attività può generare in pochi secondi migliaia di richieste di retrieval concorrenti e richiede contemporaneamente bassa latenza, elevato recall e accesso ai dati aggiornati. Lakebase Search è stato sviluppato anche utilizzando il feedback di centinaia di clienti durante la fase beta e viene proposto come alternativa alla tradizionale architettura composta da database OLTP, vector database o motore di ricerca separato e processi di sincronizzazione tra i diversi sistemi.
Una parte centrale del progetto riguarda i limiti riscontrati da Databricks nell’utilizzo di pgvector su dataset molto grandi. L’estensione HNSW di pgvector mantiene l’indice in memoria per garantire latenze ridotte, ma quando questo supera la RAM disponibile e viene spostato su disco le prestazioni possono diminuire tra 10 e 50 volte a causa delle letture casuali necessarie per attraversare il grafo. Un vettore float32 a 768 dimensioni richiede, includendo collegamenti del grafo e overhead di Postgres, circa 3,3 KB; un indice da 100 milioni di righe necessita quindi di circa 330 GB di RAM per rimanere completamente residente. Databricks segnala inoltre costi elevati nella costruzione e manutenzione degli indici: in un proprio test un indice pgvector finito su disco ha richiesto quasi 50 ore per essere costruito su una normale istanza cloud, mentre il recupero della qualità di ricerca può richiedere un REINDEX completo che blocca la tabella e impedisce le scritture durante l’operazione. Anche una singola query HNSW viene normalmente eseguita da un solo processo backend di Postgres e non può quindi essere distribuita su più core, creando un compromesso tra recall, latenza e throughput quando aumenta il numero di nodi da visitare.
lakebase_vector utilizza invece l’architettura di Lakebase che separa storage e compute: i dati persistenti rimangono nel cloud object storage, mentre RAM e NVMe locali funzionano come cache temporanee per il working set effettivamente utilizzato. Su questa base Databricks combina hierarchical IVF clustering e quantizzazione binaria RaBitQ. I vettori vengono suddivisi in cluster memorizzati in blocchi contigui; durante una ricerca vengono prima valutati i centroidi dei cluster e vengono letti soltanto i blocchi considerati promettenti, sostituendo una lunga sequenza di accessi casuali con poche letture sequenziali di dimensioni maggiori. RaBitQ comprime inoltre ciascun vettore a circa un bit per dimensione, con una rappresentazione circa 32 volte più piccola rispetto al float32: le versioni compresse vengono utilizzate per selezionare rapidamente i candidati, mentre soltanto un insieme ristretto viene successivamente rivalutato utilizzando i vettori alla precisione completa. Il sistema è stateless, può scalare fino a zero quando non viene utilizzato e riattivarsi alla query successiva; nei test Databricks il primo accesso dopo scale-to-zero su 100 milioni di vettori da 768 dimensioni ha registrato un P90 di 1,13 secondi, mentre lo stesso dataset può essere servito utilizzando una singola Lakebase Compute Unit. Anche la costruzione degli indici viene parallelizzata e può essere scaricata dal database primario verso motori distribuiti come Spark attraverso l’architettura LTAP.
La componente testuale viene gestita da lakebase_text, che aggiunge a Postgres un indice BM25 compatibile con i normali tipi tsvector e con gli operatori di ricerca già utilizzati nell’ecosistema PostgreSQL. A differenza della ricerca full-text standard basata su tsvector e indici GIN, BM25 utilizza informazioni sull’intero corpus e assegna maggiore importanza ai termini rari e più discriminanti, riducendo invece il peso delle parole molto frequenti. Lakebase Search calcola inoltre limiti superiori del punteggio durante l’attraversamento dell’indice e può saltare interi blocchi di posting quando è già possibile stabilire che non potranno entrare nei risultati top-K. Le due estensioni possono essere combinate nella stessa query per realizzare ricerca ibrida: una richiesta SQL può contemporaneamente applicare filtri tradizionali, eseguire join con tabelle operative aggiornate, calcolare la similarità semantica tra vettori e utilizzare il ranking BM25 sui termini testuali, producendo un’unica lista di risultati. Databricks dichiara che la piattaforma può scalare da una singola riga fino a un miliardo di vettori e da una query al secondo a migliaia di richieste concorrenti senza riprovisionamento manuale dell’infrastruttura.
Nei benchmark VectorDBBench sul dataset LAION da 100 milioni di vettori, Databricks riporta per lakebase_vector un throughput doppio rispetto al sistema immediatamente successivo e un costo quattro volte inferiore rispetto a un servizio cloud Postgres basato su pgvector, prima di considerare i risparmi aggiuntivi derivanti dall’autoscaling. Nello stesso test il sistema ha ottenuto un recall del 97% con latenza P99 di 71 millisecondi. Databricks cita inoltre l’implementazione di Conexiom, che utilizza ricerca ibrida BM25 su oltre 100 milioni di righe: rispetto alla precedente configurazione basata su pgvector, l’azienda avrebbe dimezzato il compute necessario, ridotto di tre volte i costi infrastrutturali e aumentato di cinque volte il throughput. Lakebase Search viene quindi posizionato per i casi nei quali si vuole mantenere nello stesso database sia il dato operativo sia quello destinato alla ricerca, mentre Databricks AI Search continua a essere proposto come motore gestito per chi preferisce una soluzione di retrieval già configurata. Gli utenti Lakebase possono abilitare le nuove funzionalità dalle impostazioni del progetto e installare le due estensioni direttamente in Postgres.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)