
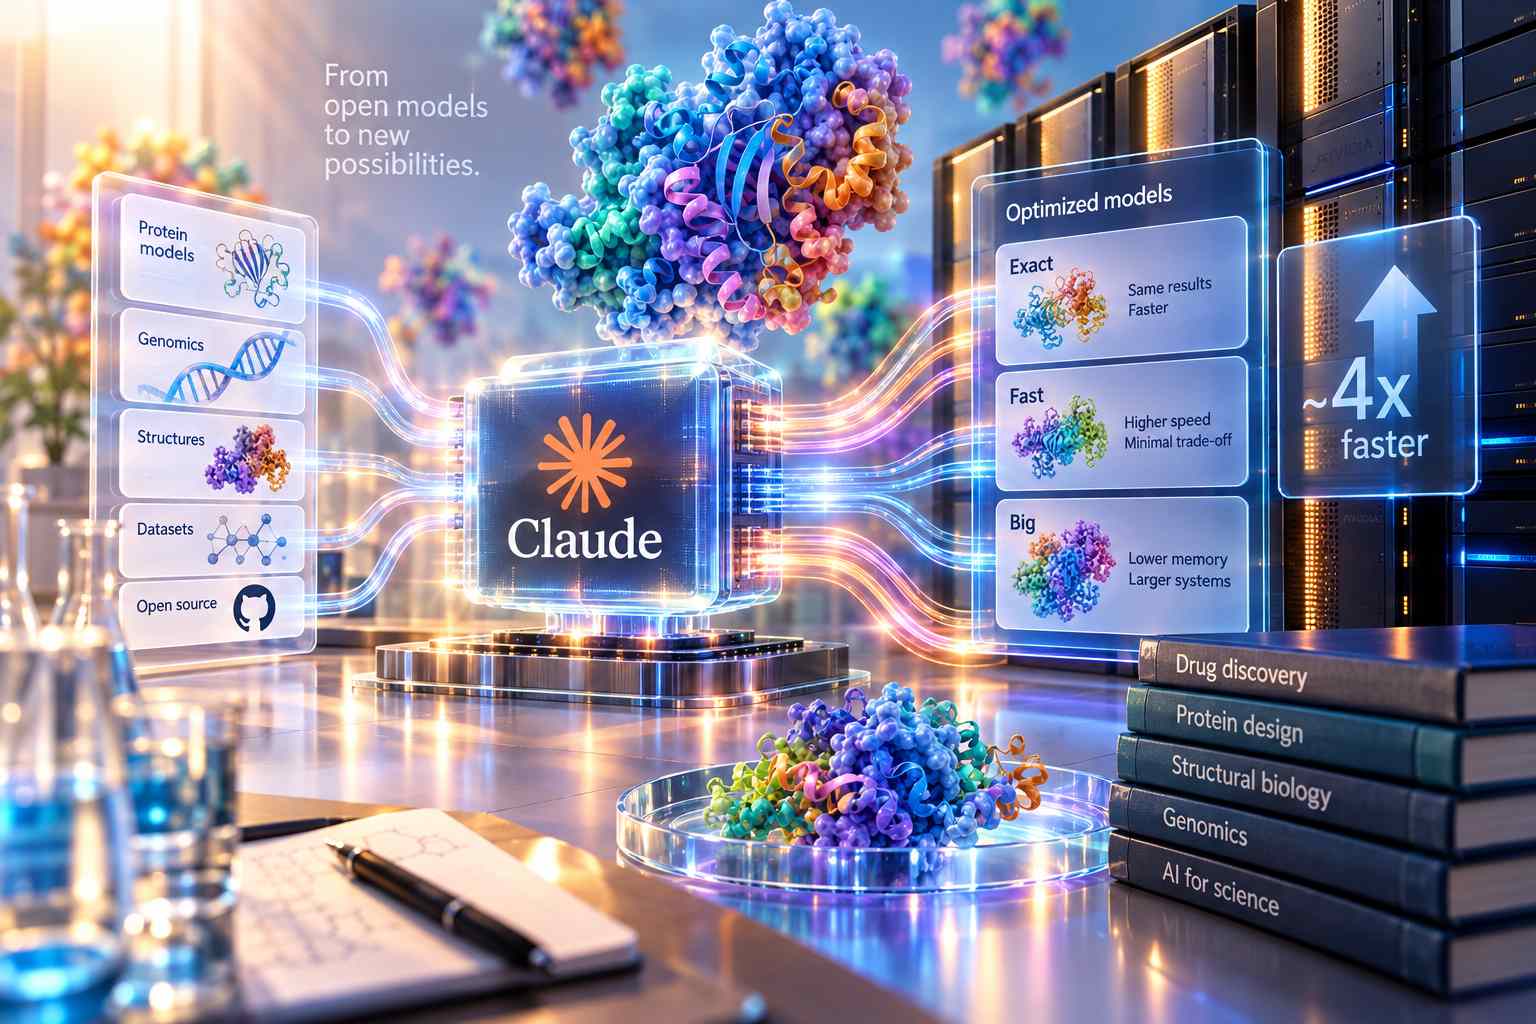
Anthropic ha pubblicato i risultati di un progetto nel quale Claude ha ottimizzato più di 30 modelli biomolecolari open source in poco meno di quattro settimane, ottenendo secondo l’azienda un’accelerazione media di circa quattro volte. Il lavoro ha prodotto 36 pacchetti di ottimizzazione distribuiti tra sei famiglie di modelli: 14 per co-folding e previsione strutturale, tre per hallucination, sei per generazione di strutture, tre per inverse folding, sette per genomica e tre per protein language model. Il codice ottimizzato è stato reso disponibile pubblicamente, insieme a un nuovo concorso di protein design organizzato con Adaptyv Bio.
Anthropic riferisce che il lavoro è stato supervisionato principalmente da due membri del proprio personale tecnico con esperienza nella modellazione biomolecolare, ma senza una specializzazione precedente nell’ottimizzazione dell’inferenza o nella programmazione di kernel GPU. Ogni pacchetto utilizza i pesi originali del modello e può offrire fino a tre modalità operative. Exact punta a riprodurre bit per bit gli output del modello non modificato, Fast sacrifica una piccola quantità di precisione numerica per aumentare la velocità e Big riduce l’impiego di memoria per consentire l’elaborazione di input più grandi sulla GPU.
Nei test condotti su GPU NVIDIA H100, la modalità Exact ha accelerato in media di 1,6 volte il forward pass di 14 modelli per la previsione delle strutture rispetto alle implementazioni originali. Fast, disponibile su 13 modelli, ha raggiunto un’accelerazione media di 4,1 volte, mentre Big ha ottenuto in media 3,4 volte. Per i singoli modelli di previsione strutturale, i guadagni in modalità Fast sono andati da 2,3 volte per OpenDDE fino a 6,4 volte per Chai-1. I modelli genomici e i protein language model hanno invece registrato miglioramenti compresi tra 1,2 e 5 volte già in modalità Exact.
Una parte consistente del lavoro ha riguardato i colli di bottiglia presenti nei modelli moderni di previsione strutturale come AlphaFold3, OpenFold3 e Boltz-2. Questi sistemi impiegano molto tempo di calcolo e memoria nelle operazioni di triangle attention e triangle multiplication, il cui costo cresce in modo cubico rispetto al numero di token. NVIDIA dispone già di kernel dedicati a queste operazioni attraverso cuEquivariance e BioNeMo Inference Runtime, ma Claude ha sviluppato un proprio insieme di kernel GPU chiamato FlashPairformer v1. Nei test su una singola H100, FlashPairformer v1 ha eseguito la triangle attention 2,7 volte più velocemente dei kernel di riferimento con pair width 128, utilizzato per esempio da AlphaFold3 e Boltz-2, e 2,9 volte più velocemente con pair width 256, impiegato da Protenix v2. Per la triangle multiplication i miglioramenti misurati sono stati rispettivamente di 1,7 e 3,2 volte.
Claude ha affiancato ai kernel condivisi anche ottimizzazioni specifiche per i singoli modelli. Tra gli interventi realizzati figurano la memorizzazione di risultati intermedi che il codice originale ricalcolava più volte, il constant folding di rami con output invariabili, l’impiego di CUDA Graph e la fusione di kernel. L’effetto delle ottimizzazioni è stato valutato anche sul benchmark FoldBench-Lite, che comprende 1.925 coppie modello-target distribuite su 13 configurazioni. La percentuale di interfacce previste in maniera accettabile è risultata pari al 54,8% con i modelli originali, al 55,0% con Exact, al 54,5% con Fast e al 54,2% con Big, senza variazioni aggregate statisticamente distinguibili da zero secondo il rapporto.
La modalità Big è stata sviluppata soprattutto per estendere la dimensione dei sistemi biomolecolari elaborabili. Anthropic riferisce che consente di modellare accuratamente sistemi superiori a 10.000 token, considerando aminoacidi, nucleotidi, atomi di piccole molecole e ioni, e di eseguire inferenze su sistemi che superano i 70.000 token utilizzando un singolo nodo GPU. Tra le strutture previste correttamente figurano il complesso I mitocondriale umano, il complesso chaperonico TRiC, un proteasoma e un ribosoma batterico 70S, con TM-score compresi tra 0,92 e 0,997 rispetto alle rispettive strutture sperimentali. Anthropic considera questi sistemi tra le strutture più grandi finora ripiegate accuratamente con modelli di structure prediction e osserva, per confronto, che il lavoro originale su AlphaFold3 evidenziava una previsione accurata del ribosoma 40S di 7.663 token, mentre il modello era stato addestrato su crop fino a 768 token.
Il progetto ha anche evidenziato i limiti dell’aumento della capacità computazionale. Per verificare fino a che punto potessero essere estese le ottimizzazioni, Claude ha provato a eseguire la previsione strutturale di interi capsidi virali e compartimenti proteici composti da circa 31.000 fino a oltre 70.000 residui, utilizzando un nodo con otto GPU B300. Tutte e sette le esecuzioni sono state completate, ma le strutture previste sono collassate in configurazioni compatte e non realistiche, con TM-score compresi tra 0,08 e 0,14 dove è stato possibile effettuare il confronto. Il rapporto attribuisce il problema probabilmente alla mancata generalizzazione dei modelli, poiché queste strutture risultano da 40 a 90 volte più grandi del massimo crop utilizzato per l’addestramento di AlphaFold3. L’ottimizzazione ha quindi ampliato ciò che è computazionalmente eseguibile, senza modificare ciò che il modello ha effettivamente appreso durante l’addestramento.
Anthropic ha inoltre ripetuto precedenti esperimenti di progettazione di protein binder utilizzando una configurazione molto più limitata. Nel lavoro precedente Claude operava a partire da un prompt di circa 16.000 parole, poteva utilizzare sub-agent e disponeva di un budget fino a 10.000 dollari per singolo target sull’infrastruttura Modal, corrispondente a circa 2.500 ore GPU H100 in 24 ore. Nel nuovo esperimento, un singolo modello Claude ha ricevuto una sola GPU NVIDIA H200, 24 ore di tempo, un prompt di circa 1.100 parole, nessun sub-agent e nessun intervento umano durante l’esecuzione. Sono stati testati Mythos 5.1, Mythos 5 e Opus 5 sui 16 target impiegati nello studio precedente.
Il punteggio mediano ipSAE, utilizzato come indicatore in silico della probabilità di binding, ha raggiunto 0,785 con Opus 5, 0,781 con Mythos 5.1 e 0,739 con Mythos 5, rispetto allo 0,749 ottenuto nelle precedenti campagne. Per il miglior design prodotto da ciascun sistema i punteggi sono stati rispettivamente 0,833, 0,825 e 0,813, contro 0,817 del lavoro precedente. Il nuovo approccio ha utilizzato un budget GPU circa cento volte inferiore e, secondo Anthropic, una spesa complessiva nell’ordine di 150 dollari tra GPU e token ha prodotto prestazioni in silico confrontabili con quelle delle campagne precedenti. I design ottenuti in questi test non sono però ancora stati sottoposti a verifica sperimentale e i risultati riportati sono esclusivamente computazionali.
Il codice è stato pubblicato in un repository GitHub che contiene 36 kit di ottimizzazione compatibili con altrettanti strumenti upstream. Il codice originale è distribuito con licenza Apache 2.0 e i pacchetti utilizzano una nomenclatura comune basata sulle modalità off, exact, fast e big. La configurazione principale è destinata a GPU NVIDIA H100 da 80 GB su Linux x86-64, mentre alcuni kit includono configurazioni anche per A100, H200, B200 e B300. Il repository viene descritto come una reference release non mantenuta e che non accetta contributi; immagini Docker e Apptainer precompilate sono previste successivamente al rilascio iniziale.
Il progetto è accompagnato da una competizione di protein design organizzata da Anthropic e Adaptyv Bio intorno a cinque problemi considerati al limite delle capacità attuali del settore, tra cui cross-reattività tra specie, sensibilità al pH, specificità peptide-MHC e target difficili come i GPCR. Le due organizzazioni mettono a disposizione un milione di dollari in validazione sperimentale per testare oltre 5.000 design proteici nel laboratorio automatizzato di Adaptyv Bio senza costi per i partecipanti, mentre Anthropic aggiunge un altro milione di dollari in crediti Claude. Modal contribuirà con fino a 250.000 dollari in crediti di calcolo e Twist Bioscience fornirà il DNA necessario agli esperimenti.
La competizione prevede tre modalità di partecipazione. Laboratori di ricerca e aziende possono concorrere per ottenere fino a 50.000 dollari in crediti Claude per i team accademici e fino a 25.000 dollari per quelli industriali; saranno selezionati circa 20 gruppi e verrà riservata la validazione sperimentale di circa 18 design per ciascuna sfida. Ricercatori individuali o team composti da un massimo di tre persone potranno invece ricevere accesso gratuito a Claude Max 20x durante la competizione, mentre una terza modalità open consente di partecipare con risorse proprie e senza l’obbligo di utilizzare Claude. Le candidature sono aperte dal 16 al 24 settembre 2026, con selezione dei team entro il 28 settembre. Le cinque sfide settimanali si svolgeranno dal 28 settembre al 31 ottobre, la validazione sperimentale dovrebbe concludersi entro il 30 novembre e i risultati sono previsti su Proteinbase il 15 dicembre 2026.
Tra i limiti dichiarati, Anthropic precisa che le misurazioni principali sono state condotte esclusivamente su GPU H100, che le accelerazioni relative a ColabFold sono state confrontate con la versione 1.6.1 precedente all’introduzione dei kernel fusi sviluppati successivamente dallo stesso progetto e che le modalità Exact e Fast possono richiedere fino a 3,2 volte più memoria rispetto alle implementazioni predefinite.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)