
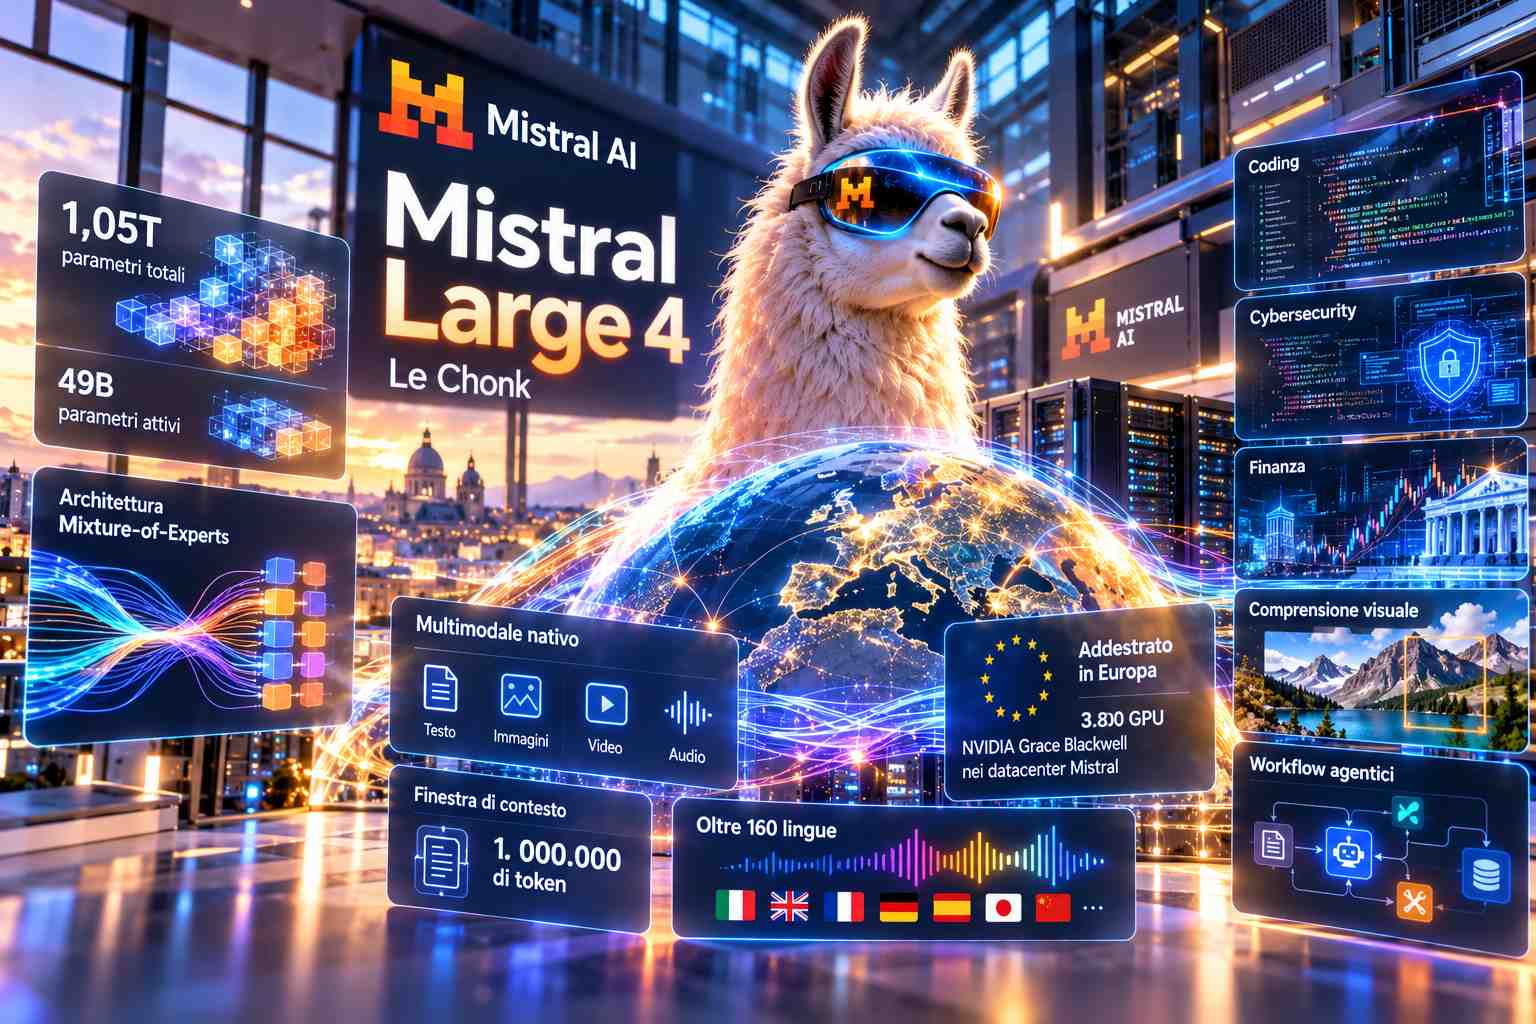
Mistral AI ha presentato Mistral Large 4, soprannominato “Le Chonk”, un nuovo modello multimodale general-purpose basato su un’architettura Mixture-of-Experts granulare con 1,05 trilioni di parametri complessivi e 49 miliardi di parametri attivi per ogni inferenza. Il modello è disponibile dal 6 ottobre 2026 in anteprima pubblica attraverso l’API di Mistral con identificatore mistral-large-4, mentre il rilascio dei pesi è previsto per il 26 ottobre. Large 4 viene proposto come modello ibrido capace di combinare instruction following, reasoning e comportamento agentico all’interno dello stesso sistema, con supporto nativo agli input multimodali e una finestra di contesto di un milione di token. L’architettura comprende inoltre un vision encoder da 1,6 miliardi di parametri, mentre il supporto linguistico copre oltre 160 lingue. Mistral lo posiziona come il proprio modello più grande e capace sviluppato finora e come base di una nuova generazione di modelli specializzati e ottimizzati che verranno costruiti successivamente sulla stessa architettura.
La scelta di una struttura Mixture-of-Experts permette di separare la dimensione totale del modello dal numero di parametri effettivamente attivati durante l’elaborazione: Large 4 dispone infatti di oltre un trilione di parametri, ma ne utilizza circa 49 miliardi per ciascun passaggio, mantenendo quindi una capacità complessiva molto elevata senza sostenere a ogni inferenza il costo computazionale dell’intera rete. Mistral descrive il modello come nativamente multimodale e orientato in particolare a coding, workflow agentici, comprensione visuale e applicazioni enterprise complesse, includendo settori come cybersecurity, finanza, diritto e manifattura. Secondo i benchmark pubblicati dalla società, Large 4 si colloca tra i modelli open-weight più performanti disponibili e supera nettamente, nelle valutazioni aggregate utilizzate da Mistral, gli altri modelli open-weight sviluppati in Europa e negli Stati Uniti. La società rivendica inoltre prestazioni state-of-the-art tra i modelli aperti in diversi workload verticali e risultati particolarmente elevati nel visual grounding, dove Large 4 arriverebbe in alcuni test a superare anche modelli frontier closed-weight. Il modello è ancora in una fase di sviluppo attiva: il reinforcement learning utilizzato per l’attuale anteprima non è concluso e Mistral afferma che le curve di miglioramento non mostrano ancora segnali di saturazione.
Una delle aree sulle quali Mistral ha concentrato maggiormente la valutazione è la cybersecurity. Large 4 figura tra i primi cinque modelli nell’Artificial Analysis Cyber Index, benchmark indipendente che misura la capacità dei sistemi AI di individuare e correggere vulnerabilità all’interno di software reale, e Mistral lo indica come il modello open-weight sviluppato al di fuori della Cina con le prestazioni più elevate in questa categoria. In uno dei test dell’indice, che richiede di riprodurre una vulnerabilità reale presente in un progetto open source e successivamente svilupparne la correzione, il modello raggiunge un punteggio dell’82%, indicato come il risultato più elevato tra i modelli valutati; su Cybench, benchmark composto da 40 esercizi derivati da competizioni di sicurezza informatica, Large 4 risolve invece il 93% delle prove. Durante il periodo di anteprima pubblica Mistral sta inoltre effettuando attività di red teaming del modello in scenari reali con aziende specializzate nella cybersecurity, partner verificati e autorità statali. Parallelamente alla versione pubblica è stata aperta un’anteprima privata nella quale questi soggetti possono accedere a endpoint con moderazione ridotta e capacità cyber ampliate e, in alcuni casi, anche ai pesi dell’attuale versione preview, con l’obiettivo di valutare in modo più approfondito rischi, comportamento e capacità prima del rilascio open-weight generale.
Large 4 è stato addestrato interamente sull’infrastruttura europea di Mistral utilizzando 3.800 GPU NVIDIA Grace Blackwell installate nei datacenter proprietari della società, e la stessa infrastruttura viene utilizzata per servire l’anteprima pubblica del modello. Questo elemento viene collegato direttamente da Mistral alla propria strategia di sovranità tecnologica europea: l’azienda punta infatti a offrire modelli frontier open-weight addestrati e distribuibili in Europa, mantenendo sotto il proprio controllo infrastruttura, training e serving. Il modello può essere distribuito tramite Mistral Cloud e rappresenta uno dei primi risultati concreti dell’espansione infrastrutturale finanziata dal round Series D da 3 miliardi di euro annunciato dalla società, indicato come il più grande round azionario mai raccolto da una società tecnologica europea. Parte del capitale viene utilizzata per incrementare ulteriormente la capacità computazionale dei datacenter europei, con l’obiettivo di proseguire il training di Large 4 e sviluppare successivamente modelli derivati specializzati per settori e workload specifici. Mistral prevede inoltre di pubblicare insieme ai pesi maggiori dettagli sull’architettura, sulla metodologia di post-training e su ulteriori benchmark che non sono ancora stati resi disponibili durante la fase iniziale di preview.
Sul piano operativo, la documentazione di Mistral indica per Large 4 il supporto a structured output, function calling, Document Q&A, prefix completion, chat completions, elaborazione batch, agenti, conversazioni e strumenti integrati attraverso gli endpoint della piattaforma. La finestra di contesto di un milione di token rende il modello adatto anche a workflow che richiedono l’elaborazione di grandi quantità di codice, documentazione o dati multimodali nello stesso contesto, mentre l’integrazione degli endpoint agentici permette di costruire sistemi che combinano ragionamento, uso di strumenti e gestione di conversazioni persistenti. La pagina API riporta per l’anteprima un prezzo standard di 1,36 dollari per milione di token di input e 4,18 dollari per milione di token di output, con una tariffa promozionale indicata attualmente a 0,68 dollari per milione di token in ingresso, 0,07 dollari per milione di token di input memorizzati nella cache e 2,09 dollari per milione di token in uscita. Il modello è classificato nella documentazione come Public Preview, Open, versione 26.10, mentre i pesi non risultano ancora pubblicati nei repository ufficiali di Mistral e saranno resi disponibili soltanto al termine della fase di anteprima.
Mistral Large 4 assume così il ruolo di modello general-purpose principale all’interno della gamma della società, affiancandosi alle famiglie specialistiche dedicate a coding, audio e altre applicazioni verticali e sostituendo progressivamente Large 3 come riferimento per i workload più impegnativi. Mistral distingue infatti la propria offerta tra modelli general-purpose destinati a reasoning, linguaggio, programmazione e comprensione multimodale e modelli specialistici ottimizzati per singoli domini o compiti; Large 4 viene posizionato al vertice della prima categoria e sarà utilizzato come fondazione per modelli successivi derivati dallo stesso training. La società ha mostrato il modello attraverso demo dedicate a deep financial research, CTF speedrun, visual intelligence e malware triage, cioè scenari pensati per evidenziare rispettivamente capacità agentiche su dati finanziari, ragionamento operativo in cybersecurity, comprensione visuale e analisi di codice malevolo. L’anteprima pubblica serve quindi contemporaneamente come fase di accesso per sviluppatori e clienti e come periodo di valutazione prima della pubblicazione dei pesi, con Mistral che continuerà nelle prossime settimane sia il reinforcement learning sia l’espansione dell’infrastruttura di calcolo su cui verranno addestrate le successive versioni del modello.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)