
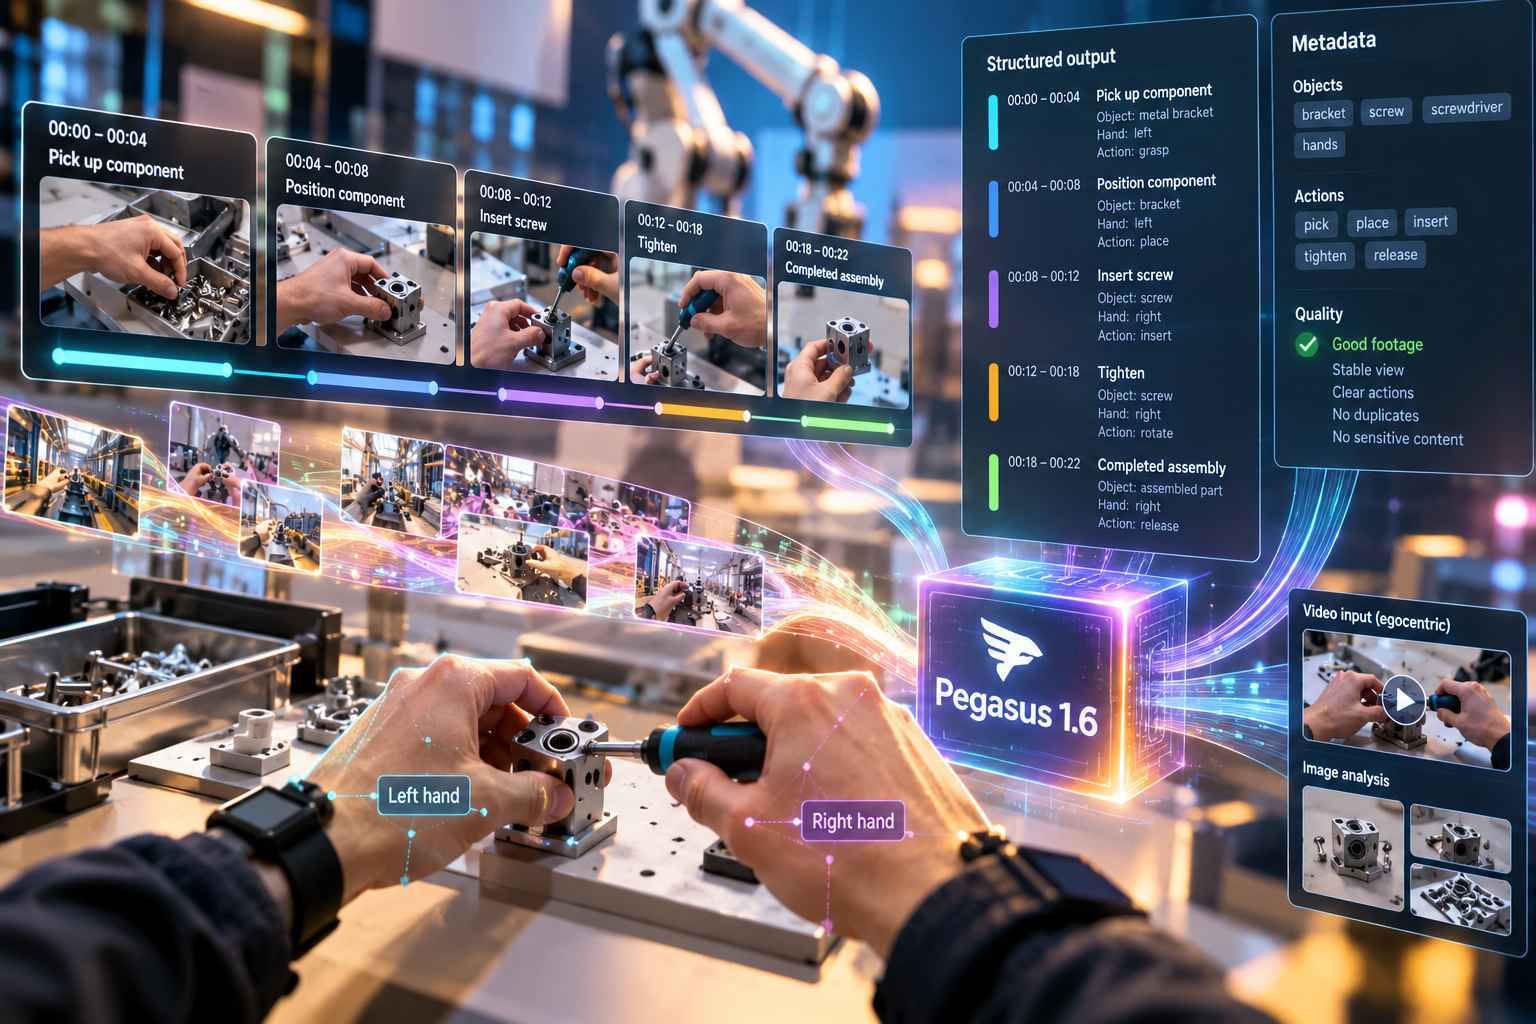
TwelveLabs ha presentato Pegasus 1.6, nuova versione del proprio modello video-to-text e di segmentazione progettata per trasformare video grezzi in descrizioni strutturate, metadati temporali e annotazioni utilizzabili nei processi di addestramento, introducendo per la prima volta un supporto specifico ai video egocentrici, cioè alle riprese effettuate dal punto di vista della persona o della macchina che sta eseguendo un’attività. La nuova capacità è rivolta in particolare agli sviluppatori di sistemi robotici e ai fornitori di dati per il training, che possono utilizzare filmati realizzati con wearable camera, body camera, telecamere installate sui robot o sistemi di teleoperazione per ricostruire quali azioni vengono eseguite, quali oggetti sono coinvolti, quale mano compie un determinato gesto e quando ogni azione inizia e termina. Pegasus 1.5 disponeva già di funzioni per dividere i filmati in segmenti temporali e produrre descrizioni strutturate, ma TwelveLabs riconosce che le versioni precedenti gestivano con difficoltà il punto di vista in prima persona; Pegasus 1.6 è stato quindi addestrato specificamente anche su questa tipologia di contenuti. Il modello continua a essere costruito attorno a un approccio video-native, orientato alla comprensione della successione temporale degli eventi e delle relazioni causa-effetto, invece di trattare il video semplicemente come una serie di fotogrammi indipendenti sui quali applicare capacità visuali derivate da modelli multimodali general-purpose.
L’utilizzo dei video in prima persona permette di affrontare un problema particolarmente importante nella raccolta dei dati per la robotica. Le dimostrazioni ottenute attraverso teleoperazione sono molto utili perché registrano direttamente il comportamento richiesto a una macchina, ma richiedono contemporaneamente la disponibilità di un robot, di infrastruttura e di un operatore qualificato e diventano quindi costose quando devono essere raccolte su larga scala. Le riprese egocentriche di esseri umani che eseguono normalmente le stesse attività possono invece fornire una quantità molto maggiore di esempi comportamentali senza richiedere che ogni dimostrazione venga effettuata direttamente su un robot. Il problema si sposta però sulla trasformazione di questi filmati in materiale strutturato abbastanza precisamente da poter entrare in una pipeline di training. Pegasus 1.6 può suddividere le registrazioni in azioni timestamped, produrre caption dettagliate, verificare la qualità dei filmati, individuare eventi insoliti e duplicati e segnalare contenuti potenzialmente sensibili prima dell’utilizzo downstream. I controlli di qualità possono rilevare visuali ostruite, movimenti instabili della telecamera e azioni poco chiare, mentre gli output possono essere adattati alla tassonomia scelta dal cliente: per un’attività di assemblaggio, per esempio, un team può richiedere segmenti distinti per il prelievo di un componente, il suo posizionamento e il successivo fissaggio e ottenere contemporaneamente informazioni sul ruolo svolto dalle due mani. TwelveLabs riassume questo workflow in tre fasi, nelle quali il modello identifica task, step, oggetti e interazioni mano-oggetto, valuta se il filmato possiede qualità sufficiente e restituisce infine output temporalmente strutturati pronti per revisione e utilizzo nelle pipeline successive.
Pegasus 1.6 introduce inoltre una serie di miglioramenti che vanno oltre la robotica. Il modello riconosce con maggiore coerenza persone, personaggi e oggetti presenti nelle scene rispetto a Pegasus 1.5 e aggiunge l’analisi nativa delle immagini statiche, che possono ora essere inviate attraverso la stessa API utilizzata per i video in gruppi compresi tra una e venti immagini per richiesta. È stata migliorata anche l’estrazione dei metadati, rendendola meno dipendente dalle singole definizioni utilizzate nella segmentazione e permettendo quindi di ottenere campi più ricchi da una singola analisi. Quando viene utilizzata la video segmentation, Pegasus 1.6 può inoltre restituire eventi timestamped all’interno di ciascun segmento, anziché limitarsi alla descrizione generale del blocco temporale, e può segmentare video lunghi senza interrompere il processo per il raggiungimento del limite di token, restituendo i segmenti già prodotti anche quando l’output complessivo non può essere completato in un’unica risposta. Il modello utilizza una context window di 261.120 token; per i video accetta file fino a 10 GB con risoluzioni comprese tra 360×360 e 5184×2160 pixel e consente normalmente di analizzare fino a due ore di contenuto, oppure di utilizzare file lunghi fino a quattro ore quando viene selezionata soltanto una porzione da analizzare. Per le immagini sono supportati JPEG, PNG, WebP, GIF e BMP fino a 20 MB per singolo file e a un massimo di 16.777.216 pixel. L’inglese dispone di supporto completo, mentre arabo, cinese, francese, tedesco, italiano, giapponese, coreano, portoghese, russo, spagnolo, thailandese e vietnamita sono supportati parzialmente per comprensione visuale e audio, prompt e generazione degli output.
TwelveLabs colloca il nuovo modello principalmente nella parte della pipeline dedicata alla preparazione dei dati e non nella generazione diretta delle azioni dei robot. Pegasus può descrivere i movimenti degli arti, riconoscere le azioni e fornire una rappresentazione approssimativa delle traiettorie, ma il video non contiene necessariamente tutte le informazioni necessarie affinché una macchina possa riprodurre fisicamente lo stesso comportamento. Pressione esercitata, forza, contatto tattile, feedback dei sensori e controllo motorio preciso rimangono problemi distinti che devono essere risolti combinando le annotazioni video con altre fonti di dati e con modelli specificamente dedicati all’esecuzione. L’ipotesi di TwelveLabs è che le registrazioni delle attività umane possano offrire una base molto ampia di conoscenza comportamentale e che le dimostrazioni ottenute attraverso teleoperazione possano successivamente essere utilizzate per adattare queste informazioni alle caratteristiche dei singoli robot. La società ha condotto valutazioni interne sull’identificazione delle azioni, sul riconoscimento della mano utilizzata e sulla comprensione della progressione temporale delle attività, ma non ha pubblicato punteggi numerici né confronti riproducibili con modelli concorrenti. Il CEO e cofondatore Jae Lee ha inoltre riferito di un’elaborazione sperimentale equivalente a circa 17 anni di filmati in prima persona completata in approssimativamente 18 ore senza errori sui video, ma non sono stati specificati né l’hardware utilizzato né le condizioni del test e il dato deve quindi essere considerato un’indicazione della capacità di throughput dichiarata dalla società, non un benchmark riproducibile.
Nel mercato della preparazione dei dati per la robotica, Pegasus 1.6 si colloca accanto a tecnologie che affrontano parti differenti dello stesso processo. NVIDIA Cosmos Curator fornisce strumenti open source per filtraggio, annotazione e deduplicazione dei dataset video, mentre Encord utilizza Cosmos Reason 2 ed Embed per generare annotazioni preliminari sottoposte successivamente alla revisione umana e per effettuare ricerche nei video in base alle azioni rappresentate. Google Gemini Robotics ER 2 utilizza invece comprensione visuale e video soprattutto per ragionare sullo stato di un’attività, pianificare i passaggi successivi e coordinare strumenti, affidando l’esecuzione motoria a modelli o interfacce robotiche di livello inferiore. FLUX-mimic, sviluppato da Black Forest Labs e mimic e già sperimentato anche in applicazioni industriali di manipolazione presso Audi, parte invece da rappresentazioni derivate dal video per produrre direttamente azioni robotiche. TwelveLabs occupa quindi una posizione differente: Pegasus 1.6 non controlla il robot, ma prepara e struttura il materiale visivo che può essere successivamente utilizzato dai sistemi che apprendono o generano quelle azioni. La stessa piattaforma può inoltre essere utilizzata per individuare automaticamente filmati poco utili, duplicati o contenenti informazioni sensibili prima che entrino nel dataset, una fase importante quando la raccolta viene effettuata su grandi quantità di video provenienti da fabbriche, magazzini o altri ambienti di lavoro reali.
Pegasus 1.6 viene offerto come servizio API con un prezzo pubblico di 1,75 dollari per ora di video elaborata, 3 dollari per milione di token di input provenienti dalle immagini e 7,50 dollari per milione di token generati in output, mentre i contratti enterprise e le distribuzioni private o self-managed prevedono condizioni personalizzate. Al solo prezzo dell’input video, l’elaborazione una tantum di 1.000 ore di registrazioni corrisponde quindi a 1.750 dollari prima di considerare gli output e gli altri eventuali costi. Nelle richieste di segmentazione la tariffazione tiene però conto anche del numero di definizioni richieste: la durata fatturabile del video viene moltiplicata per ciascuna segment definition, per cui domandare contemporaneamente diverse categorie di annotazioni può aumentare sensibilmente il costo della stessa registrazione. TwelveLabs sta inoltre valutando un numero limitato di accordi più estesi di licensing e ricerca personalizzata con grandi partner. Per gli utilizzatori, il parametro rilevante non è quindi soltanto la quantità di video processata, ma quanta parte delle annotazioni prodotte risulti effettivamente utilizzabile dopo la revisione e quanto quel materiale contribuisca al miglioramento del sistema robotico successivo: Pegasus 1.6 automatizza soprattutto il passaggio tra la registrazione di un’attività e la produzione di dati strutturati da cui un sistema può apprendere, mentre la validazione dell’efficacia finale rimane legata al comportamento del robot addestrato con quei dati.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)