
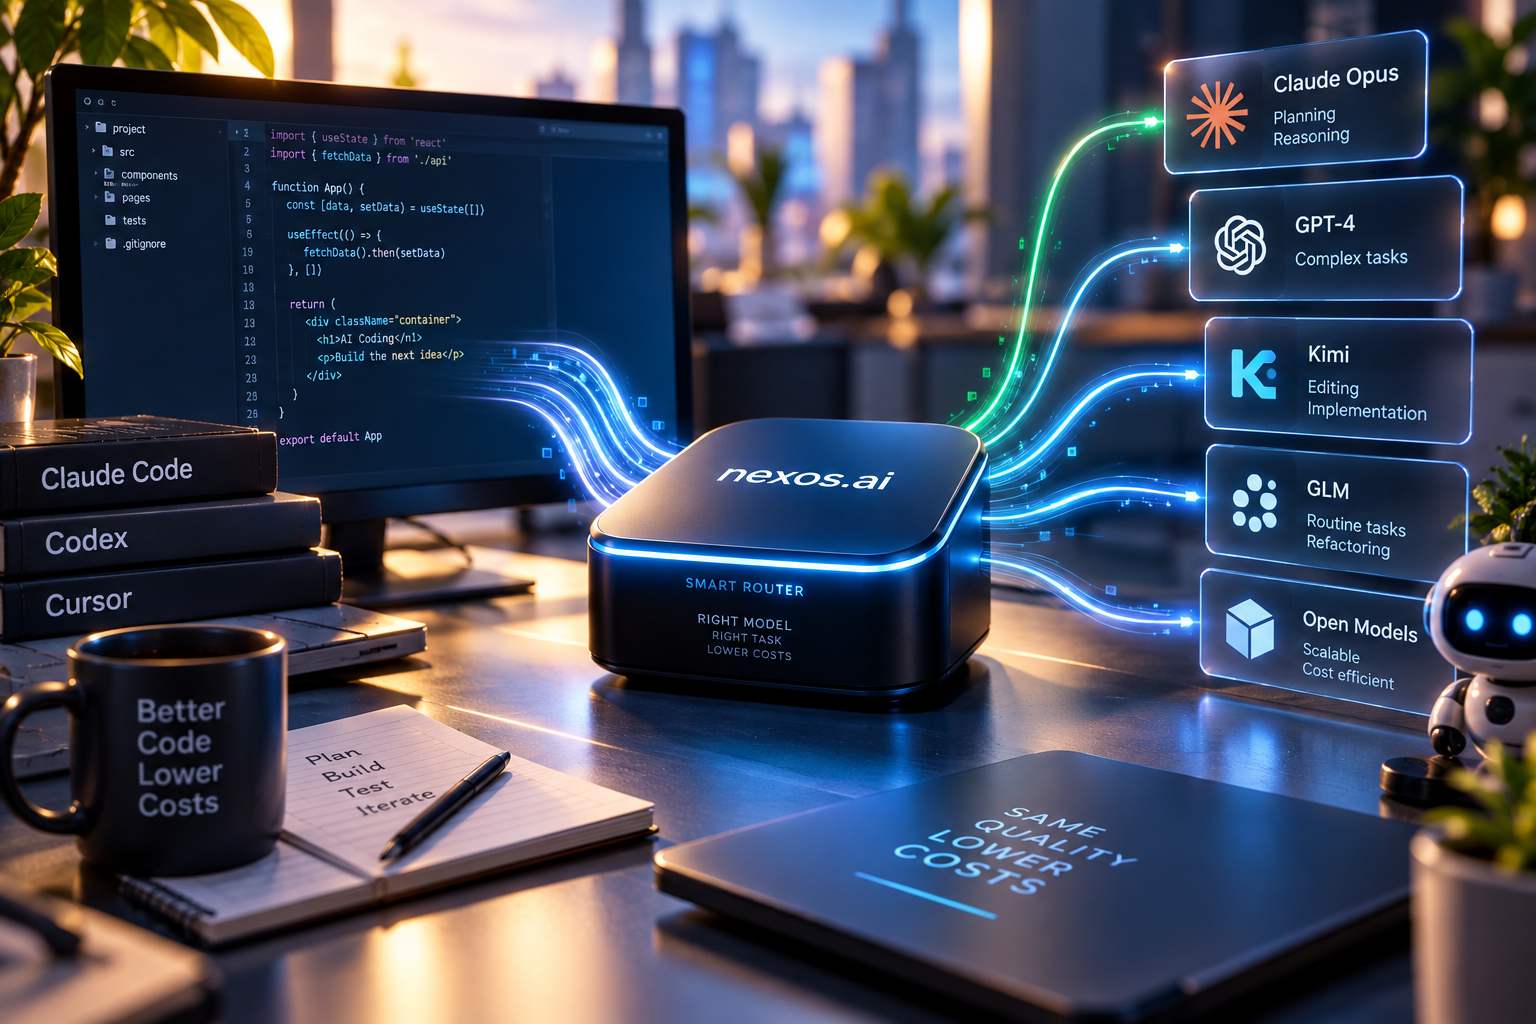
nexos.ai ha introdotto uno smart router progettato per ridurre il costo operativo degli agenti AI dedicati alla programmazione, assegnando automaticamente ogni attività al modello con il rapporto più adatto tra costo e capacità. Il sistema parte dal problema generato dalla diffusione degli agenti autonomi di coding, che possono produrre grandi quantità di traffico AI in background e decidere autonomamente quale modello richiamare e in quale momento. Strumenti come Claude Code, Codex e Cursor possono quindi generare consumi difficili da ottimizzare semplicemente sostituendo un modello costoso con uno più economico, perché le diverse fasi di una stessa sessione possono richiedere livelli di capacità molto differenti. Lo smart router di nexos.ai mantiene invece i modelli frontier per le attività che richiedono maggiore capacità di ragionamento e sposta le operazioni più routinarie verso modelli meno costosi.
Il funzionamento del sistema deriva da un metodo sviluppato da nexos.ai e denominato Mirror benchmarking. A differenza dei benchmark pubblici tradizionali, che confrontano i modelli su attività statiche e predefinite, il Mirror benchmarking analizza continuamente il traffico di produzione reale a livello di singola sessione. La piattaforma osserva come una sessione cresce nel tempo, dove vengono generati i costi e in quali circostanze si verificano errori o degradazioni delle prestazioni, ricavando così un quadro del rapporto tra costo e qualità basato sul comportamento effettivo dei workload dei clienti. nexos.ai utilizza inoltre la propria piattaforma per confrontare continuamente nuovi modelli, prestazioni e workflow, e queste informazioni vengono impiegate per determinare in tempo reale quale modello utilizzare nelle diverse fasi del lavoro.
Nei test di produzione condotti dall’azienda, il router ha mantenuto la separazione tra le categorie di attività che gli stessi agenti di coding tendono già a distinguere internamente. Circa il 16% delle richieste è stato classificato come attività di Planning e indirizzato verso modelli frontier di reasoning, come Claude Opus, incaricati di stabilire cosa realizzare e quale strategia adottare. Il restante 84% è stato invece associato ad attività di Editing, come applicazione di diff, modifica dei file e implementazione di un piano già definito, e instradato verso modelli open-weight più economici come Kimi o GLM. L’obiettivo non è quindi sostituire completamente i modelli più costosi, ma limitarne l’utilizzo ai passaggi nei quali le loro capacità possono effettivamente modificare la qualità del risultato.
Secondo i dati riportati da nexos.ai, su uno dei workload testati questa impostazione ha ridotto i costi del 59,2%, producendo un risparmio superiore a 5.400 dollari rispetto a un traffico che, utilizzando esclusivamente modelli frontier, avrebbe superato i 9.200 dollari. In un secondo test la riduzione è stata del 60,4%. L’azienda afferma che la qualità del processo è rimasta invariata perché le decisioni principali hanno continuato a essere affidate al modello frontier, mentre i modelli meno costosi hanno eseguito prevalentemente operazioni definite durante la precedente fase di pianificazione.
Lo smart router interviene sulle richieste senza modificarne il contenuto e cambia modello soltanto nei punti naturali di separazione della sessione. Questa impostazione è stata scelta anche per mantenere quanto più possibile intatta la cache associata al contesto, evitando ricostruzioni che aumenterebbero nuovamente il consumo di token e quindi i costi. Il router diventa così uno strato decisionale intermedio tra l’agente di coding e i diversi modelli disponibili, stabilendo di volta in volta quale backend utilizzare senza richiedere cambiamenti nel normale workflow dello sviluppatore.
L’impiego di modelli open-weight per l’84% delle richieste considerate nei test ha inoltre l’effetto di ridurre la dipendenza da un singolo fornitore di modelli AI. La piattaforma può spostare le componenti del workload che non necessitano di un modello frontier verso differenti alternative disponibili sul mercato, mentre i modelli più avanzati rimangono utilizzati per le operazioni nelle quali le loro capacità giustificano il maggiore costo. Con questa architettura, nexos.ai punta quindi a trasformare la selezione del modello da una scelta fissa effettuata a monte in una decisione dinamica effettuata durante l’esecuzione delle sessioni di coding.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)