
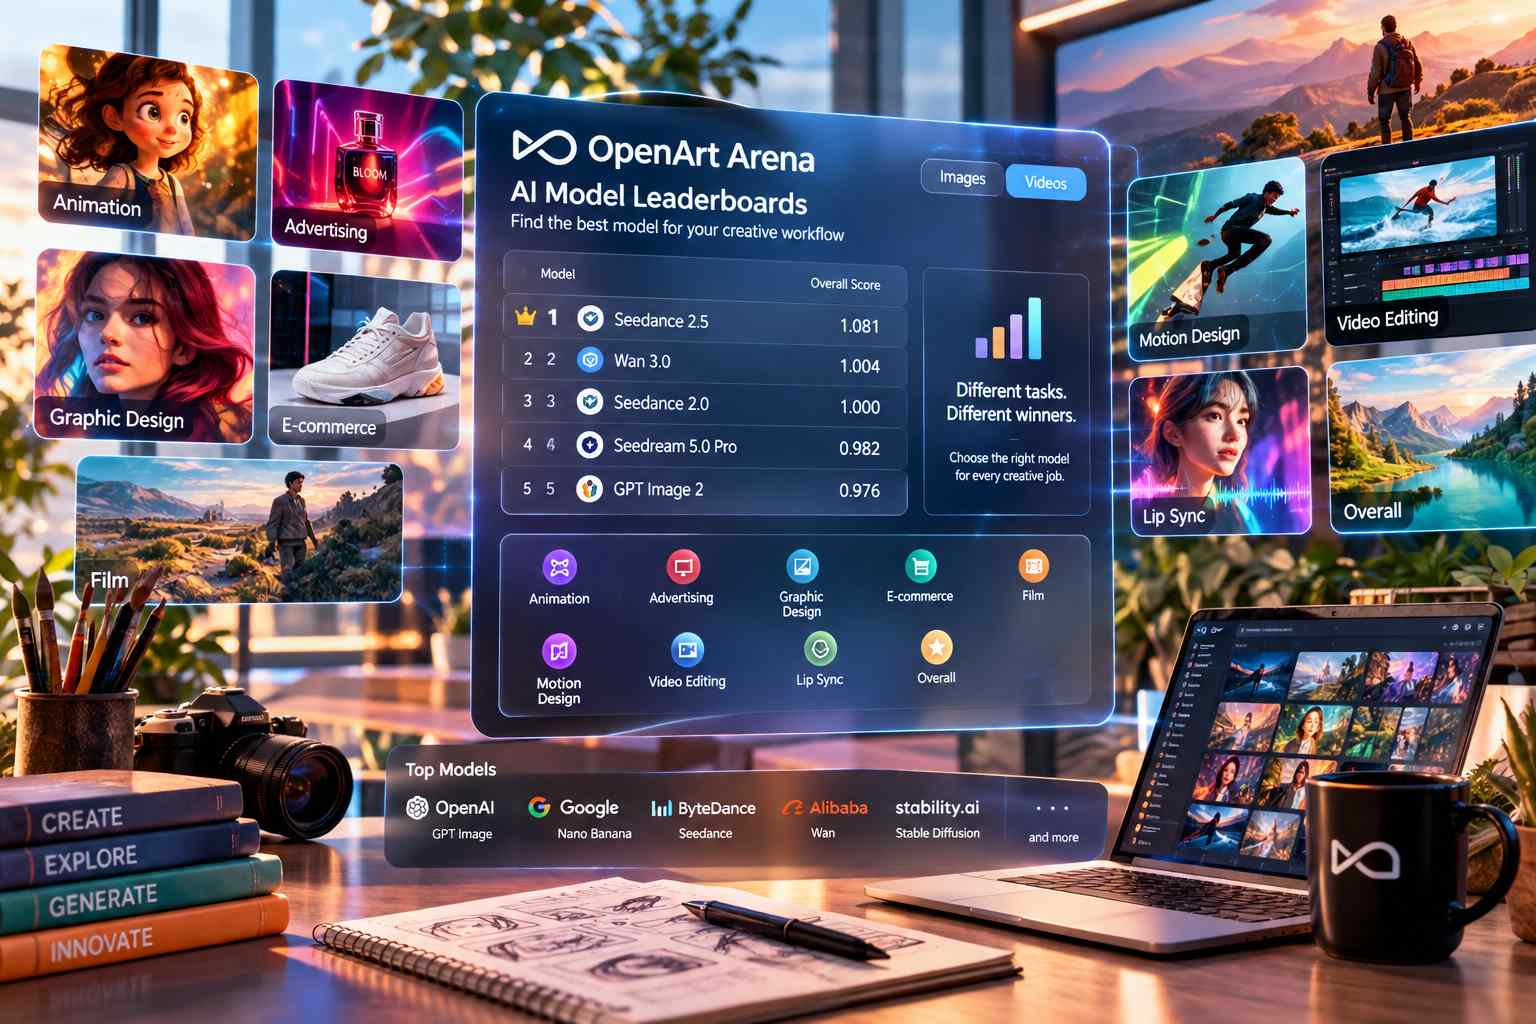
OpenArt ha lanciato OpenArt Arena, un benchmark pubblico dedicato ai modelli di generazione immagini e video che organizza le classifiche in base al lavoro creativo da svolgere invece di limitarsi a un singolo punteggio generale. Le categorie comprendono animazione, advertising, graphic design, e-commerce, film, motion design, video editing, lip sync e classifiche complessive, con l’obiettivo di aiutare creator e aziende a individuare il modello più adatto a uno specifico workflow tra sistemi come GPT Image, Nano Banana, Seedream, Seedance, Wan, Grok Imagine e altri modelli disponibili sul mercato. OpenArt prevede inoltre di integrare Arena direttamente nella propria piattaforma creativa, dove gli utenti possono già utilizzare più di 100 modelli di terze parti per immagini, video, audio e contenuti 3D.
Ogni leaderboard utilizza un set di prompt costruito specificamente per il relativo ambito professionale e criteri di valutazione adattati al tipo di lavoro. Nel filmmaking vengono considerate caratteristiche come movimento della camera, illuminazione, resa cinematografica e realismo della pelle, mentre nei workflow pubblicitari acquistano maggiore peso leggibilità del testo, correttezza dei loghi, fedeltà del prodotto e precisione del posizionamento. L’obiettivo è evitare che un modello molto forte in una determinata area venga automaticamente considerato migliore anche in compiti con requisiti differenti, permettendo per esempio a un team marketing, a uno studio di previsualizzazione e a un reparto di post-produzione di scegliere modelli diversi pur lavorando tutti con contenuti generativi.
I risultati vengono valutati senza mostrare ai giudici quale modello abbia generato ciascun output. Le immagini e i video sono presentati a coppie e i valutatori scelgono la versione preferita; OpenArt aggrega quindi i confronti attraverso il modello statistico Bradley-Terry, utilizzato per stimare la probabilità relativa che un sistema prevalga negli scontri diretti. Il panel è strutturato su due livelli: un Creative Expert Council composto da professionisti identificati, tra cui il regista di animazione vincitore di Emmy William Lau, il creative technologist Willonius “King Willonius” Hatcher e il marketing executive David Shing, e un gruppo più ampio di circa 800-1.000 “tastemaker” selezionati tra utenti OpenArt, professionisti e membri di comunità creative esterne. OpenArt pubblica parte della metodologia e dei prompt utilizzati, mantenendo però privato una porzione del set attivo per ridurre il rischio che i modelli vengano ottimizzati specificamente sul benchmark.
Nelle classifiche video iniziali, ByteDance Seedance 2.5 occupa la prima posizione assoluta con un punteggio di 1.081, davanti ad Alibaba Wan 3.0 con 1.004 e Seedance 2.0 con 1.000. Seedance 2.5 guida quattro delle cinque classifiche video rese disponibili al lancio: è primo nel film con 1.049, davanti a Seedance 2.0 a 1.000 e Wan 3.0 a 958, e nel motion design con 1.059, seguito ancora da Seedance 2.0 e Wan 3.0. Il risultato complessivo mostra quindi una forte consistenza del modello ByteDance nei diversi workflow video, pur senza una vittoria assoluta in ogni categoria.
La principale eccezione è il video editing, dove Wan 3.0 raggiunge 1.034 punti contro i 1.033 di Seedance 2.5 e i 1.021 di Gemini Omni Flash. La differenza tra i primi due modelli è tuttavia minima e OpenArt visualizza intervalli di confidenza al 95%, per cui uno scarto di un solo punto non deve essere interpretato come una differenza qualitativa significativa. Seedance 2.5 torna invece in testa nel lip sync con 1.063, davanti a Seedance 2.0 a 1.000 e Seedance 2.0 Mini a 994. La distribuzione dei risultati viene utilizzata da OpenArt proprio per mostrare che un team creativo può avere convenienza a instradare attività differenti verso modelli diversi invece di standardizzare l’intera produzione su un unico sistema.
Le classifiche relative alle immagini risultano più frammentate. GPT Image 2 di OpenAI si posiziona al primo posto sia nel graphic design sia nell’image editing, in entrambi i casi con un punteggio di 1.000. Nelle immagini orientate al film, invece, Seedream 5.0 Pro raggiunge 1.014, davanti a Nano Banana Pro, corrispondente a Gemini 3 Pro Image, e GPT Image 2, entrambi a 1.000. Seedream 5.0 Pro guida anche l’e-commerce con 1.004 punti, seguito da GPT Image 2 con 1.000 e Nano Banana 2, basato su Gemini 3.1 Flash Image, con 993. Nella classifica immagini complessiva Seedream 5.0 Pro è primo con 1.010 punti, dieci punti sopra GPT Image 2; questa graduatoria dovrà però essere aggiornata per includere GPT-Images-2.5, introdotto da OpenAI dopo la raccolta dei risultati iniziali.
Anche il grado di apertura dei modelli costituisce un elemento rilevante nella lettura delle classifiche. Seedance 2.5 e Seedance 2.0 sono modelli proprietari distribuiti tramite API, così come Gemini Omni Flash, GPT Image e le varianti Nano Banana. Wan 3.0 viene invece presentato da Alibaba come open source ed è associato a un repository con licenza Apache 2.0, ma il repository pubblico non include ancora i pesi scaricabili necessari per considerarlo a tutti gli effetti un modello open-weight utilizzabile in self-hosting. Per le aziende questa distinzione influisce su controllo del deployment, residenza dei dati, possibilità di personalizzazione, dipendenza dal provider e costo totale di esercizio.
OpenArt Arena si inserisce in un panorama nel quale esistono già benchmark orientati a categorie specifiche. Contra Labs utilizza il proprio Human Creativity Benchmark con professionisti creativi, brief reali e valutazioni blind pairwise organizzate anche per fasi come ideazione, mockup e refinement; Arena.ai costruisce classifiche di categoria utilizzando milioni di preferenze raccolte su prompt reali; Artificial Analysis suddivide invece immagini e video in use case e modalità tecniche e pubblica anche informazioni su prezzo, latenza e disponibilità open-weight. OpenArt differenzia soprattutto la propria proposta partendo direttamente dal lavoro professionale da svolgere, costruendo per ciascun job un set di test dedicato e combinando un council di esperti con un gruppo più ampio di professionisti e tastemaker.
La metodologia presenta comunque alcuni limiti di trasparenza. OpenArt non ha indicato al lancio il numero finale di giudici effettivamente partecipanti, il totale dei confronti pairwise effettuati né il numero preciso di prompt utilizzati per ciascuna leaderboard. La scelta di mantenere privati alcuni prompt riduce il rischio di benchmark overfitting, ma richiede di fidarsi della rappresentatività dei test non pubblici e della coerenza con cui gli output vengono generati e confrontati. OpenArt non è inoltre un ente di benchmarking indipendente, ma una piattaforma commerciale che offre accesso a molti degli stessi modelli presenti nelle classifiche e che intende utilizzare Arena anche per guidare la scelta del modello direttamente all’interno del proprio prodotto.
Per un utilizzo enterprise le classifiche possono quindi funzionare soprattutto come strumento di preselezione e routing dei workload, non come sostituto dei test interni. Prestazioni su prompt specifici dell’azienda, fedeltà al brand, requisiti legali, costo, velocità, moderazione, disponibilità via API e possibilità di self-hosting rimangono variabili che una classifica qualitativa non può riassumere completamente. Il valore di OpenArt Arena risiede quindi soprattutto nella possibilità di confrontare i modelli su attività creative distinte e di utilizzare queste informazioni per scegliere sistemi differenti lungo la stessa pipeline di produzione.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)