
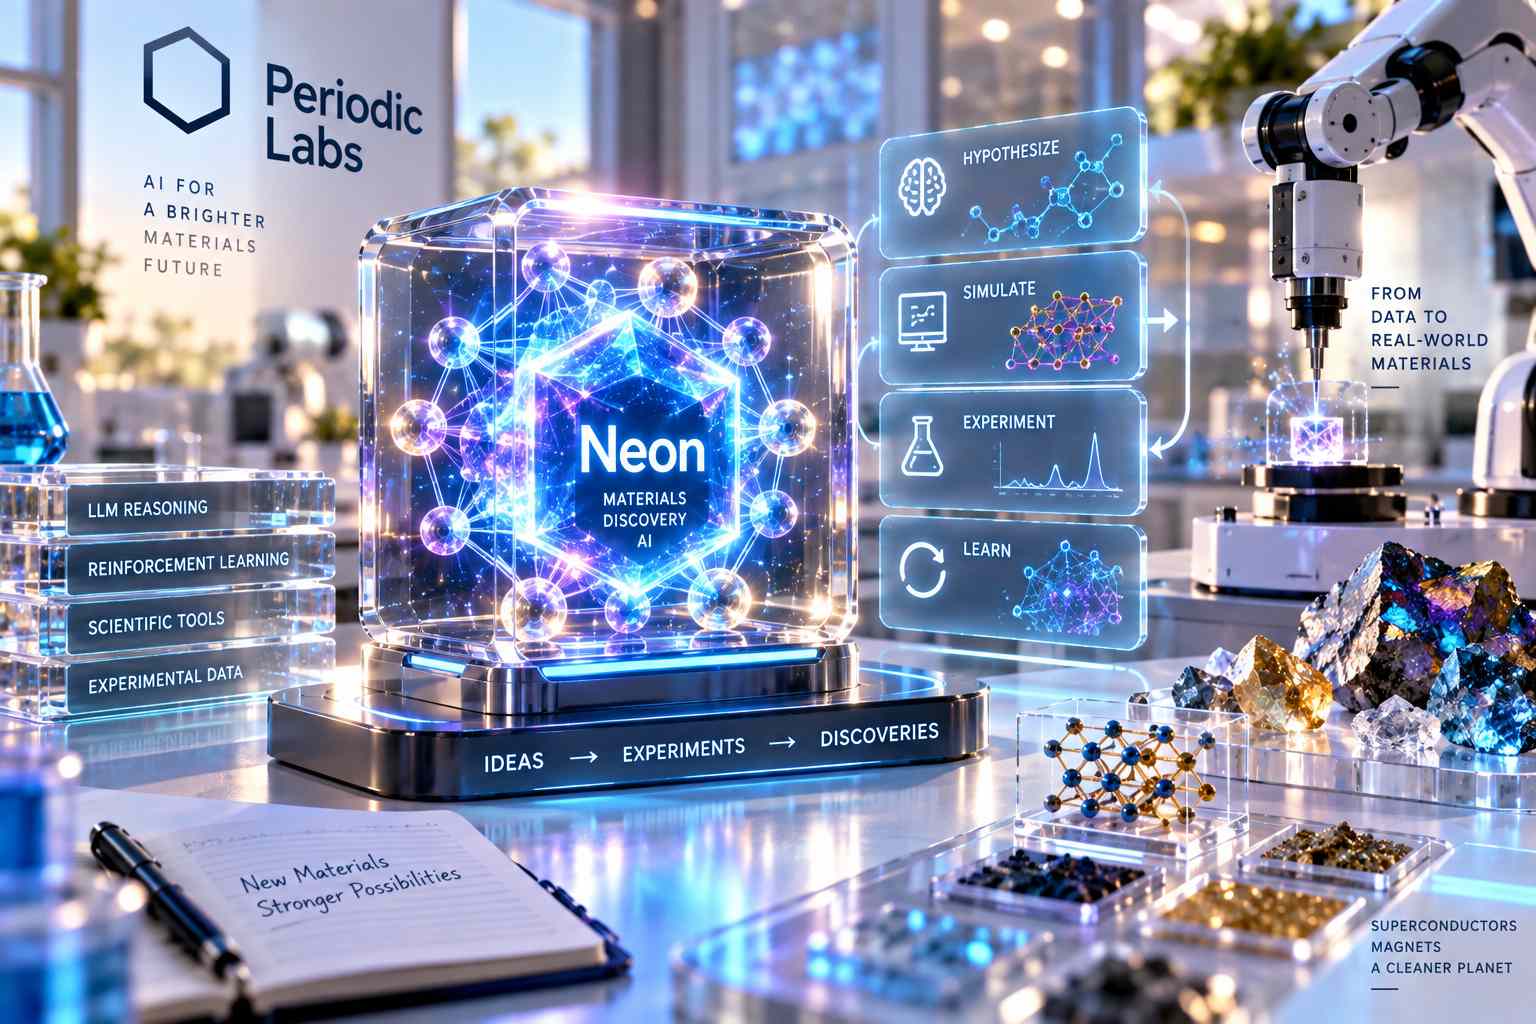
Periodic Labs ha presentato Neon, un modello di intelligenza artificiale sviluppato specificamente per la ricerca nella scienza dei materiali e progettato per combinare capacità di ragionamento dei modelli linguistici, reinforcement learning e utilizzo di strumenti scientifici all’interno di flussi di lavoro sperimentali prolungati. La società, fondata dall’ex ricercatore di OpenAI Liam Fedus, non ha lavorato soltanto sul modello ma anche sull’infrastruttura di training e inferenza necessaria per sostenerne l’utilizzo in attività scientifiche che richiedono sequenze di ragionamento molto lunghe e l’esecuzione ripetuta di software e strumenti esterni, con l’obiettivo di accelerare il passaggio dalla formulazione di un’ipotesi alla verifica sperimentale e alla successiva selezione dei materiali da approfondire.
Neon è stato costruito partendo da un modello a pesi aperti, successivamente sottoposto a una fase di mid-training e a reinforcement learning, mentre nell’ultima parte dell’addestramento Periodic Labs ha impiegato fino a 1.300 GPU Nvidia H200 insieme a mesi di dati sperimentali prodotti nei propri laboratori. Secondo i test interni della società, il modello avrebbe superato sistemi generalisti avanzati come GPT-6 Astra e Fable 5.1 in valutazioni basate sulla diffrazione a raggi X, o XRD, ma si tratta di risultati comunicati direttamente dall’azienda e non di benchmark indipendenti. Neon viene già utilizzato nei laboratori ad alta produttività realizzati da Periodic Labs a Menlo Park, dove analizza i risultati degli esperimenti e contribuisce alla selezione delle prove successive all’interno di un ciclo nel quale i laboratori producono nuovi dati, il modello apprende da queste informazioni e viene poi utilizzato per decidere quali configurazioni sperimentali tentare, con particolare attenzione alla ricerca di nuovi materiali per superconduttori e magneti.
Una parte centrale del progetto riguarda l’infrastruttura realizzata per addestrare e utilizzare modelli scientifici su larga scala. Periodic Labs ha sviluppato il proprio stack partendo da framework open source come Megatron, SGLang, Miles e Ray, modificandoli per adattarli alle caratteristiche del reinforcement learning scientifico, nel quale le sequenze possono avere durate e lunghezze molto variabili e il modello deve alternare ragionamento ed esecuzione di strumenti. La società dichiara che il proprio sistema di training può raggiungere, a parità di GPU, un throughput fino a 4,1 volte superiore rispetto a una configurazione basata su Megatron, mentre l’ottimizzazione di SGLang avrebbe consentito in specifici scenari di aumentare la velocità di inferenza fino a 2,5 volte; training e inferenza vengono inoltre eseguiti in modo asincrono su risorse GPU differenti, così da mantenere più elevato l’utilizzo dell’hardware anche mentre l’agente scientifico esegue strumenti esterni o affronta sequenze di ragionamento particolarmente lunghe.
L’ottimizzazione riguarda anche la gestione della memoria necessaria per modelli di dimensioni molto elevate. Periodic Labs combina tensor parallelism, pipeline parallelism ed expert parallelism, insieme a tecniche di ricomputazione selettiva e all’impiego di pesi FP8, per distribuire il modello su più acceleratori e ridurre la quantità di memoria richiesta durante il training. Nei test interni, elaborando un contesto da 64.000 token su 64 GPU, il picco di memoria sarebbe sceso da 320 a 132 GB, un livello che avrebbe permesso alla società di eseguire il full-parameter training del modello Kimi K2.6 da circa un trilione di parametri utilizzando soltanto 64 GPU H200.
Per consentire ai modelli di generare ed eseguire codice durante il reinforcement learning senza compromettere gli altri processi, Periodic Labs ha inoltre realizzato un sandbox proprietario chiamato pbox, che evita di affidarsi necessariamente a server di sandboxing separati e sfrutta invece la capacità CPU inutilizzata dei nodi GPU già assegnati ai workload di training. Il codice prodotto dall’AI viene isolato in modo che un consumo eccessivo di memoria, un errore o un processo anomalo non possano interferire con il resto dell’addestramento o dell’inferenza e, nei test condotti su 100 sandbox con upload e download di file da 1 MiB, pbox avrebbe registrato una latenza mediana di trasferimento dei dati 4,5 volte inferiore e un throughput complessivo 3,3 volte superiore rispetto al servizio di sandboxing hosted utilizzato come riferimento.
Anche il sistema di inferenza è stato modificato per sostenere sessioni di reinforcement learning particolarmente lunghe. Periodic Labs utilizza un approccio denominato PipelineRL, che sovrappone generazione e training invece di trattarli come fasi rigidamente separate, riutilizza la KV cache per evitare di ripetere calcoli già eseguiti e integra un meccanismo chiamato Delta Router Replay, attraverso il quale non vengono ritrasmesse a ogni passaggio tutte le informazioni di routing relative ai token già processati ma solamente quelle associate alla nuova porzione generata. Con queste ottimizzazioni, in un modello da un trilione di parametri e mantenendo invariata la dimensione del batch, la velocità di decoding sarebbe passata da 10 a 25 token al secondo, mentre il tempo necessario per convertire un checkpoint di grandi dimensioni nel formato utilizzato per l’inferenza sarebbe stato ridotto da circa 30 minuti a un minuto.
Periodic Labs sta inoltre riportando parte delle modifiche sviluppate internamente nei progetti open source dai quali è partita, contribuendo nuovamente codice e ottimizzazioni a Megatron-LM, SGLang e Miles. Le prossime attività previste comprendono lo sviluppo di reinforcement learning multi-agente, ulteriori ottimizzazioni dei modelli a bassa precisione, sistemi di KV cache distribuita e un’espansione dell’infrastruttura di sandboxing fino a migliaia di ambienti contemporanei per strumenti scientifici, proseguendo quindi parallelamente sul fronte dei modelli, del calcolo distribuito e dell’automazione degli esperimenti.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)