
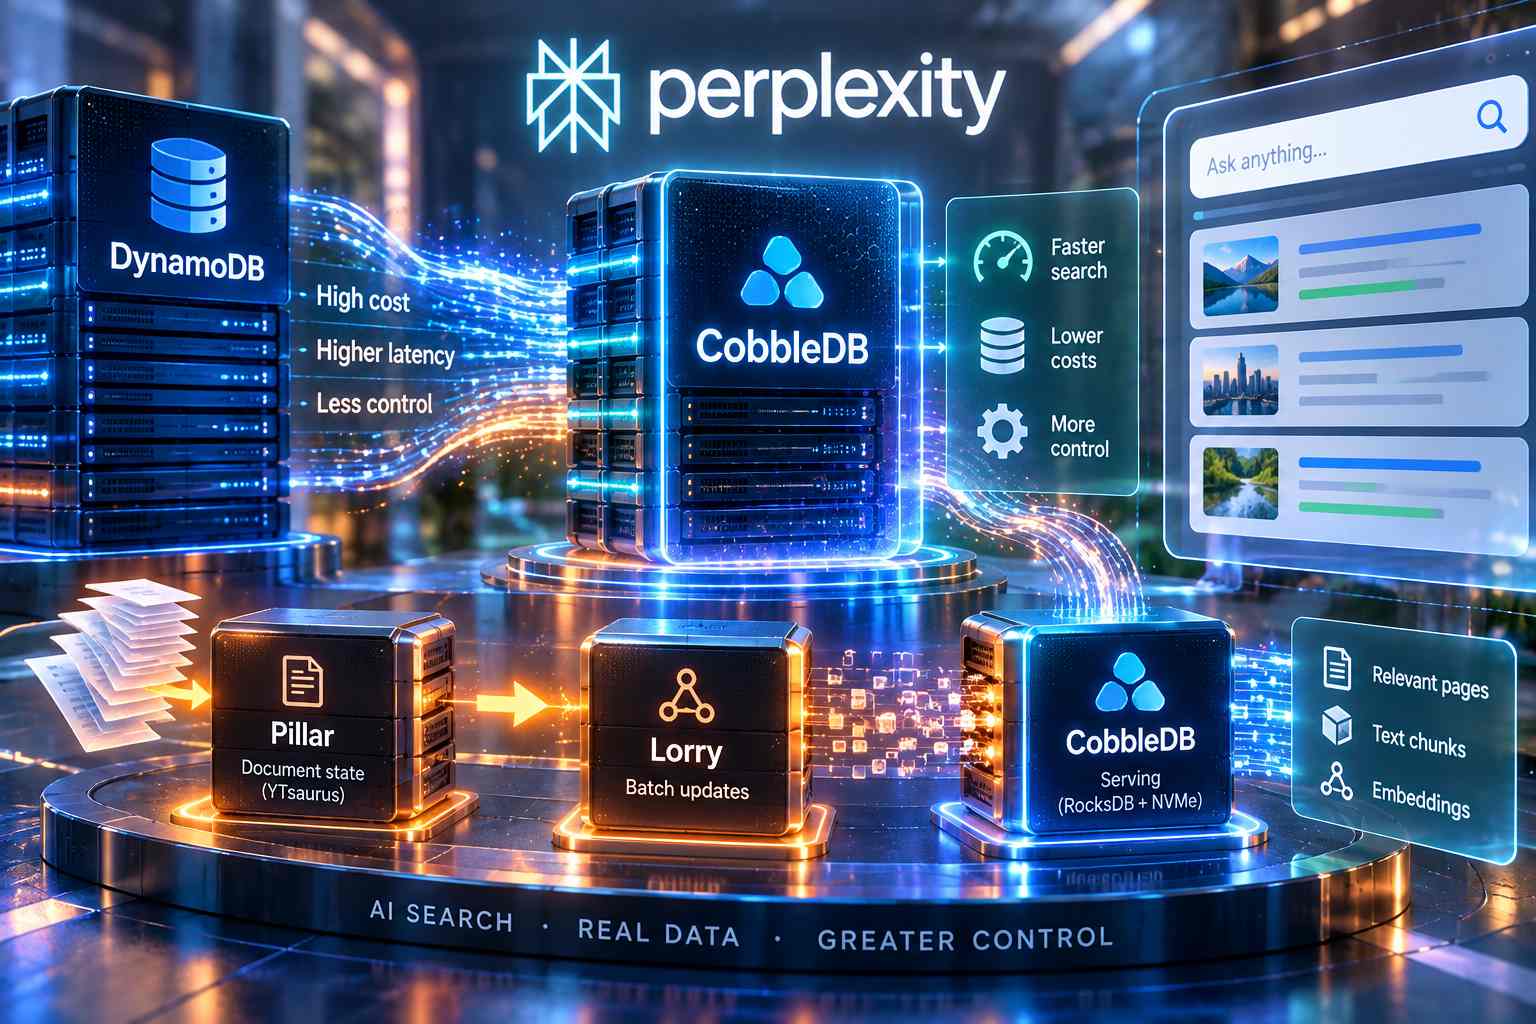
Perplexity ha ricostruito una parte del proprio livello di storage per la ricerca introducendo CobbleDB, un database key-value sviluppato internamente per sostituire DynamoDB in uno specifico percorso di lettura utilizzato dal motore di ricerca AI. L’infrastruttura principale di CobbleDB è stata realizzata nell’arco di due mesi da due ingegneri umani affiancati da centinaia di agenti AI di coding. Il nuovo sistema non è stato progettato come database general purpose, ma per un workload molto preciso: recuperare rapidamente, in batch, pagine già elaborate contenenti passaggi di testo e relativi embedding destinati alla fase di serving delle query.
La precedente architettura utilizzava DynamoDB come hot store per i contenuti preparati dal sistema di indicizzazione. Una tabella dedicata conservava passaggi ed embedding richiesti durante le ricerche, mentre il contenuto completo delle pagine e i relativi metadati venivano mantenuti separatamente. Con la crescita dell’indice e del volume delle query, Perplexity ha però individuato tre principali limiti. Il primo riguardava il modello di costo basato sulla quantità di dati letti e scritti, il secondo la ridotta possibilità di intervenire direttamente su caching, replica e collocazione fisica dei dati, mentre il terzo derivava dall’accoppiamento tra pipeline di elaborazione e scritture sul database utilizzato dal serving.
Una singola richiesta alla Search API può coinvolgere da 100 a 120 chiavi corrispondenti alle pagine da recuperare. Queste vengono lette attraverso batch più piccoli, generalmente composti da 10-20 chiavi, con una dimensione media dei record di circa 50 KB. La lettura ripetuta di questi dati generava quindi un consumo significativo, a cui si aggiungevano le scritture dovute al crawling continuo e alla rielaborazione dell’indice quando cambiavano modelli di embedding, strategie di chunking o altri elementi della pipeline.
Perplexity aveva inoltre bisogno di controllare in modo più preciso il percorso delle letture. Una cache miss, una richiesta indirizzata verso un’altra availability zone oppure una replica lenta possono infatti aumentare la latenza dell’intero batch. DynamoDB gestisce internamente elementi come storage, replica, caching e selezione delle repliche e consente di configurare il servizio, ma non di intervenire direttamente sulle politiche interne necessarie per ottimizzare un workload molto specifico. Nel nuovo sistema Perplexity può invece decidere quanta memoria dedicare alla cache, utilizzare storage NVMe locale per i dati non presenti in memoria e controllare il routing delle richieste tra le repliche.
CobbleDB è stato costruito come distributed key-value store nel quale le chiavi corrispondono agli identificatori delle pagine, ottenuti tramite hash degli URL, mentre i valori contengono le rappresentazioni già processate delle pagine, comprendenti passaggi pre-segmentati ed embedding vettoriali associati ai singoli chunk. I dati vengono suddivisi in partizioni distribuite sui nodi del cluster e ogni partizione mantiene tre repliche su tre nodi differenti, così che le letture possano continuare anche nel caso in cui una copia non sia disponibile.
Ogni nodo utilizza RocksDB come motore key-value embedded. La scelta permette di servire dalla memoria i dati presenti in cache e di utilizzare storage NVMe locale per quelli non disponibili in RAM. Il database può così essere regolato in funzione del rapporto effettivo tra memoria e disco osservato nel workload di produzione, anziché dipendere dalle politiche interne di caching di un servizio gestito. Sopra i nodi opera un query router stateless che calcola la partizione corrispondente alle chiavi e distribuisce in parallelo le richieste alle macchine interessate.
Il router cerca inoltre, quando possibile, di inviare la richiesta a un nodo situato nella stessa availability zone per ridurre la latenza tra zone. I nodi utilizzano MultiGet, l’API di RocksDB progettata per recuperare più chiavi contemporaneamente. Se una replica impiega troppo tempo a rispondere, il sistema può effettuare una richiesta parallela a un’altra replica della stessa partizione, una tecnica utilizzata per ridurre soprattutto la tail latency. L’architettura comprende anche un servizio di metadati basato su PostgreSQL e storage a oggetti persistente.
CobbleDB elimina inoltre alcune funzioni tipiche dei database general purpose che non erano necessarie per questo caso d’uso. L’hot store di Perplexity non richiede transazioni generiche né repliche perfettamente sincronizzate. È accettabile, ad esempio, un breve intervallo tra la scrittura di un documento e la sua disponibilità per le letture, così come è possibile che una replica completi l’ingestione di un aggiornamento prima di un’altra. La rimozione di queste garanzie non necessarie riduce complessità e overhead e permette di ottimizzare il sistema esclusivamente per le letture batch utilizzate dalla ricerca.
La sostituzione di DynamoDB rappresenta però soltanto una parte della nuova architettura. Perplexity ha separato completamente lo stato persistente dei documenti, la distribuzione degli aggiornamenti e il serving in tempo reale attraverso tre componenti distinti: Pillar, Lorry e CobbleDB. Pillar mantiene lo stato persistente dei documenti e determina quali rappresentazioni devono essere pubblicate, Lorry trasforma gli aggiornamenti in batch organizzati per partizione, mentre CobbleDB li acquisisce e serve i record durante le query.
Pillar utilizza YTsaurus come backend e conserva separatamente elementi quali metadati, chunk ed embedding. Il sistema gestisce inoltre più versioni delle rappresentazioni, permettendo per esempio a vecchi e nuovi embedding di coesistere durante una migrazione. Poiché Pillar e YTsaurus utilizzano storage HDD meno costoso, Perplexity può mantenere in questa parte dell’infrastruttura un numero molto maggiore di documenti rispetto a quelli conservati nell’hot store su NVMe. Soltanto le pagine considerate necessarie per il serving vengono poi esportate verso CobbleDB.
Pillar gestisce anche gruppi di documenti definiti tramite policy, come pagine nuove o considerate particolarmente rilevanti, e decide quali modifiche debbano essere propagate ai sistemi downstream. Gli aggiornamenti dello stato, la registrazione dell’input elaborato e la creazione delle operazioni di esportazione vengono coordinati tramite transazioni atomiche di YTsaurus, in modo che un fallimento non lasci componenti dell’infrastruttura in stati incoerenti.
Lorry è invece un servizio stateless dedicato alla consegna degli aggiornamenti. Legge i record da code persistenti allineate alle partizioni, li aggrega in file batch e li trasferisce a CobbleDB. Tra Lorry e CobbleDB viene utilizzato anche S3 come data plane: Lorry salva un batch nello storage a oggetti, registra l’operazione nel control plane e le singole repliche di CobbleDB recuperano successivamente i batch necessari applicandoli in ordine cronologico. Una replica lenta o temporaneamente offline può quindi riallinearsi con il proprio ritmo senza rallentare il resto del cluster.
Questa separazione risolve anche un limite della precedente pipeline. Prima della modifica, ogni pagina processata veniva scritta direttamente su DynamoDB e un’operazione di rielaborazione su larga scala poteva produrre un elevato numero di aggiornamenti simultanei sull’hot store. Era quindi difficile, per esempio, rieseguire un MapReduce sull’intero database nell’arco di uno o due giorni per sperimentare una nuova strategia di chunking, cambiare modello di embedding o aggiungere nuovi campi. Con Pillar e Lorry, gli aggiornamenti vengono invece registrati in modo persistente e possono essere riprodotti e trasferiti separatamente verso il livello destinato alle query.
Nei dati di produzione comunicati da Perplexity, la latenza mediana delle letture batch è scesa da 31,4 millisecondi con DynamoDB a 5,60 millisecondi con CobbleDB. Il valore p90 è passato da 56,7 a 9,77 millisecondi e il p99 da 123 a 24,2 millisecondi, con miglioramenti compresi tra circa 5,08 e 5,80 volte. Le misurazioni riguardano batch generalmente composti da 10-15 chiavi e record con dimensione media di circa 50 KB.
Entrambi i sistemi sono stati osservati con circa 200.000 richieste al secondo, mentre Perplexity afferma di aver sottoposto CobbleDB a test di carico fino a 500.000 richieste al secondo senza rilevare degradazioni. L’azienda precisa tuttavia che il confronto di produzione è di tipo before-and-after e non costituisce un benchmark perfettamente controllato, perché DynamoDB e CobbleDB hanno servito traffico reale in momenti differenti. Per questo motivo sono stati condotti anche test sintetici con batch da 10-15 chiavi e dimensioni dei valori comprese tra 100 byte e 100 KiB.
Sul piano economico, il modello interno di Perplexity stima che CobbleDB costi almeno il 20% in meno rispetto a DynamoDB su tutti i livelli di commitment considerati. Il calcolo comprende dimensioni dello storage e capacità di lettura e scrittura, ma non include ulteriori risparmi ottenibili tramite compressione dei backup, per cui secondo l’azienda il vantaggio effettivo potrebbe essere maggiore.
Lo sviluppo ha richiesto comunque una quantità significativa di lavoro. Il solo database CobbleDB comprende circa 40.000 righe di codice Rust, alle quali si aggiungono test sul comportamento in caso di guasto, integrazione con le pipeline di elaborazione e serving, procedure di migrazione del traffico e controlli necessari per il funzionamento in produzione. Per accelerare questa fase Perplexity ha utilizzato un sistema interno basato su uno sciame di agenti di coding persistenti, progettati per mantenere tra diverse sessioni informazioni su obiettivi del progetto, rischi attivi, cronologia dei repository e decisioni già prese.
Gli agenti hanno ricostruito lo stato del progetto analizzando thread di sviluppo, attività ancora aperte, pull request e relativi responsabili, mantenendo quindi una visione aggiornata dei problemi e dei passaggi successivi. Hanno revisionato codice e modifiche infrastrutturali, identificato ipotesi non sicure nelle procedure di restore, riferimenti a build non più aggiornati e configurazioni destinate a fallire a runtime, oltre a preparare correzioni, test, modifiche al monitoraggio e documentazione operativa.
Gli stessi agenti hanno seguito inoltre pipeline CI, revisioni e gate infrastrutturali, monitorato rollout, backup e test di ripristino e confrontato lo stato osservato del sistema con i criteri stabiliti per considerare riuscita una distribuzione. Le decisioni architetturali, l’approvazione delle modifiche considerate critiche e le operazioni effettive sull’ambiente di produzione sono però rimaste responsabilità degli ingegneri umani. Gli agenti hanno quindi gestito soprattutto ispezione continua, verifica, preparazione del lavoro e follow-up tra una decisione umana e quella successiva.
Con questo modello, la parte centrale dell’infrastruttura CobbleDB è stata completata da due ingegneri e centinaia di agenti AI in circa due mesi. Perplexity considera l’impiego degli agenti un elemento che modifica anche il tradizionale confronto tra acquisto di servizi gestiti e sviluppo interno, perché consente a team molto piccoli di affrontare sistemi infrastrutturali che normalmente richiederebbero un numero superiore di persone.
CobbleDB rimane comunque una soluzione costruita specificamente attorno al workload di ricerca di Perplexity e non viene presentato come sostituto universale di DynamoDB. L’azienda prevede inoltre di rendere CobbleDB open source, permettendo ad altri team che sviluppano sistemi di ricerca AI-native di utilizzare lo stesso livello di storage ottimizzato per letture batch di contenuti già elaborati.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)