
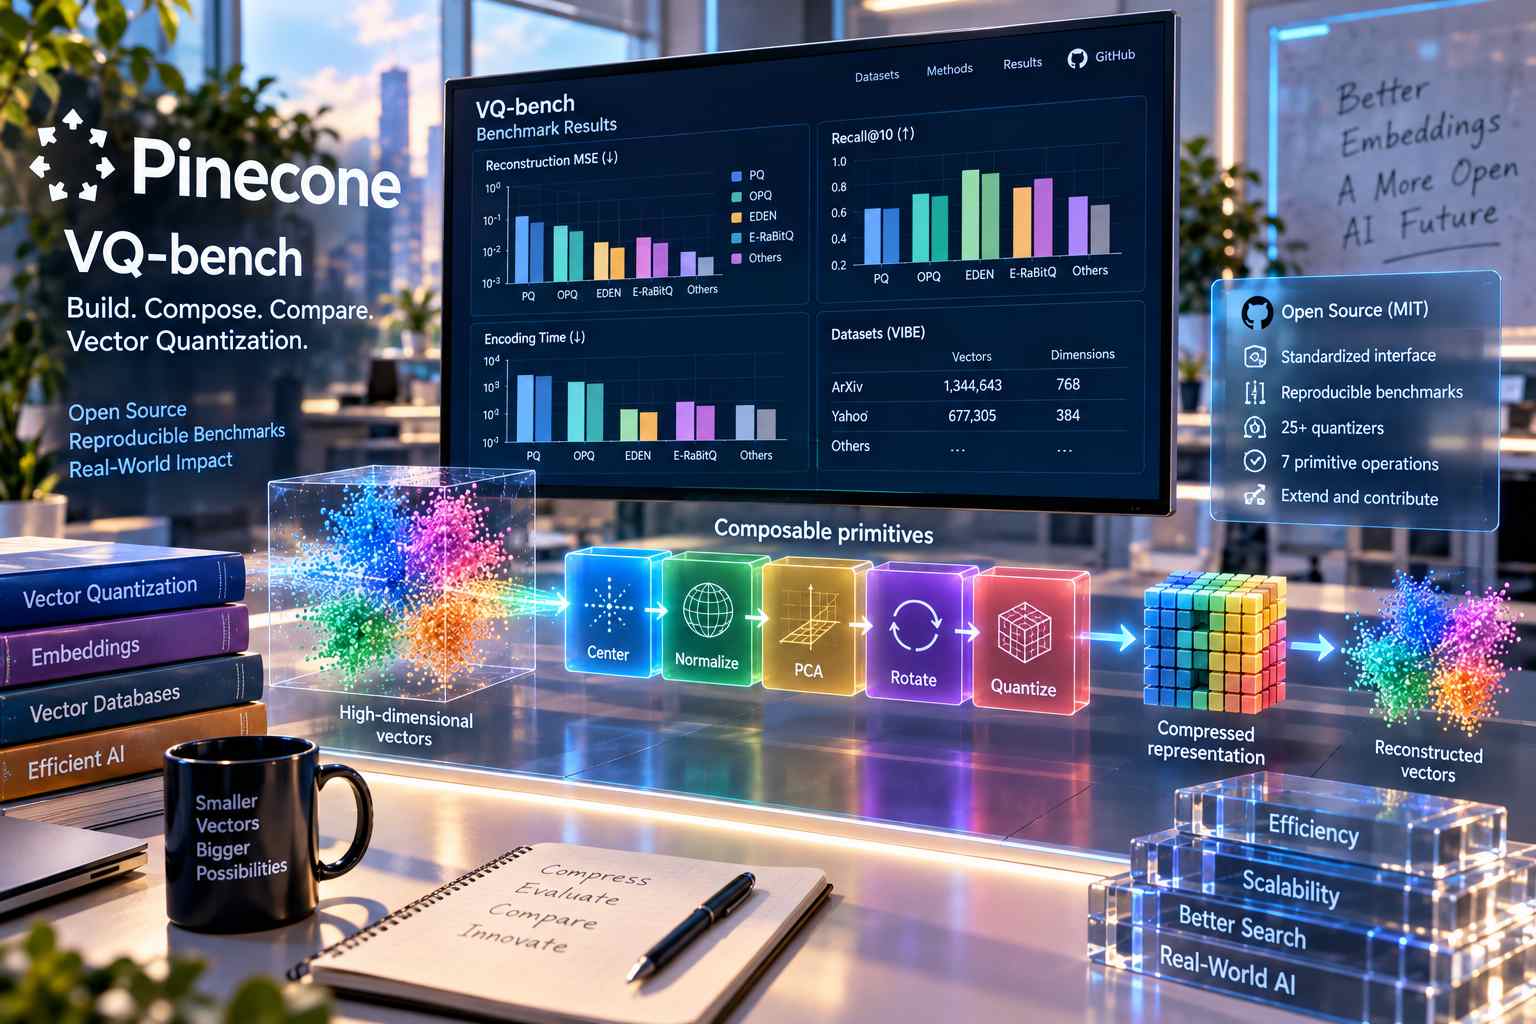
Pinecone ha pubblicato VQ-bench, un framework open source progettato per costruire, comporre e confrontare metodi di vector quantization attraverso una struttura comune e benchmark riproducibili. Il progetto è stato sviluppato da Ashwin Padaki, Amir Ingber ed Edo Liberty e comprende un repository GitHub distribuito con licenza MIT, un sito pubblico che raccoglie i risultati dei benchmark e un paper presentato a VecDB@VLDB 2026. Alla base del lavoro c’è l’idea di ricondurre molti algoritmi di quantizzazione vettoriale a combinazioni di un insieme relativamente piccolo di operazioni primitive, in modo da rendere più semplice sia l’implementazione di nuovi metodi sia il confronto diretto tra approcci differenti. Il framework descrive sette primitive concettuali e riformula 25 quantizzatori esistenti come pipeline ottenute componendo queste operazioni.
La quantizzazione vettoriale viene utilizzata per ridurre il numero di bit necessari a rappresentare vettori ad alta dimensionalità e viene impiegata sia nei database vettoriali sia in altri componenti dell’infrastruttura AI, compresa la compressione dei pesi dei modelli linguistici. Pinecone utilizza tecniche di quantizzazione fin dai primi prototipi del proprio database vettoriale, ma nel confronto tra i metodi più recenti ha rilevato una forte eterogeneità nella letteratura disponibile: diversi lavori utilizzano metriche, dataset e hardware differenti, rendendo difficile stabilire confronti diretti tra le prestazioni dei diversi algoritmi. VQ-bench è quindi pensato come un ambiente comune nel quale implementare i metodi attraverso interfacce standardizzate ed eseguirli nelle stesse condizioni sperimentali.
All’interno di VQ-bench un quantizzatore è definito come qualsiasi componente in grado di ricevere un insieme di vettori, comprimerli e successivamente recuperare le informazioni necessarie. Ogni quantizzatore deve implementare quattro metodi fondamentali. Fit apprende un modello a partire da un campione di vettori e, facoltativamente, dalle query; encode genera i codici associati ai singoli vettori utilizzando il modello appreso; reconstruct ricostruisce un vettore a partire dal modello e dal relativo codice; score stima invece il prodotto scalare tra un vettore di query e un vettore codificato. Questa interfaccia consente al framework di trattare nello stesso modo algoritmi differenti e di applicare le medesime procedure di valutazione.
Le primitive utilizzano gli stessi quattro metodi ma aggiungono apply e apply_queries, che definiscono come i dati e le query vengono trasformati prima di essere trasferiti alla fase successiva della pipeline. Sono proprio questi due metodi a creare il meccanismo di composizione tra primitive. VQ-bench organizza le operazioni disponibili in tre gruppi principali. I conditioner comprendono trasformazioni come Center, Normalize, PCA e RandomRotate; i rounder includono CastUint, CastAngular, CastNormal e KMeans; gli splitter comprendono invece operazioni come Segment. Una pipeline viene costruita concatenando due o più primitive, consentendo di combinare trasformazioni, suddivisioni e operazioni di discretizzazione in sequenze differenti.
Durante le fasi di fit ed encode i vettori attraversano la pipeline in avanti e ogni stadio applica la propria trasformazione, aggiungendo al risultato il modello appreso e i codici prodotti. La ricostruzione procede invece in senso inverso: reconstruct parte dall’ultimo stadio e ripercorre la pipeline all’indietro, reintegrando progressivamente il contributo di ogni primitiva. Anche score utilizza il percorso inverso, dopo aver trasformato inizialmente la query attraverso apply_queries. Il framework non richiede necessariamente che un quantizzatore sia costruito come pipeline, poiché qualsiasi implementazione compatibile con i quattro metodi principali può essere utilizzata, ma secondo gli autori una parte consistente degli algoritmi pubblicati può essere rappresentata proprio come una sequenza di primitive.
Tra gli esempi utilizzati per mostrare il funzionamento della composizione figura E-RaBitQ, rappresentato come una pipeline composta da quattro passaggi. Center sottrae da ciascun vettore il vettore medio del dataset, Normalize porta ogni vettore a norma unitaria, una random rotation applica una trasformazione ortogonale casuale o basata su Hadamard e infine un angular cast proietta il vettore su una griglia intera a b bit effettuando l’arrotondamento verso il punto più vicino in termini di angolo. Il modello permette quindi di descrivere un algoritmo relativamente complesso attraverso una sequenza leggibile e modificabile di componenti elementari.
Per il benchmark iniziale sono stati valutati 14 quantizzatori su cinque dataset della raccolta VIBE. I risultati dettagliati riportati comprendono in particolare ArXiv, composto da 1.344.643 vettori a 768 dimensioni, e Yahoo, con 677.305 vettori a 384 dimensioni. Una delle metriche utilizzate è il reconstruction mean squared error, calcolato su 1.000 vettori estratti casualmente misurando la distanza quadratica media tra ciascun vettore originale e la relativa ricostruzione. Questa metrica rappresenta una misura tradizionale della qualità della quantizzazione ed è rilevante anche per scenari come la compressione dei pesi dei modelli linguistici.
Per gli scenari legati ai database vettoriali viene invece utilizzata anche la recall, considerata particolarmente significativa nelle operazioni di reranking. La recall@10 viene calcolata individuando per ogni query i 1.000 vettori del dataset con prodotto scalare massimo e verificando quale percentuale dei primi dieci risultati stimati dal quantizzatore appartenga effettivamente ai dieci risultati corretti. Il valore finale viene poi mediato sull’intero insieme delle query. I test relativi ai tempi di encoding sono stati eseguiti su un Apple M2 Pro con 16 GB di RAM utilizzando sei thread, elaborando i dati a blocchi e sfruttando il multithreading.
Nei risultati riportati, PQ e OPQ hanno ottenuto in modo consistente i valori più bassi di reconstruction MSE. EDEN ed E-RaBitQ hanno invece mostrato risultati comparabili sul fronte della recall, soprattutto utilizzando budget di bit più elevati. EDEN ha inoltre registrato tempi di encoding sensibilmente inferiori rispetto a PQ, OPQ ed E-RaBitQ e viene indicato dagli autori come un candidato adatto a numerosi scenari di quantizzazione nei quali il costo della codifica rappresenta un parametro importante. I risultati completi vengono mantenuti sul sito pubblico associato al progetto, consentendo di confrontare metodi e configurazioni differenti attraverso una base sperimentale comune.
Il repository di VQ-bench comprende anche uno strumento da riga di comando scritto in Rust e denominato vqb. Le configurazioni di esecuzione vengono definite attraverso file JSON che consentono di selezionare dataset, metodi di quantizzazione, relativi parametri, metriche di qualità, valori di k utilizzati per il calcolo della recall, temperature per softmax, seed principale, numero di campioni e quantità di thread. Una modalità dry-run permette inoltre di validare la configurazione prima di avviare i calcoli. Per dataset che superano la memoria disponibile è presente una modalità streaming che legge i vettori dal disco a blocchi, utilizzando per impostazione predefinita segmenti da 256 MB.
L’harness di valutazione non si limita alla recall e all’errore di ricostruzione, ma misura anche score error, bias, softmax KL divergence, total variation, dimensione espressa in bit per dimensione e costi associati alle operazioni di encoding, scoring e reconstruction. La struttura modulare consente inoltre di estendere il progetto in due modi. È possibile aggiungere nuovi quantizzatori, spesso semplicemente riorganizzando primitive già disponibili, oppure introdurre nuove primitive implementando i sei metodi previsti dall’interfaccia; una nuova primitiva può quindi essere combinata automaticamente con tutte le altre presenti nel catalogo.
VQ-bench viene presentato come una prima versione di un framework destinato a essere esteso nel tempo. Pinecone prevede di aggiungere progressivamente ulteriori quantizzatori e di aggiornare periodicamente il benchmark pubblico incorporando nuovi metodi. Il repository può inoltre ricevere correzioni attraverso il sistema di issue e contributi esterni riguardanti sia nuovi algoritmi sia nuove primitive. L’obiettivo tecnico è disporre di un ambiente nel quale algoritmi storicamente descritti con implementazioni e procedure sperimentali differenti possano essere ricondotti a una struttura comune, eseguiti nelle stesse condizioni e confrontati attraverso metriche riproducibili.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)