
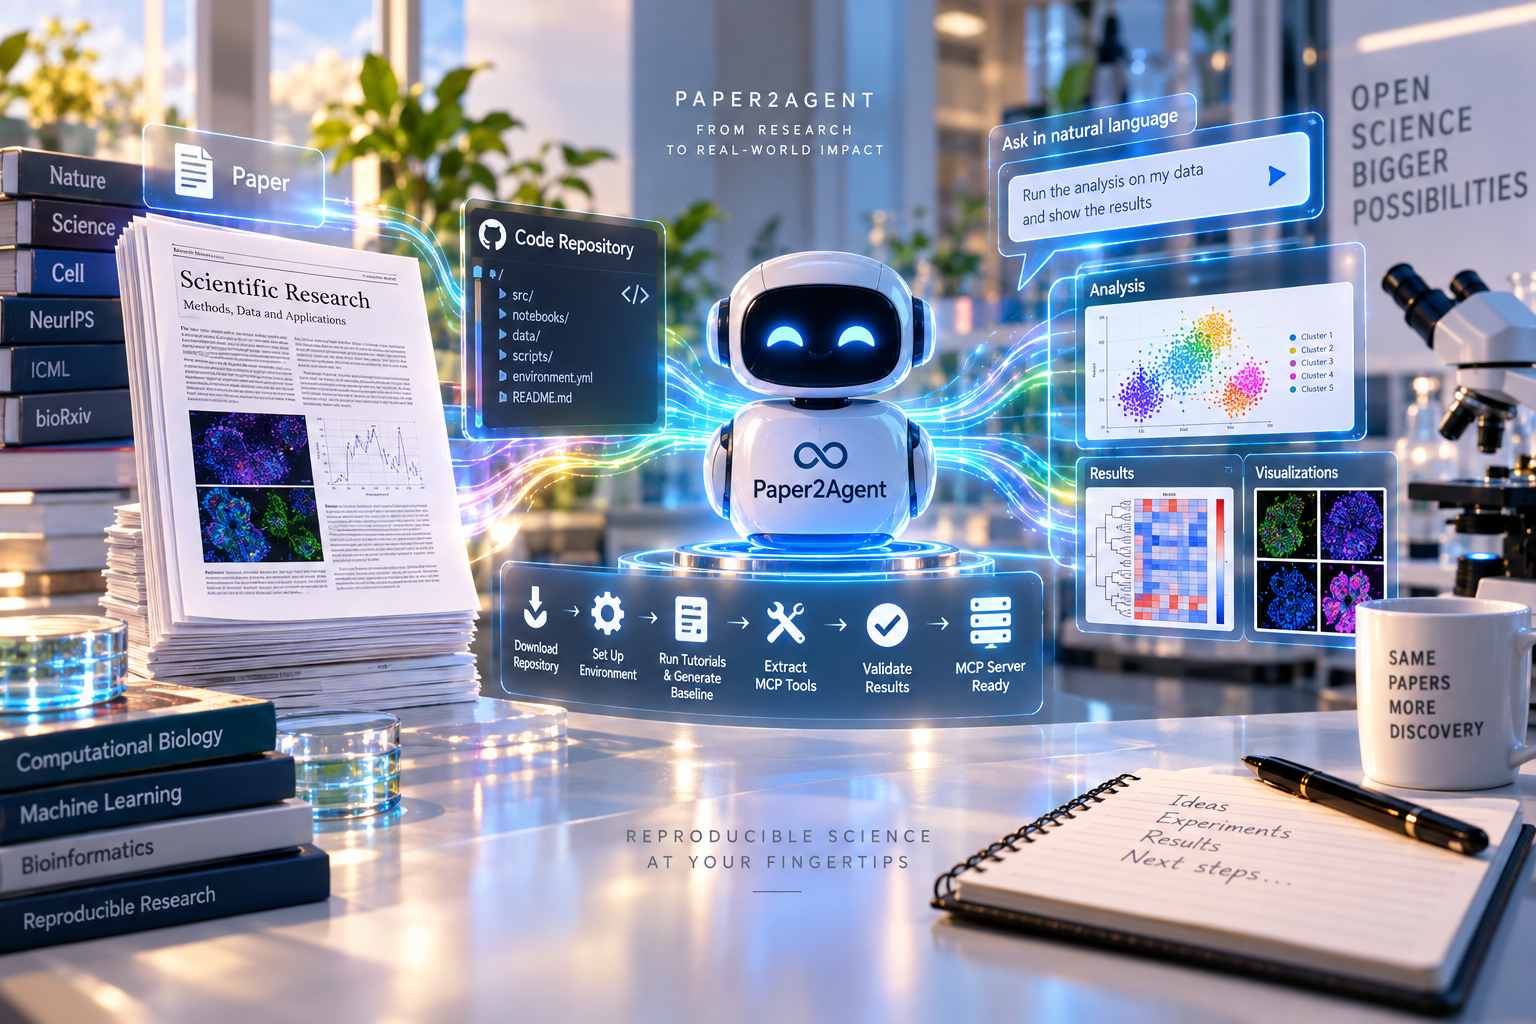
Un gruppo di ricercatori della Stanford University ha presentato Paper2Agent, un sistema open source progettato per trasformare un articolo scientifico e il relativo repository di codice in un agente AI interattivo capace di eseguire direttamente i metodi descritti nella ricerca. Il framework, pubblicato attraverso Nature, nasce per superare uno dei limiti pratici più comuni nella riproducibilità scientifica: anche quando un paper rende pubblico il proprio codice, un ricercatore deve spesso individuare il repository corretto, scaricarlo, configurare l’ambiente di sviluppo, installare le dipendenze, comprendere tutorial e script, risolvere eventuali errori e infine adattare il metodo ai propri dati. Paper2Agent automatizza gran parte di questo processo e converte materiali testuali e software in un insieme di strumenti utilizzabili tramite linguaggio naturale, con l’obiettivo di trasformare il metodo scientifico contenuto nel paper in qualcosa di direttamente interrogabile ed eseguibile. I ricercatori descrivono il risultato come una sorta di “virtual corresponding author”, cioè un corrispondente virtuale capace non soltanto di spiegare il lavoro ma anche di riprodurne concretamente le procedure.
Il sistema utilizza il Model Context Protocol, MCP, come interfaccia attraverso la quale esporre le funzioni estratte dal paper e dal relativo codice. La pipeline di conversione è articolata in sei fasi automatiche: Paper2Agent individua e scarica innanzitutto il repository software associato alla ricerca, quindi un agente dedicato alla gestione dell’ambiente crea uno spazio virtuale isolato nel quale eseguire il codice senza interferire con il sistema principale. Successivamente vengono analizzati i tutorial disponibili e viene effettuata un’esecuzione completa end-to-end per ottenere risultati di riferimento, che vengono poi utilizzati come baseline durante la verifica. Un tool extractor converte quindi i passaggi individuati nei tutorial in strumenti MCP parametrizzabili, sottopone ogni funzione a un processo di validazione e, soltanto dopo il superamento dei controlli, assembla gli strumenti approvati all’interno di un server MCP che può essere interrogato da un agente tramite istruzioni in linguaggio naturale.
La validazione costituisce una parte centrale dell’architettura, perché il sistema non considera sufficiente che il codice venga semplicemente eseguito senza errori. Per superare il controllo devono essere generati i file attesi e i principali valori numerici ottenuti durante l’esecuzione devono rimanere entro una tolleranza del 3% rispetto ai risultati di riferimento ricavati dal tutorial originale; nel caso delle immagini, Paper2Agent utilizza invece un perceptual hash e confronta il risultato con l’immagine baseline, richiedendo una Hamming distance inferiore a 20. Ogni funzione può essere sottoposta fino a sei tentativi di verifica e, se continua a non soddisfare i criteri stabiliti, viene esclusa dal server MCP finale. Il server risultante contiene tre elementi principali: strumenti MCP che rappresentano funzioni realmente eseguibili derivate dal metodo scientifico, risorse MCP che espongono informazioni provenienti da paper, codice, dataset e figure, e prompt MCP che descrivono procedure articolate in più passaggi, per esempio l’ordine corretto con cui effettuare il preprocessing dei dati prima di utilizzare una determinata funzione.
Una delle dimostrazioni più ampie ha riguardato AlphaGenome di Google DeepMind. Paper2Agent ha impiegato circa 45 minuti per costruire 22 strumenti dedicati al sistema e tutti hanno superato automaticamente la fase di validazione senza intervento umano. Nelle domande basate sui tutorial, il tempo mediano necessario per completare le richieste è risultato 1,9 volte inferiore rispetto all’accesso diretto al repository tramite Claude Code e 3,1 volte inferiore rispetto a Biomni, sistema AI dedicato alla biomedicina. In un secondo test basato su Scanpy, libreria ampiamente utilizzata per l’analisi single-cell, il framework ha prodotto sette strumenti verificati in circa 45 minuti e, utilizzando quattro dataset pubblici, è riuscito a riprodurre numero di cellule, numero di geni e principali marker genetici con risultati comparabili a quelli ottenuti da ricercatori umani. La stessa impostazione è stata applicata anche a TISSUE, dove Paper2Agent ha riprodotto analisi umane su dati di trascrittomica spaziale.
I ricercatori hanno quindi esteso il test a 100 articoli di computational biology pubblicati su bioRxiv, riuscendo ad agentificare automaticamente 74 paper. Dei 599 strumenti proposti durante il processo, 593 hanno superato i controlli di validazione e, su un insieme di 300 domande, Paper2Agent ha raggiunto un’accuratezza del 91,2%, mentre l’approccio basato sull’accesso diretto al repository tramite Claude ha ottenuto risultati compresi tra l’80,3% e l’86,3%. Anche costo e tempo per richiesta sono risultati inferiori: circa 0,20 dollari e 1,6 minuti per Paper2Agent, contro 0,38 dollari e 4,3 minuti per l’approccio di confronto. Questi risultati indicano che la trasformazione preventiva del repository in un insieme strutturato di strumenti verificati può ridurre il lavoro che l’agente deve svolgere ogni volta che riceve una nuova richiesta, evitando di dover reinterpretare continuamente struttura e funzionamento dell’intero codice sorgente.
Paper2Agent è stato inoltre testato al di fuori della biologia per verificare se il metodo dipendesse eccessivamente dalle caratteristiche dei workflow biomedicali. Su dieci paper non biologici, comprendenti lavori relativi a TabPFN, SAM 2 e SAELens, il sistema ha ottenuto un’accuratezza del 98,1% su 42 attività eseguibili, mentre una valutazione separata condotta su 26 paper data-centric ha mostrato una maggiore accuratezza nell’utilizzo delle risorse rispetto a un approccio basato sul browser, accompagnata anche da riduzioni nei costi e nei tempi di esecuzione. Il codice sorgente del framework è stato pubblicato su GitHub, mentre l’agente dedicato ad AlphaGenome generato attraverso Paper2Agent è stato reso disponibile su Hugging Face, permettendo di esaminare direttamente sia la pipeline di conversione sia un esempio completo del tipo di agente ottenibile a partire da un lavoro scientifico esistente.
L’elemento che distingue Paper2Agent da un normale assistente per la consultazione dei documenti è quindi il passaggio dalla comprensione del paper alla trasformazione operativa del metodo descritto: testo, repository e tutorial vengono convertiti in funzioni strutturate, testate rispetto ai risultati originali ed esposte tramite MCP, così che un utente possa applicare la metodologia a nuovi dati attraverso semplici istruzioni in linguaggio naturale senza dover ricostruire ogni volta l’intero ambiente software della ricerca.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)