
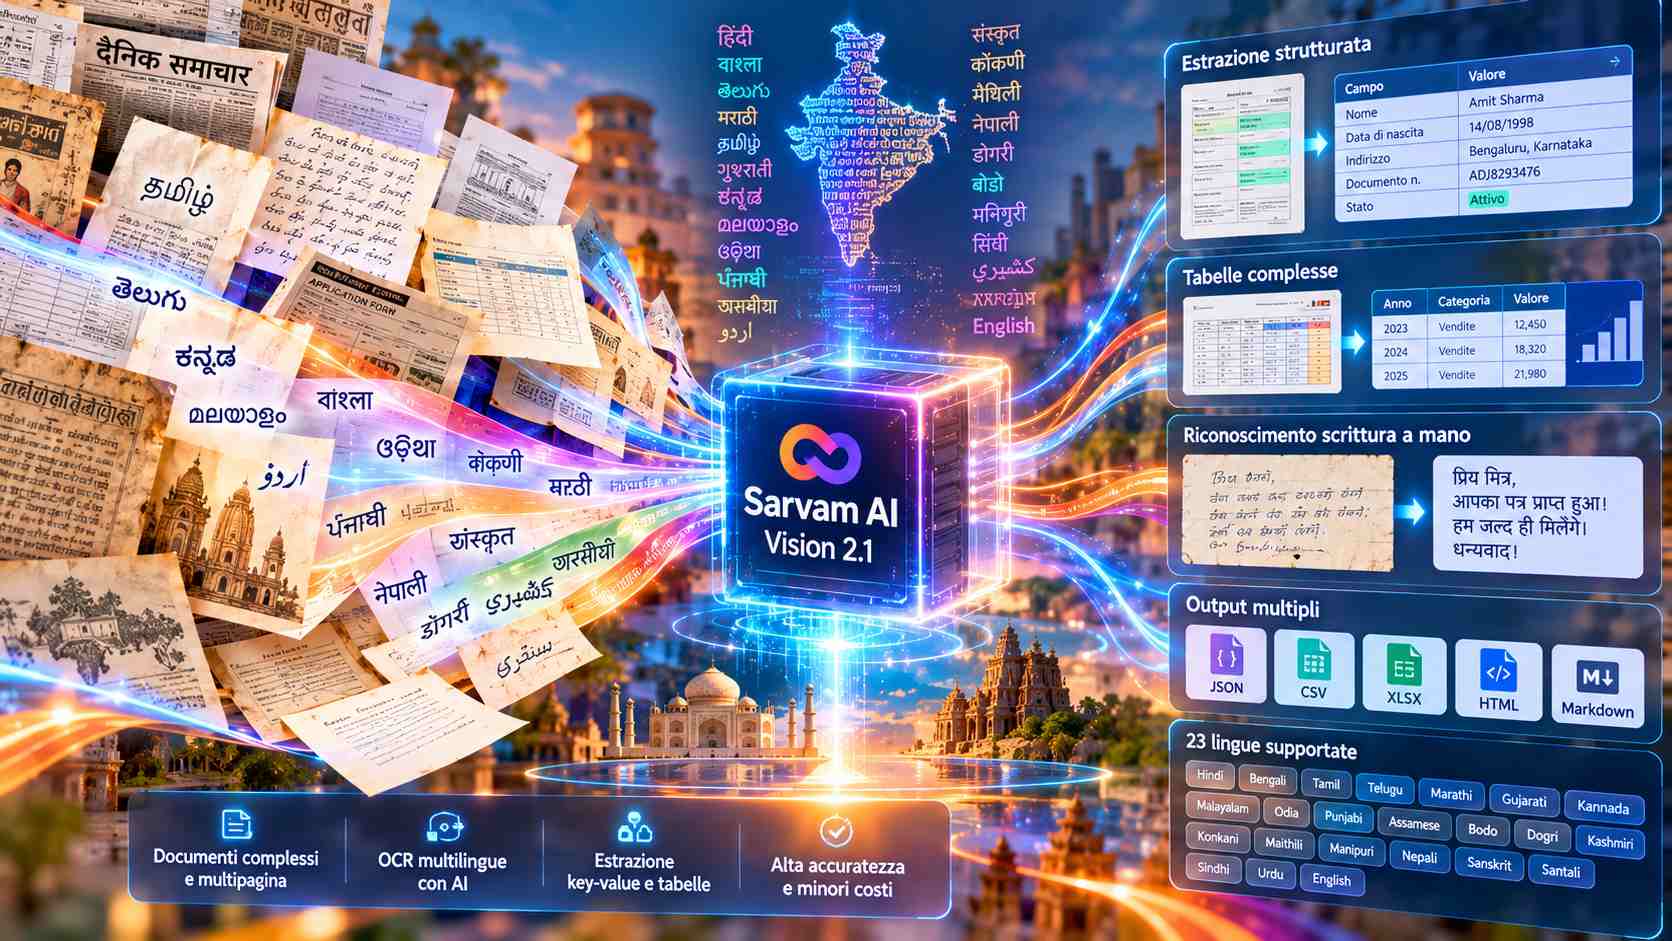
Sarvam AI ha presentato Vision 2.1, una nuova versione del proprio modello vision-language dedicato alla document intelligence, con miglioramenti mirati nell’estrazione strutturata da documenti complessi, nel riconoscimento della scrittura a mano e nell’elaborazione delle 22 lingue ufficiali dell’India oltre all’inglese. La prima versione di Sarvam Vision era stata lanciata nel febbraio 2026 all’interno della linea di modelli sovrani dell’azienda e aveva già concentrato buona parte delle proprie capacità su OCR per lingue indiche, parsing di tabelle, ragionamento visivo multilingue e generazione di output strutturati a partire da contenuti visivi. Vision 2.1 interviene sui principali limiti emersi nell’utilizzo reale del modello, sia dal punto di vista funzionale sia da quello operativo: Sarvam ha ottimizzato lo stack di inferenza per ridurre i costi rispetto a quelli inizialmente annunciati e per rendere l’API più adatta a carichi produttivi, mentre sul piano delle capacità ha lavorato soprattutto su parsing di tabelle complesse e multipagina, estrazione key-value da moduli, riconoscimento del testo manoscritto nelle lingue indiane e riduzione di allucinazioni e incoerenze. L’architettura continua a seguire il paradigma “harness-with-VLM”, nel quale il modello vision-language viene affiancato da componenti specializzati: un semantic layout parser analizza la struttura logica della pagina e una pointer reading order network determina l’ordine di lettura corretto. Il VLM può operare direttamente a livello di singola pagina o di intero documento, ma Sarvam utilizza questi moduli aggiuntivi perché l’elaborazione pura da parte del modello comporterebbe un compromesso sulla precisione. Anche il corpus è stato ampliato con dataset sintetici e reali specificamente costruiti per l’estrazione key-value e per il riconoscimento della scrittura a mano: l’azienda ha generato grandi quantità di moduli stampati e manoscritti in lingue differenti, ha raccolto form presenti sul web riempiendoli poi sinteticamente per aumentare la varietà e ha sfruttato video e altre fonti contenenti esempi eterogenei di scrittura manuale. Su questa base è stato effettuato un ampio post-training con supervised fine-tuning seguito da RLVR.
Sul fronte dei benchmark globali, Vision 2.1 raggiunge un punteggio complessivo di 87,3 su olmOCR-Bench, superando Infinity-Parser2 Pro a 86,1, Opus 5 a 85,1, Chandra-OCR2 a 84,5, Mistral OCR4 a 83,1, Gemini 3.6 Flash a 82,4 e GPT 6 Astra a 81,8. Il benchmark valuta il comportamento a livello di documento attraverso controlli pass/fail su categorie che comprendono formule matematiche da arXiv, vecchie scansioni, tabelle, documenti degradati, layout multicolonna e sequenze di testo molto piccolo. Sarvam Vision 2.1 ottiene 90,5 nella categoria Math, 99,8 in Base, 96,3 nella gestione di header e footer, 92,5 sul tiny text, 82,1 sui documenti multicolonna, 55,3 sugli old scan, 89,7 sui documenti matematici storici e 91,9 sulle tabelle. Su OmniDocBench v1.6, che misura invece fedeltà strutturale attraverso distanza di editing del testo, correttezza delle formule, struttura delle tabelle e ordine di lettura su documenti come giornali, libri di testo, riviste e report finanziari, Vision 2.1 ottiene un punteggio complessivo di 94,97, secondo soltanto a PaddleOCR-VL 1.6 con 96,01 e davanti a GLM-OCR con 94,71, GPT 6 Astra con 93,74, Gemini 3.6 Flash con 93,58 e Infinity-Parser2 Pro con 93,18. Nel dettaglio registra una text edit distance di 0,0289, un punteggio CDM per le formule di 0,988, TEDS di 0,890 sulle tabelle, TEDS-struct di 0,935 e reading order di 0,099. Sarvam sottolinea però che i benchmark generali in lingua inglese stanno diventando progressivamente saturi e che, pur rimanendo utili per confrontare i sistemi su criteri condivisi, non rappresentano necessariamente da soli la capacità di funzionare bene su flussi documentali reali; per questo il modello è stato sottoposto anche a test interni su casi d’uso produttivi più vari.
Uno degli elementi più rilevanti del rilascio è il nuovo Sarvam Indic OCR Bench, pubblicato contestualmente per misurare in maniera specifica l’accuratezza sulle 22 lingue ufficiali indiane. Il dataset comprende 6.909 campioni, di cui 6.609 distribuiti fra le 22 lingue indiane e 300 in inglese, ed è costruito per misurare in particolare accuratezza a livello di carattere e di parola. I documenti provengono da fonti differenti come quotidiani, opuscoli, libri di testo e testi storici e coprono un arco temporale che va dal 1800 a oggi, così da rappresentare l’evoluzione nel tempo sia della lingua sia delle forme grafiche delle diverse scritture. Vision 2.1 ottiene un’accuratezza complessiva dell’87,39%, davanti a Bodhan Indic-OCR con 84,94%, Gemini 3.6 Flash con 79,35%, Google Cloud Vision con 71,76%, Surya OCR 2 con 69,96%, Mistral OCR4 con 69,16%, Opus 5 con 68,81%, Gemma 4 con 65,53%, Chandra-OCR2 con 64,56% e GPT 6 Astra con 63,69%. I risultati variano in modo significativo da una lingua all’altra: il modello raggiunge 97,41% in Konkani, 97% in Nepali, 96,70% in Maithili, 95,06% in Marathi, 93,52% in Hindi, 93,47% in Bengali, 91,55% in Telugu, 91,44% in Sindhi e 91,21% in Urdu; si attesta inoltre al 90,88% in Assamese, 90,54% in Kannada, 90,48% in Bodo, 90,24% in Malayalam, 89,46% in Dogri, 89,16% in Punjabi, 88,87% in Gujarati, 87,70% in Tamil, 85,12% in Manipuri e 84,05% in Sanskrit. Rimangono invece risultati più bassi in Odia, con 80,01%, Kashmiri, con 54,82%, e Santali, con 53,91%, dove Bodhan Indic-OCR mantiene un risultato superiore pari al 68,30%. Il benchmark mostra anche differenze particolarmente marcate nelle lingue meno supportate dai sistemi generalisti: in Manipuri Vision 2.1 raggiunge 85,12% contro 0,55% di Gemini 3.6 Flash e valori prossimi allo zero per diversi altri modelli, mentre in Kashmiri ottiene 54,82% contro 36,04% di Gemini 3.6 Flash e 32,20% di Opus 5.
Sarvam descrive il miglioramento di Vision 2.1 anche attraverso il concetto di frontiera di Pareto, utilizzato per rappresentare il fatto che la document intelligence non dipende da un’unica metrica ma da capacità differenti che non necessariamente migliorano insieme, come la trascrizione corretta di scansioni storiche senza allucinazioni, la ricostruzione della struttura di una tabella o la precisione su una specifica lingua indiana. Nelle valutazioni condotte dall’azienda, il modello si colloca sulla frontiera di Pareto sia quando vengono messi in relazione olmOCR-Bench e OmniDocBench, sia nel confronto tra accuratezza su inglese e lingue indiche, perché mantiene contemporaneamente prestazioni elevate su due dimensioni che spesso risultano sbilanciate nei sistemi concorrenti. Le nuove capacità non riguardano comunque soltanto l’OCR tradizionale: Vision 2.1 può effettuare estrazione key-value da tabelle, recuperare coppie campo-valore da moduli, interpretare scrittura a mano in lingue indiane e trasformare contenuti manoscritti in dati strutturati. Sarvam mette queste funzionalità a disposizione attraverso due principali modalità operative: Digitize API converte documenti multipagina complessi, tabelle e contenuti manoscritti in testo digitale strutturato mantenendo il layout originale, mentre Extract API è destinata all’estrazione diretta di coppie chiave-valore, tabelle e campi dei moduli per realizzare workflow documentali automatizzati end-to-end. Il servizio supporta PDF fino a 10 pagine, immagini PNG e JPEG e archivi ZIP con un massimo di 10 immagini, mentre gli output di digitalizzazione possono essere prodotti in HTML, Markdown o JSON; per le attività di estrazione sono invece disponibili JSON, CSV e XLSX. Il supporto linguistico copre complessivamente 23 lingue: Hindi, Bengali, Tamil, Telugu, Marathi, Gujarati, Kannada, Malayalam, Odia, Punjabi, Assamese, Bodo, Dogri, Kashmiri, Konkani, Maithili, Manipuri, Nepali, Sanskrit, Santali, Sindhi, Urdu e inglese.
Vision 2.1 rimane inoltre collegato ad Akshar, il workbench di document intelligence di Sarvam che utilizza il modello come livello di base per workflow più completi con ragionamento ancorato al documento, comprensione del layout, estrazioni a livello di blocco e sistemi di proofreading automatizzato. Con la nuova versione, Sarvam punta quindi a estendere l’utilizzo del proprio stack oltre la semplice digitalizzazione di documenti stampati, includendo attività come elaborazione di moduli amministrativi, documenti multipagina, archivi storici, tabelle complesse e contenuti manoscritti che richiedono contemporaneamente riconoscimento linguistico, ricostruzione della struttura e produzione di dati utilizzabili direttamente da applicazioni aziendali. Il modello mantiene la natura generale di VLM ma la sua implementazione è fortemente orientata alla document intelligence e, rispetto alla prima release di febbraio, l’aggiornamento concentra gran parte del lavoro su capacità che possono incidere direttamente sui flussi produttivi: estrazione strutturata, supporto alle lingue indiane meno coperte dai modelli internazionali, riduzione delle incoerenze, miglioramento dell’inferenza e disponibilità di API progettate per elaborazioni documentali in produzione.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)