
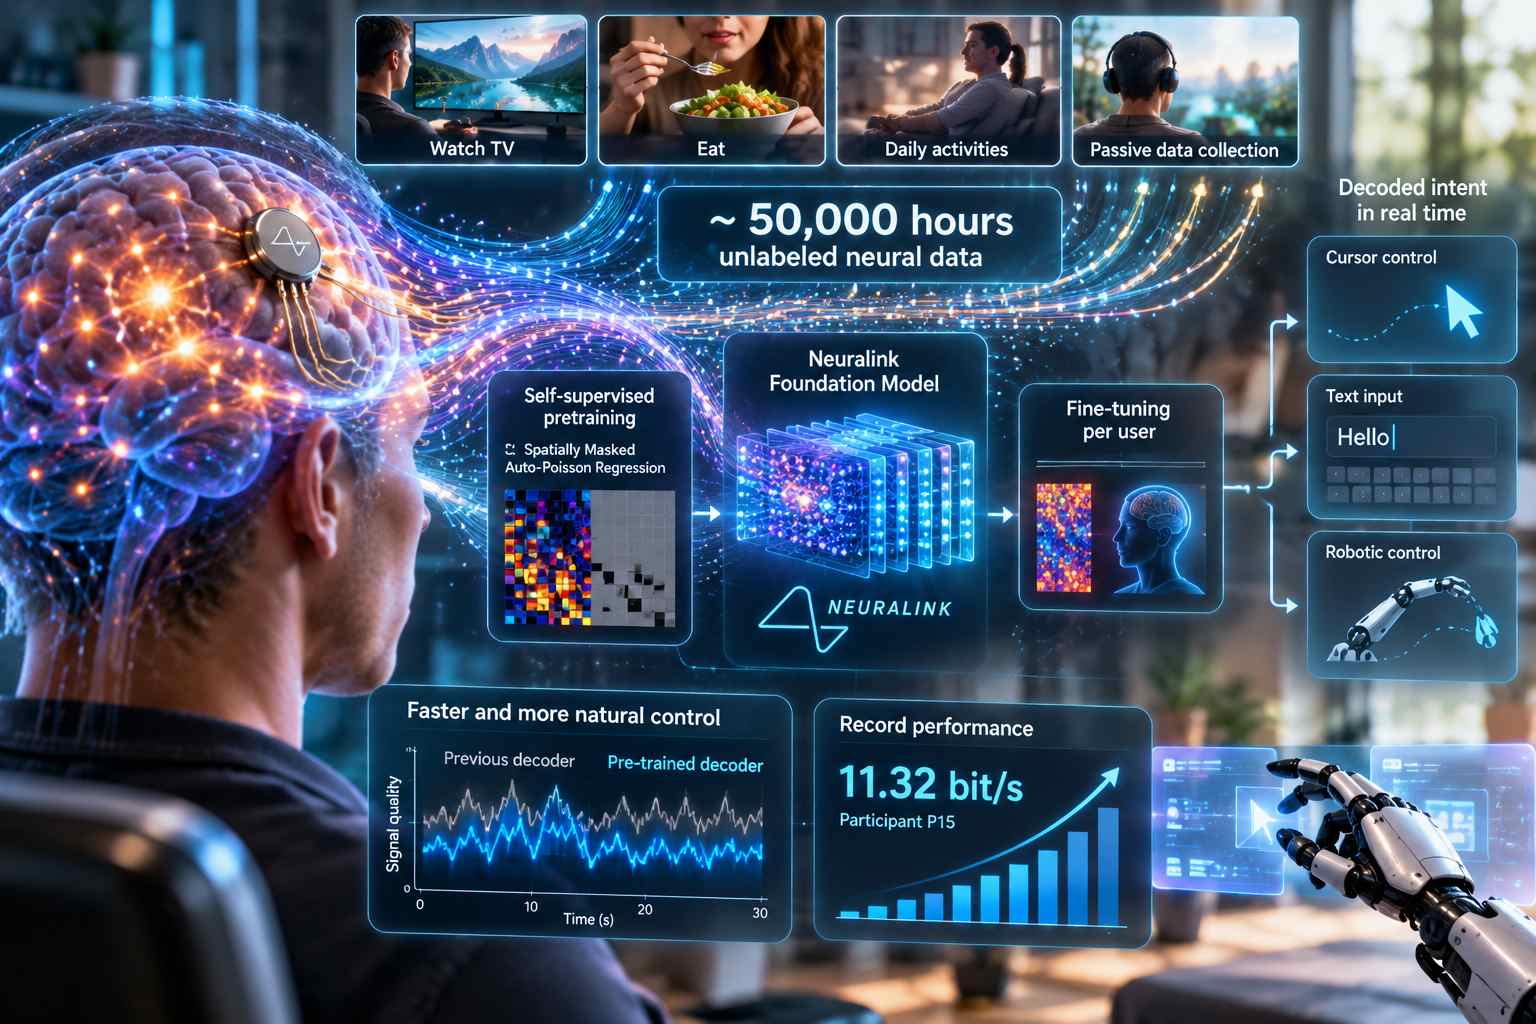
Neuralink ha pre-addestrato un modello di decodifica per interfacce cervello-computer utilizzando circa 50.000 ore di registrazioni neurali grezze non etichettate, applicando al BCI un approccio di self-supervised learning analogo a quello che ha reso possibile la crescita dei foundation model nel linguaggio naturale e nella computer vision. Il limite principale dei sistemi di decodifica tradizionali consiste nella dipendenza da dati supervisionati, che richiedono ai partecipanti clinici di eseguire ripetutamente attività strutturate come il movimento di un cursore o la produzione di testo affinché ogni pattern neurale possa essere associato a un’intenzione nota. Questo tipo di raccolta è costoso in termini di tempo e di partecipazione attiva, mentre i dati neurali privi di etichetta possono essere accumulati passivamente e in grandi quantità mentre la persona svolge normali attività quotidiane, per esempio mangia, guarda la televisione o utilizza il dispositivo senza partecipare a una specifica sessione di calibrazione. Neuralink ha quindi sfruttato questa disponibilità di segnale continuo per costruire il più grande dataset di pretraining finora dichiarato per un decoder BCI e ricavare una rappresentazione generale dell’attività neurale prima di adattarla alle intenzioni motorie di ciascun utente. L’obiettivo è separare l’apprendimento della struttura statistica del segnale cerebrale dalla successiva fase di personalizzazione, riducendo la quantità di dati etichettati necessaria per ottenere un controllo accurato e rendendo il decoder meno dipendente dalle singole sessioni di calibrazione.
Per soddisfare i requisiti di inferenza in tempo reale e bassa latenza tipici di un BCI impiantabile, Neuralink ha adottato un encoder neurale basato sull’architettura Mamba e ha trattato l’attività cerebrale come un sistema dinamico, rappresentando gli spike registrati sui diversi canali come token temporali. Il metodo di pretraining utilizzato è denominato Spatially Masked Auto-Poisson Regression: durante l’addestramento soltanto metà dei canali neurali viene fornita al modello, mentre il sistema deve prevedere l’attività della metà rimanente. In questo modo la rete non viene addestrata direttamente a ricostruire un movimento del cursore o un comando specifico, ma a comprendere le relazioni statistiche e spazio-temporali presenti nell’attività neurale stessa, apprendendo rappresentazioni condivise che possono essere successivamente riutilizzate in compiti differenti. Il ricorso alla regressione di Poisson riflette inoltre la natura degli spike neuronali, che vengono trattati come eventi discreti distribuiti nel tempo. Una volta completato il pretraining, il modello viene adattato alla singola persona attraverso pochi minuti di fine-tuning su dati nei quali l’attività neurale è effettivamente associata all’intenzione motoria desiderata. Il risultato è un decoder che parte già da una rappresentazione generale molto più ricca del segnale cerebrale e deve apprendere principalmente la corrispondenza tra quella rappresentazione e i comandi specifici dell’utente, invece di costruire l’intero modello partendo da una quantità relativamente ridotta di sessioni supervisionate.
Questo approccio mira anche a ridurre due problemi ricorrenti nelle interfacce cervello-computer impiantabili: il tempo necessario alla calibrazione iniziale e il progressivo signal drift, cioè la variazione delle caratteristiche delle registrazioni neurali nel corso del tempo. Nei sistemi tradizionali una modifica della qualità o della distribuzione degli spike può degradare rapidamente la corrispondenza appresa tra attività cerebrale e movimento, obbligando il partecipante a nuove sessioni di ricalibrazione. Un foundation model pre-addestrato su una quantità molto più ampia e diversificata di dati dovrebbe invece disporre di una rappresentazione meno fragile rispetto alle variazioni locali del segnale e conservare più stabilmente la capacità di interpretare l’attività neurale anche quando le condizioni cambiano. Neuralink riferisce che il decoder pre-addestrato ha permesso a sei partecipanti clinici di superare i propri precedenti record personali e che uno di loro, identificato come P15, ha raggiunto una velocità di 11,32 bit al secondo, valore indicato dall’azienda come nuovo record nel BCI. Un altro partecipante, P9, ha descritto il controllo ottenuto con il nuovo modello come sensibilmente più fluido e accurato rispetto ai decoder precedenti, con movimenti del cursore più naturali e una minore necessità di “forzare” mentalmente la direzione desiderata. Il miglioramento viene quindi misurato non soltanto attraverso la velocità di trasmissione delle informazioni, ma anche attraverso la stabilità e la qualità soggettiva dell’interazione continua con il sistema.
Il passaggio successivo previsto da Neuralink consiste nell’estendere il modello oltre il singolo partecipante, aggregando le registrazioni provenienti da più persone impiantate all’interno di un unico foundation model multiutente, un approccio che l’azienda definisce “Pooling Brains”. Neuralink dichiara di aver già osservato segnali di transfer learning tra modelli addestrati su persone differenti e ipotizza che l’aumento della scala dei dati possa migliorare ulteriormente la capacità del sistema di generalizzare da un utente all’altro. In prospettiva, ciò potrebbe ridurre ancora di più il fine-tuning necessario dopo l’impianto, perché una parte delle strutture utili alla decodifica verrebbe appresa in precedenza su un insieme molto più ampio di cervelli e sessioni. La direzione seguita è quindi quella già osservata in altri settori dell’AI: utilizzare grandi quantità di dati non etichettati per apprendere una rappresentazione di base, quindi specializzare rapidamente il modello con una quantità molto più piccola di esempi supervisionati. Nel caso delle BCI questo schema assume un valore particolare perché il dato supervisionato è difficile da ottenere, dipende direttamente dalla partecipazione attiva di persone con disabilità motorie e tende a cambiare nel tempo insieme alle caratteristiche della registrazione neurale.
Il lavoro arriva inoltre in una fase di forte accelerazione degli investimenti nel settore BCI, nel quale la capacità di impiantare elettrodi o altri sistemi di acquisizione non rappresenta più l’unico elemento competitivo. Precision Neuroscience ha recentemente raccolto 250 milioni di dollari in un round Series D, mentre l’attenzione del settore si sta spostando sempre più verso la qualità dello stack software necessario per trasformare grandi quantità di segnale neurale grezzo in comandi affidabili e a bassa latenza. In questo contesto, la strategia di Neuralink indica uno spostamento dal paradigma basato su decoder costruiti manualmente e fortemente dipendenti da sessioni di calibrazione verso modelli generali pre-addestrati su dataset neurali di grandi dimensioni. La quantità di dati utilizzabile diventa così una componente centrale dello sviluppo del BCI: più a lungo un impianto registra l’attività neurale durante l’utilizzo quotidiano, maggiore è la quantità di materiale non etichettato disponibile per migliorare la rappresentazione di base e, potenzialmente, per costruire modelli capaci di adattarsi più rapidamente a nuovi partecipanti, nuovi compiti e variazioni del segnale.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)