
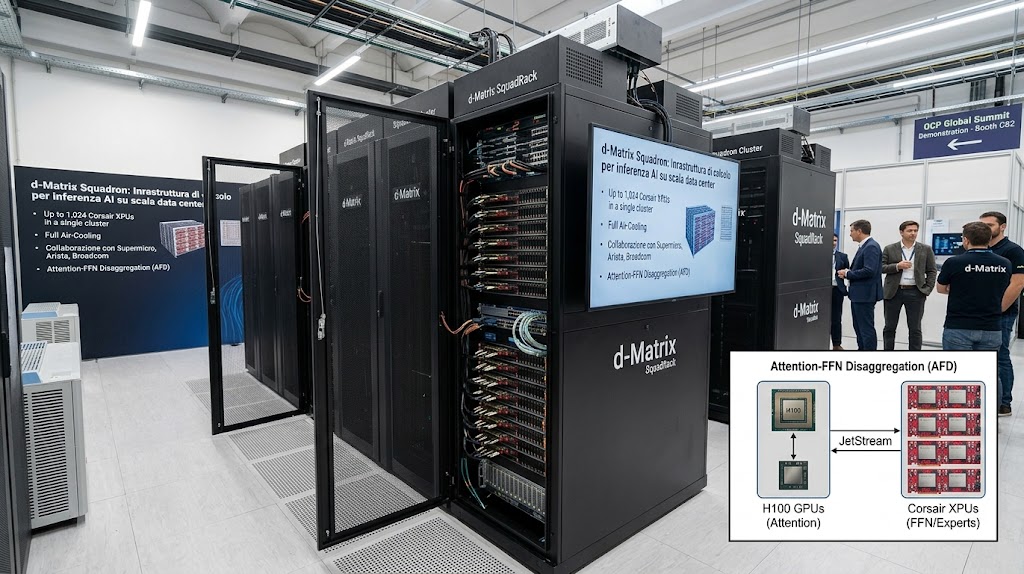
d-Matrix ha presentato Squadron, una nuova infrastruttura di calcolo destinata all’inferenza dei modelli di intelligenza artificiale su scala data center, durante l’OCP Global Summit di San Jose, in California. Il sistema, annunciato dal fondatore e amministratore delegato Sid Sheth, consente di collegare fino a 16 unità SquadRack in un unico cluster comprendente complessivamente 1.024 acceleratori Corsair XPU. La soluzione nasce dalla collaborazione tecnologica con Arista, Broadcom e Supermicro e rappresenta un’estensione dell’architettura di inferenza sviluppata dall’azienda, precedentemente disponibile attraverso singoli server Corsair e configurazioni rack-scale SquadRack. Squadron è già stato installato nel data center di d-Matrix in Arizona, dove viene impiegato nelle attività interne di ricerca e sviluppo, mentre le prime configurazioni multi-rack vengono distribuite a clienti prioritari per l’integrazione nei rispettivi centri di elaborazione. I server Corsair e i sistemi SquadRack sono invece disponibili commercialmente. L’infrastruttura è progettata per fornire una capacità di inferenza nell’ordine dei megawatt e supportare applicazioni particolarmente sensibili alla latenza, tra cui assistenti personali autonomi, generazione di codice, analisi di sicurezza informatica e operazioni finanziarie ad alta frequenza.
L’architettura Squadron è costruita mediante l’aggregazione di unità SquadRack, ciascuna costituita da un rack contenente otto server e 64 acceleratori Corsair. L’interconnessione tra i sistemi viene realizzata attraverso le schede di rete JetStream sviluppate da d-Matrix, mentre l’esecuzione dei modelli e la gestione del calcolo distribuito sono affidate allo stack software Aviator. La piattaforma utilizza PCI Express per le comunicazioni interne ai singoli nodi ed Ethernet standard per l’espansione delle risorse all’interno del rack e tra rack differenti. Questa organizzazione consente di incrementare progressivamente la capacità di elaborazione mantenendo un’architettura uniforme, dal singolo server fino alle installazioni multi-rack. d-Matrix partecipa inoltre ai consorzi UALink e Ultra Ethernet Consortium, impegnati nello sviluppo di standard aperti per le comunicazioni ad alta velocità nei sistemi accelerati. Un elemento rilevante riguarda il raffreddamento: Squadron utilizza una soluzione completamente ad aria e, secondo il produttore, può essere integrato nei data center esistenti senza richiedere infrastrutture di raffreddamento a liquido o interventi edilizi dedicati.
Le configurazioni di riferimento comprendono diversi livelli di capacità, con risorse di memoria e assorbimenti energetici differenti. Il Single-Server Starter Rack impiega otto schede acceleratrici, dispone di 16 GB di memoria ad alte prestazioni con una larghezza di banda aggregata dichiarata di 1.200 TB/s, può utilizzare fino a 2 TB di memoria di capacità e presenta un assorbimento inferiore a 10 kW. Il Dual-Server Starter Rack integra due server e 16 schede, raggiunge 32 GB di memoria ad alte prestazioni, richiede tra 10 e 30 kW e supporta l’espansione Ethernet attraverso JetStream. La configurazione Multi-Server Half-Rack comprende quattro server, 32 schede e 64 GB di memoria ad alte prestazioni, con una potenza indicativa compresa tra 30 e 100 kW. Il livello Enterprise-Ready Full Rack utilizza invece otto server e 64 schede, per un totale di 128 GB di memoria ad alte prestazioni, ed è progettato per eseguire modelli fino a 100 miliardi di parametri nella modalità prestazionale prevista dalla piattaforma. L’incremento delle risorse avviene senza modificare il modello di programmazione e le componenti software impiegate nelle configurazioni inferiori.
Il sistema Squadron costituisce l’evoluzione di SquadRack, presentato nell’ottobre 2025 come infrastruttura specificamente progettata per l’inferenza generativa a livello di rack. Alla base della soluzione si trovano gli acceleratori Corsair, basati su un’organizzazione a chiplet e su un’architettura di memoria concepita per ridurre le limitazioni associate agli accessi continui alla memoria esterna. La tecnologia 3DIMC di d-Matrix prevede l’integrazione tridimensionale di memoria DRAM direttamente sul die logico, mentre la struttura dei chiplet consente di ampliare la disponibilità di SRAM ad altissima larghezza di banda. Gli acceleratori operano all’interno di server Supermicro X14, utilizzando switch PCIe Broadcom per le comunicazioni locali e switch Ethernet Arista per la connessione dei nodi attraverso JetStream. Aviator integra compilatore e runtime, sviluppati congiuntamente all’hardware per ottimizzare il posizionamento dei dati e l’esecuzione delle operazioni di inferenza. Per la precedente generazione SquadRack, d-Matrix aveva dichiarato miglioramenti fino a tre volte nel rapporto costo-prestazioni e nell’efficienza energetica, oltre a una generazione dei token fino a dieci volte più rapida rispetto agli acceleratori tradizionali. Si tratta di prestazioni dichiarate dall’azienda, riferite alle configurazioni e ai carichi di lavoro utilizzati nelle proprie valutazioni.
Una delle novità tecniche associate al lancio è l’implementazione della cosiddetta Attention-FFN Disaggregation, indicata con l’acronimo AFD, che permette di separare le operazioni di attenzione dalle reti feed-forward dei modelli linguistici e di assegnarle a dispositivi differenti. Nella dimostrazione realizzata da d-Matrix, le GPU NVIDIA H100 gestiscono il meccanismo di attenzione, gli embedding, la memoria KV cache e l’instradamento degli esperti, mentre gli acceleratori Corsair eseguono le operazioni degli esperti e delle reti feed-forward. Il carico sperimentale impiega GPT-OSS-20B, un modello mixture-of-experts con 20,9 miliardi di parametri complessivi, dei quali 19,12 miliardi appartengono agli esperti. Durante ogni inferenza vengono attivati quattro esperti su 32, corrispondenti a circa 3,6 miliardi di parametri. Utilizzando una rappresentazione a quattro bit, i parametri degli esperti possono essere collocati nei 16 GB di SRAM disponibili su un server Corsair con otto schede. Nella configurazione descritta, due GPU H100 condividono gli otto acceleratori Corsair con un batch di 64 richieste.
La separazione delle operazioni è resa possibile dalla larghezza di banda della SRAM Corsair, per la quale d-Matrix dichiara 150 TB/s, un valore indicato come circa 45 volte superiore alla banda HBM3 di una NVIDIA H100 e circa nove volte superiore ai 18 TB/s attribuiti alla tecnologia HBM4 nel confronto aziendale. Nel test con una lunghezza di contesto di 1.000 token, lo spostamento delle operazioni feed-forward da una singola H100 agli acceleratori Corsair ha ridotto il tempo per token in uscita da 2,59 a 1,28 millisecondi, una diminuzione prossima al 50%. La comunicazione tra GPU e acceleratori comporta 24 scambi per i 24 livelli del modello, ai quali si aggiunge un passaggio per la testa di generazione linguistica, o LM head. La GPU trasmette un vettore di stato nascosto di 2.880 dimensioni e le informazioni relative agli esperti selezionati attraverso collegamenti JetStream con una capacità Ethernet dichiarata di 400 Gb/s per cluster. Il meccanismo di comunicazione avviata dal dispositivo consente alla GPU di scrivere direttamente nella memoria Corsair e agli acceleratori di restituire i risultati senza coinvolgere la CPU host nei trasferimenti intermedi.
L’ottimizzazione riguarda anche la LM head, suddivisa in porzioni distribuite sulle singole schede Corsair, con una riduzione dichiarata di dieci volte dei tempi necessari alla sua elaborazione. Con un batch di 64 richieste e una lunghezza di contesto pari a 129 token, l’architettura completa un passaggio di decodifica per tutti i 64 utenti in 2,46 millisecondi. d-Matrix riporta una velocità di 845 token al secondo per utente nella configurazione dimostrativa e un throughput aggregato di 20.415 token al secondo con 64 utenti concorrenti; i valori si riferiscono alle specifiche condizioni sperimentali dichiarate e non costituiscono una misura universale delle prestazioni di Squadron. L’azienda considera la distribuzione separata di attenzione e reti feed-forward applicabile anche a modelli con centinaia di miliardi di parametri, indicando le famiglie GLM 5.x e Kimi K3 tra i possibili obiettivi di successive implementazioni. La dimostrazione pubblica dell’architettura AFD è programmata presso lo stand C82 dell’OCP Global Summit per il 14 ottobre 2026 alle 11:00 e alle 14:00, ora del Pacifico, e per il 15 ottobre alle 11:00. Con Squadron, d-Matrix estende così la propria offerta dai singoli acceleratori a infrastrutture complete di inferenza distribuita, comprendenti componenti di calcolo, memoria, rete e software di esecuzione.