
CTGT, società specializzata nell’interpretabilità applicata dei sistemi di intelligenza artificiale, ha rilasciato Concordance, uno strumento open source progettato per identificare le cause delle differenze decisionali prodotte dalle applicazioni AI durante esecuzioni ripetute dello stesso processo. Distribuito con licenza Apache 2.0, Concordance comprende un protocollo di testing, un’implementazione di riferimento e i dati sperimentali utilizzati per documentarne il funzionamento. La licenza consente alle organizzazioni di utilizzare, modificare e integrare commercialmente il software senza costi di licenza, mentre CTGT ha dichiarato di non prevedere versioni a pagamento o servizi hosted dedicati a Concordance. La soluzione affronta un problema specifico dei sistemi agentici aziendali: la possibilità che un’applicazione produca decisioni differenti anche quando il documento iniziale, l’obiettivo operativo e il modello linguistico rimangono invariati. Le cause di queste discrepanze non dipendono necessariamente dalla natura probabilistica del modello, ma possono derivare dalle trasformazioni introdotte dal software che prepara le richieste, gestisce lo stato dell’applicazione e coordina le successive operazioni. Concordance è stato sviluppato per ricostruire questi passaggi, confrontare le esecuzioni e individuare il primo punto in cui i risultati cominciano a divergere, distinguendo il comportamento del modello da quello dell’infrastruttura applicativa che lo utilizza.
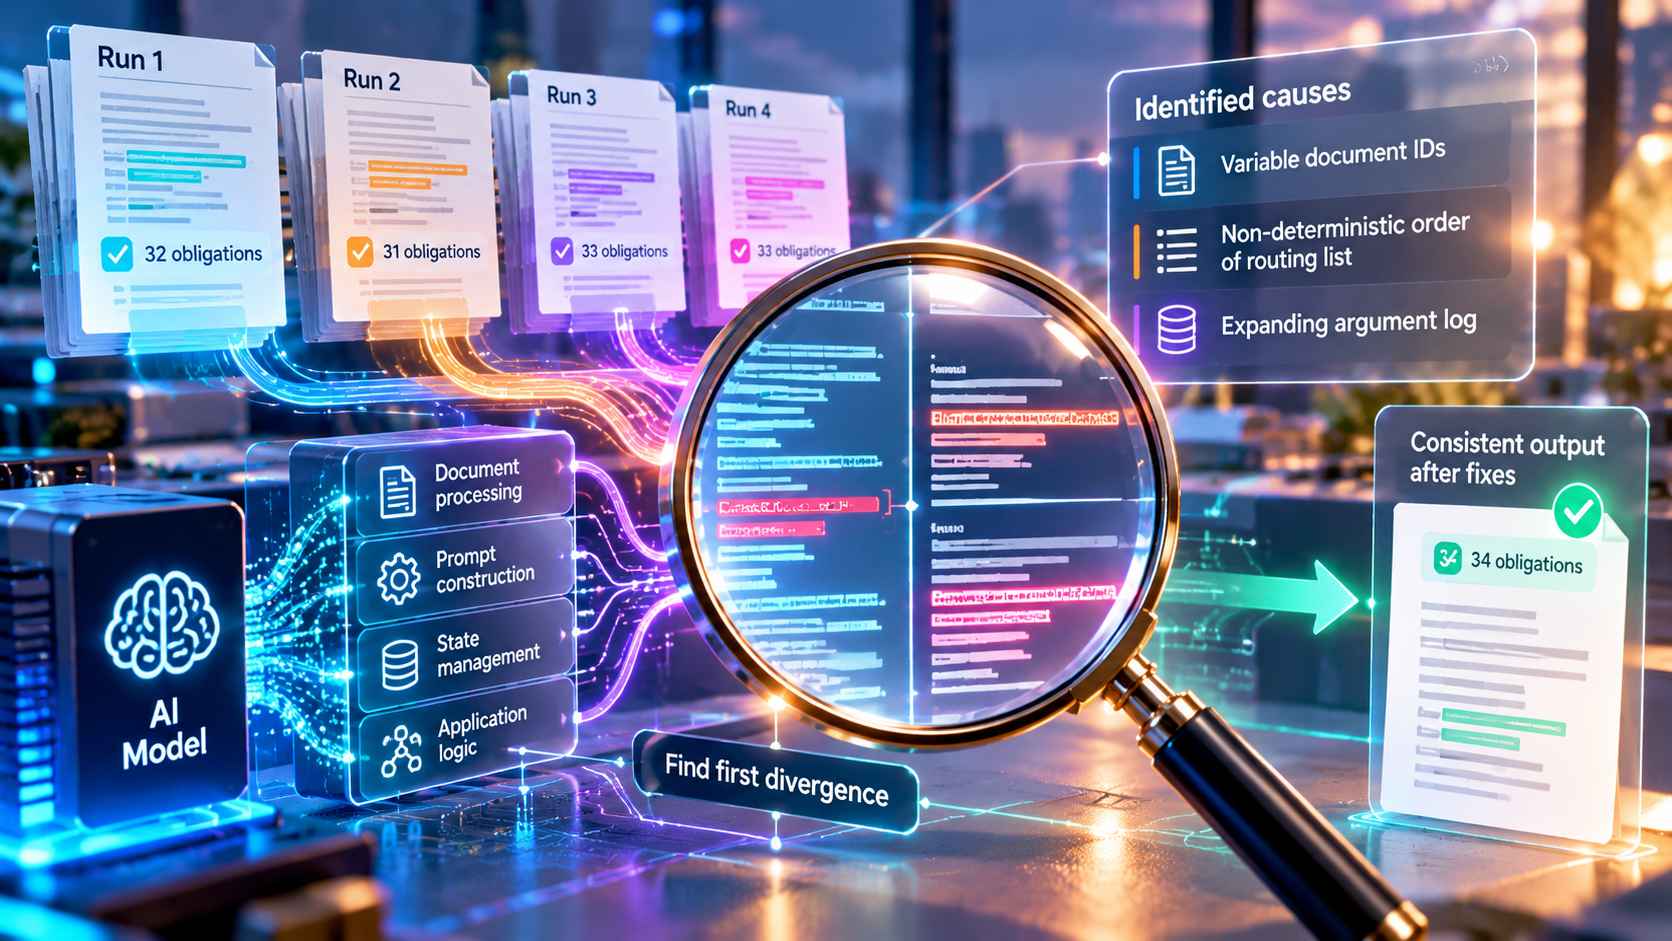
Il progetto nasce da un’anomalia osservata in una delle applicazioni di conformità normativa sviluppate internamente da CTGT. La società, fondata e guidata da Cyril Gorlla e attiva nello studio del comportamento dei modelli e dei sistemi software in settori regolamentati come quello bancario e assicurativo, ha sottoposto un manuale bancario retail di nove pagine a quattro elaborazioni consecutive finalizzate all’estrazione degli obblighi di conformità. L’esperimento ha utilizzato il modello Qwen3.8-27B con la modalità di inferenza deterministica di SGLang, ottenendo rispettivamente 32, 31, 33 e 33 obblighi. Le quattro elaborazioni hanno prodotto insiemi differenti di risultati, anche nei casi in cui il numero complessivo degli obblighi coincideva. Una delle differenze riguardava l’omissione di un requisito che prevedeva l’escalation di una questione particolarmente grave al responsabile della conformità. L’analisi delle richieste effettivamente trasmesse al modello ha però mostrato un comportamento differente da quello inizialmente ipotizzabile: tutte le 74 richieste identiche ripetute durante le quattro esecuzioni avevano generato risposte coerenti. La variabilità osservata non derivava quindi, in quel caso, da risposte differenti a prompt identici, ma dal fatto che l’applicazione costruiva richieste non perfettamente uguali durante le successive elaborazioni dello stesso manuale.
L’indagine ha individuato tre meccanismi responsabili delle divergenze. Il primo riguardava la presenza nei prompt di identificatori generati per ciascun caricamento del documento, che cambiavano tra un’esecuzione e l’altra nonostante il contenuto informativo rimanesse invariato. Il secondo dipendeva dall’ordine variabile di un elenco di instradamento composto da 30 elementi, utilizzato nel processo di elaborazione. Il terzo era collegato a un registro degli argomenti che veniva progressivamente ampliato durante il funzionamento dell’applicazione, modificando di conseguenza il contenuto delle richieste successive. In una delle comparazioni, la differenza tra due prompt di 12.525 caratteri era limitata a quattro righe contenenti identificatori, ma questa variazione aveva contribuito a produrre classificazioni differenti. In particolare, cinque regole relative alla risoluzione dei conflitti erano state interpretate dal modello come informazioni di contesto anziché come obblighi operativi, determinando la loro omissione in un’esecuzione che avrebbe dovuto conservarle. CTGT ha quindi sostituito gli identificatori variabili con etichette stabili, introdotto un ordinamento deterministico degli elenchi e isolato ciascun test all’interno di un ambiente organizzativo inizializzato nuovamente. Dopo queste modifiche, cinque elaborazioni consecutive hanno restituito tutte lo stesso insieme di 34 obblighi. Per confrontare correttamente i risultati archiviati è rimasta necessaria la normalizzazione degli identificatori specifici dei caricamenti, mentre gli output intermedi di parsing e interpretazione coincidevano senza ulteriori trasformazioni.
Concordance formalizza questa procedura attraverso la cattura delle richieste effettivamente inviate ai modelli, la registrazione delle risposte e il confronto degli output generati nelle diverse fasi dell’elaborazione. Il sistema permette di distinguere due categorie di problemi: la variabilità delle risposte quando un modello riceve richieste identiche e la variabilità introdotta dai componenti applicativi che alterano le richieste prima dell’inferenza. La prima categoria riguarda anche il livello di serving, nel quale modifiche alla composizione dei batch e all’esecuzione numerica possono influenzare il risultato, persino quando la configurazione di generazione limita la casualità. La seconda comprende le trasformazioni dei dati, l’ordinamento delle informazioni, la gestione degli identificatori, la persistenza dello stato e l’evoluzione del contesto elaborato dagli agenti. CTGT ha utilizzato la modalità deterministica di SGLang, collegata alla ricerca sulle variazioni numeriche dell’inferenza, per ridurre la variabilità del comportamento del modello. In un esperimento separato sul serving, Qwen3.8-27B ha riprodotto esattamente la risposta di controllo in tutte le 800 richieste sottoposte alla configurazione deterministica. Questo risultato misura tuttavia l’identità testuale delle risposte e non la loro correttezza. Nel test di conformità, infatti, la ripetizione della richiesta associata a una classificazione errata ha riprodotto lo stesso errore per otto volte consecutive, dimostrando che la ripetibilità del risultato non equivale alla validità della decisione.
La distinzione tra coerenza e correttezza costituisce un limite esplicito della metodologia sperimentale. Concordance consente di individuare dove emergono le divergenze, ma non dimostra automaticamente che gli obblighi estratti siano conformi alle disposizioni applicabili o che un sistema agentico non possa violare le politiche aziendali. CTGT indica tra i successivi obiettivi di misurazione la capacità di verificare se una decisione rimane aderente alle regole anche quando cambia la formulazione linguistica delle informazioni ricevute. Si tratta di un problema diverso dalla semplice riproduzione dello stesso output, perché richiede di valutare la stabilità semantica del comportamento rispetto a input differenti ma equivalenti sul piano normativo o operativo. Inoltre, l’esperimento pubblicato riguarda una singola applicazione interna e un solo documento bancario, senza dati sufficienti per stabilire quanto frequentemente le medesime anomalie si presentino nelle implementazioni aziendali di altri fornitori o in processi differenti.
Un approccio complementare alla gestione delle decisioni consiste nell’utilizzo di modelli specializzati che producono un insieme vincolato di risposte, anziché generare liberamente istruzioni operative. In questa categoria rientra Jev di TypeSafe, basato sull’approccio System One, che permette di definire scelte ammissibili e ottenere valutazioni, punteggi e probabilità utilizzabili dal software applicativo. AWS include Jev, SemIf e Strands Decider 2B nell’ambito dei modelli orientati alle decisioni. Nell’architettura suggerita da TypeSafe, il controllo dei workflow e l’applicazione delle regole aziendali deterministiche restano affidati al codice, mentre il modello AI svolge compiti circoscritti di classificazione o interpretazione di informazioni non strutturate. In una procedura di conformità, ad esempio, il modello potrebbe identificare la presenza di una determinata tipologia di conflitto, lasciando al software il compito di applicare obbligatoriamente l’escalation prevista dalla politica aziendale. Questo modello architetturale riduce la dipendenza delle azioni obbligatorie dalle decisioni autonome dell’agente, ma non elimina la possibilità che una classificazione sia errata o che una fase precedente abbia omesso informazioni necessarie. La limitazione delle risposte a uno schema predefinito impedisce la produzione di output estranei alle opzioni consentite, senza garantire che venga selezionata quella corretta.
La documentazione relativa a Jev 1.13 segnala inoltre sensibilità all’ordine delle opzioni e alla presenza di contesto irrilevante. In una dimostrazione di autoconsistenza, TypeSafe ha osservato variazioni delle etichette in due domande su otto durante prove ripetute che introducevano un identificatore differente in ciascuna richiesta. L’instradamento dei risultati incerti verso la revisione umana ha migliorato il livello di accordo, senza rendere il sistema deterministico. Poiché le richieste non erano identiche, questa osservazione non permette di concludere che il modello produca risultati instabili con input perfettamente uguali. CTGT non ha inoltre pubblicato confronti sperimentali tra Concordance e Jev sul caso bancario utilizzato per la dimostrazione. I due approcci intervengono su livelli differenti: i modelli decisionali circoscrivono il tipo di giudizio richiesto all’AI e consentono di mantenere le regole operative nel codice, mentre Concordance analizza la riproducibilità dell’intero processo e identifica i punti in cui cambiano dati, richieste o risposte.
Concordance è concepito per affiancare gli strumenti già disponibili per il tracing e la valutazione delle applicazioni AI. Piattaforme come LangSmith consentono di eseguire valutazioni ripetute, osservare le decisioni intermedie degli agenti e confrontare versioni differenti delle applicazioni; Braintrust supporta prove multiple e tracciamento di chiamate ai modelli, funzioni e strumenti; Langfuse registra prompt, risposte, operazioni di recupero delle informazioni e attività degli strumenti, integrando valutazioni e gestione dei prompt; Arize Phoenix utilizza OpenTelemetry e OpenInference per raccogliere tracce e analizzare esperimenti e modifiche applicative. La specificità dichiarata di Concordance consiste nella procedura focalizzata sulla ripetizione dello stesso lavoro, sull’allineamento delle fasi di elaborazione e sull’identificazione della prima divergenza riconducibile a input modificati oppure a risposte differenti. CTGT non ha presentato benchmark comparativi che dimostrino l’impossibilità di individuare gli stessi problemi attraverso le piattaforme esistenti, le cui funzionalità risultano in parte sovrapponibili. La società mantiene separato da Concordance il proprio motore commerciale per l’applicazione delle politiche negli ambienti regolamentati e dispone inoltre di LineageEval, un precedente framework di valutazione associato a un’esperienza riferita da Gorlla, nella quale una società di consulenza non identificata avrebbe individuato falsi positivi trascurati. Tale esperienza non costituisce però una validazione indipendente di Concordance. Il rilascio open source mette a disposizione un metodo riproducibile per esaminare le discrepanze decisionali lungo l’intera pipeline applicativa, con particolare riferimento ai sistemi che elaborano documenti, estraggono obblighi e producono risultati destinati a processi aziendali soggetti a controlli e verifiche.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)