
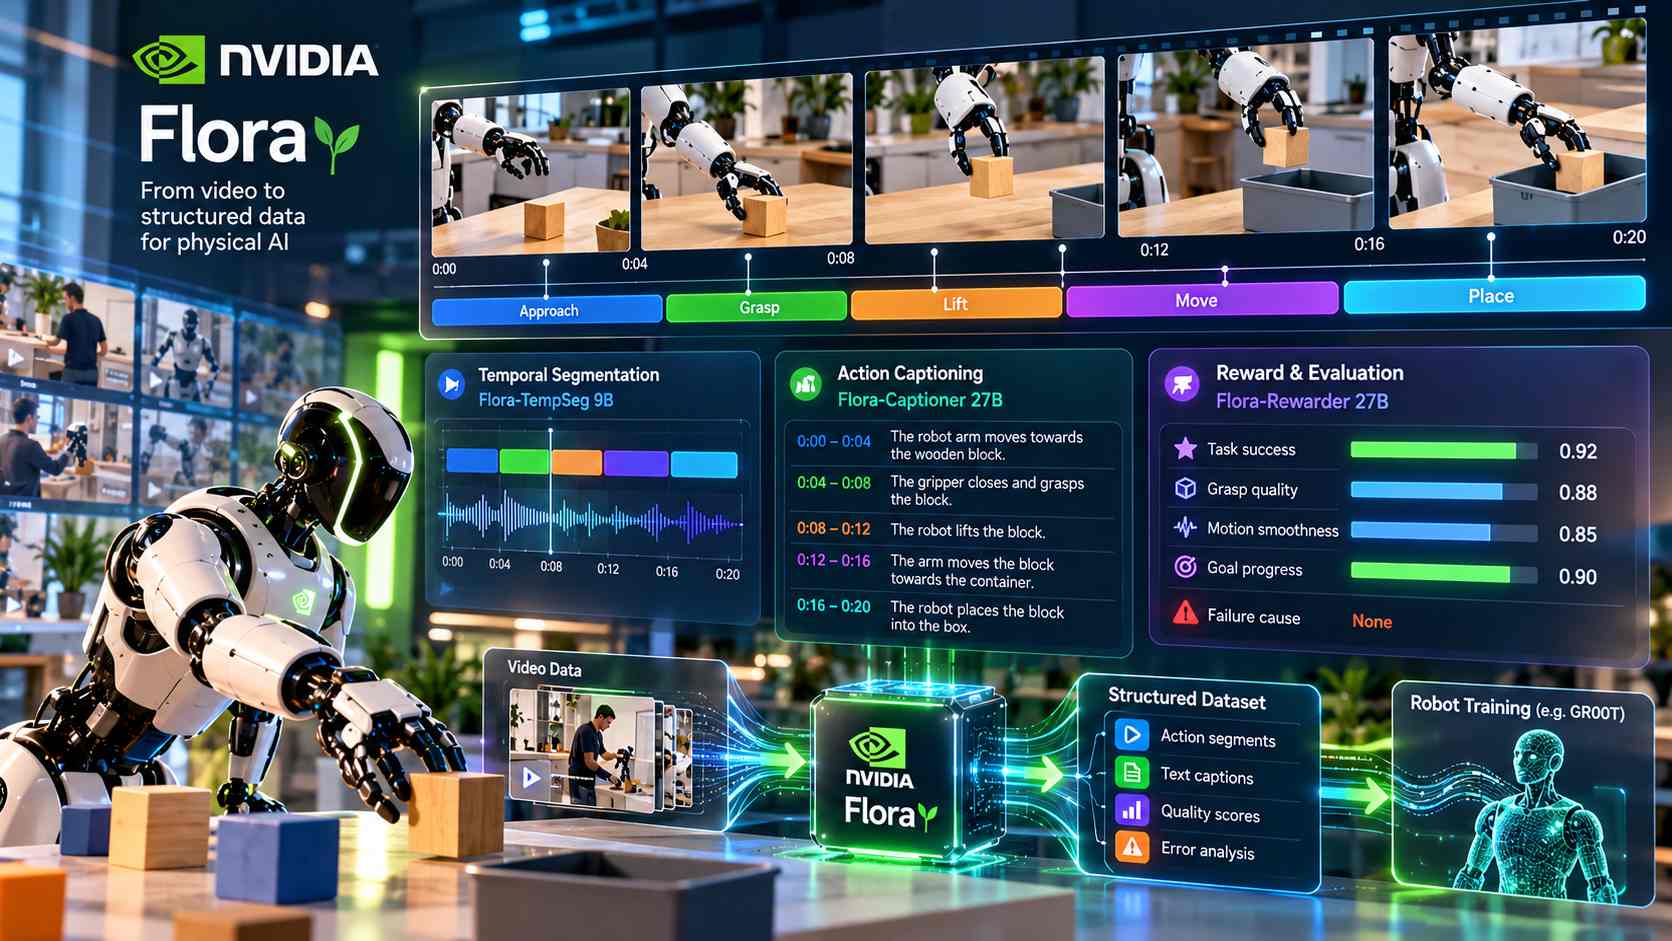
NVIDIA ha presentato Flora, una famiglia di modelli aperti progettati per trasformare registrazioni video di attività umane e robotiche in dati strutturati utilizzabili nell’addestramento e nella valutazione dei sistemi di intelligenza artificiale fisica. La piattaforma automatizza la segmentazione temporale delle azioni, la descrizione dei movimenti e l’attribuzione di valutazioni relative alla qualità dell’esecuzione e alle cause degli eventuali errori. I pesi dei modelli sono stati pubblicati su Hugging Face e l’azienda utilizza già Flora nel processo di preparazione dei dati destinati a GR00T, il proprio foundation model per la robotica umanoide. Secondo NVIDIA, la nuova infrastruttura può ridurre fino a circa 125 volte il costo di annotazione rispetto a una configurazione basata su modelli commerciali di grandi dimensioni. La soluzione affronta un problema specifico dell’addestramento robotico: per insegnare a una macchina a eseguire un’attività non è sufficiente disporre di filmati, ma occorre identificare quali azioni vengono compiute, quando iniziano e terminano, quali risultati producono e in quale fase si verifica un eventuale fallimento.
L’architettura di Flora comprende tre modelli specializzati. Flora-TempSeg 9B individua i segmenti temporali corrispondenti alle differenti fasi di un’attività, separando il compito principale dalle azioni elementari che lo compongono. Flora-Captioner 27B genera descrizioni testuali associate a intervalli temporali, permettendo di collegare ogni movimento a un’indicazione interpretabile durante l’addestramento. Flora-Rewarder 27B valuta invece la qualità delle azioni, il progresso nell’esecuzione del compito e le condizioni che determinano il successo oppure il fallimento. I tre modelli svolgono quindi funzioni complementari: uno identifica la struttura temporale dell’attività, un secondo ne produce la rappresentazione linguistica e il terzo costruisce informazioni utilizzabili come segnali di valutazione e apprendimento. La separazione delle funzioni permette di elaborare i video attraverso più fasi specializzate, anziché affidare l’intera annotazione a un singolo modello generativo.
Nel caso di un robot incaricato di afferrare e spostare un oggetto, Flora può identificare il momento in cui inizia l’avvicinamento, distinguere la fase di presa da quella di sollevamento e registrare quando l’oggetto viene correttamente trattenuto oppure scivola dalla pinza. Il sistema può associare a questi eventi descrizioni temporizzate e valutazioni del risultato, costruendo una rappresentazione più ricca della semplice sequenza di immagini. Flora è in grado di analizzare sia registrazioni effettuate da robot sia video di attività umane, comprese riprese in prima persona. Questa caratteristica permette di utilizzare fonti di dati differenti, ampliando il materiale disponibile per sviluppare modelli di manipolazione e controllo. Le annotazioni temporali possono essere utilizzate durante il preaddestramento per selezionare e bilanciare i dati, mentre i punteggi di ricompensa e le informazioni sugli errori sono destinati anche all’apprendimento per rinforzo e alla valutazione delle prestazioni dei robot già distribuiti.
NVIDIA dichiara di poter utilizzare 512 server GPU GB300 per elaborare fino a 200.000 ore di registrazioni video al giorno attraverso il proprio sistema di preparazione dei dati. Le valutazioni interne indicano che Flora raggiunge una qualità delle annotazioni confrontabile con quella di modelli multimodali commerciali molto più grandi. In un test effettuato su 50 episodi, Flora ha ottenuto un punteggio del 57,1%, rispetto al 53,7% registrato da GPT-6 Astra nella configurazione di ragionamento più elevata. Le prestazioni non risultano tuttavia uniformemente superiori in tutte le categorie: Flora ha ottenuto risultati migliori nella segmentazione temporale di alcune attività umane, mentre Astra ha mantenuto un vantaggio in specifiche valutazioni relative ai video robotici. Il confronto evidenzia come l’efficacia della specializzazione dipenda dal tipo di operazione richiesta e dalle caratteristiche dei dati analizzati.
Le prove sulle informazioni di ricompensa hanno mostrato ulteriori differenze. Nel benchmark RoboReward, Flora ha registrato un errore assoluto medio pari a 40,0, inferiore al valore di 55,4 ottenuto da Astra. Nel DenseRewardBench, utilizzato anche per verificare la capacità di individuare i casi di fallimento, Flora ha raggiunto una recall del 53,3%. Questi risultati indicano la possibilità di utilizzare i modelli non soltanto per descrivere le azioni, ma anche per costruire strumenti automatici di controllo della qualità delle esecuzioni. Le metriche devono comunque essere interpretate in relazione ai singoli benchmark e non rappresentano una garanzia di accuratezza uniforme per ogni categoria di robot, ambiente o attività.
La riduzione dei costi deriva principalmente dalla possibilità di eseguire localmente un insieme di modelli specializzati anziché utilizzare servizi commerciali multimodali per tutte le annotazioni. NVIDIA stima che, utilizzando otto GPU GB300 al costo di 10 dollari l’ora ciascuna, Flora possa elaborare un’ora di video originale con una spesa di circa 0,72 dollari. Un’elaborazione equivalente attraverso GPT-6 Astra, nella configurazione con massimo sforzo di ragionamento, viene stimata in 88,49 dollari per ora di video. Il rapporto fra i due valori corrisponde a un risparmio di circa 122-125 volte nelle condizioni sperimentali considerate. La differenza economica diventa particolarmente significativa quando i dati da annotare raggiungono centinaia di migliaia di ore, come previsto nei programmi di addestramento dei foundation model robotici. Flora rende quindi disponibili strumenti specializzati per convertire grandi archivi video in sequenze strutturate di azioni, descrizioni e valutazioni, utilizzabili nelle differenti fasi di sviluppo dei sistemi robotici.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)