
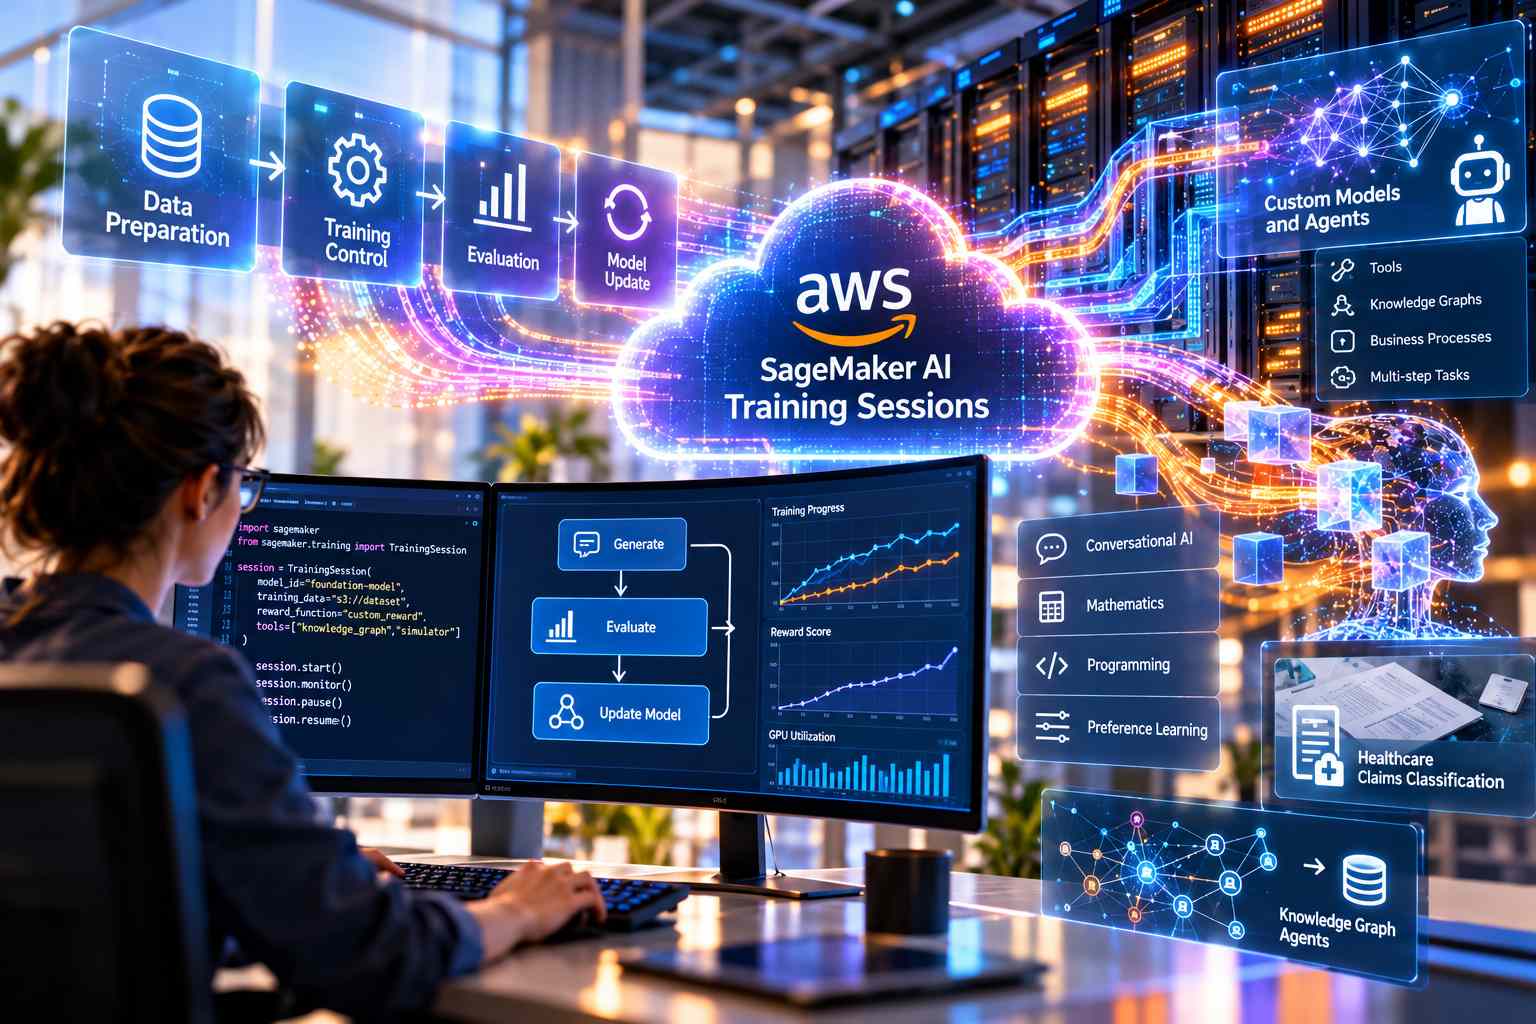
Amazon Web Services ha reso disponibile Training Sessions, una nuova funzionalità di Amazon SageMaker AI progettata per consentire agli sviluppatori di controllare in modo dettagliato l’addestramento e il perfezionamento dei modelli di intelligenza artificiale senza amministrare direttamente l’infrastruttura GPU. Il servizio separa la definizione delle procedure di apprendimento dalle operazioni necessarie alla loro esecuzione, permettendo ai team tecnici di programmare le sequenze di generazione, valutazione e aggiornamento dei modelli mentre AWS gestisce l’allocazione delle risorse, il coordinamento dei calcoli distribuiti, il ripristino dopo eventuali errori e il salvataggio dello stato di addestramento. La funzionalità è destinata in particolare alla personalizzazione dei modelli per attività aziendali specializzate e allo sviluppo di agenti capaci di utilizzare strumenti esterni, rispettare procedure operative e completare sequenze di lavoro composte da più passaggi. Training Sessions amplia le possibilità di personalizzazione precedentemente disponibili in SageMaker, che già supportava il fine-tuning e il reinforcement learning attraverso Training Jobs e altri strumenti gestiti. La novità consiste nella combinazione tra la flessibilità delle procedure di addestramento definite dal cliente e un’infrastruttura gestita che riduce la necessità di configurare istanze GPU, ambienti software e meccanismi di distribuzione dei calcoli.
Il servizio permette di controllare le singole operazioni di apprendimento attraverso chiamate API, mantenendo la possibilità di intervenire sulla sequenza delle attività e sui criteri utilizzati per misurare i risultati. Gli sviluppatori possono definire i dati e gli ambienti di addestramento, collegare gli agenti a strumenti o simulatori, impostare funzioni di ricompensa personalizzate e stabilire come utilizzare le valutazioni ottenute per aggiornare i parametri del modello. AWS ha illustrato questo funzionamento attraverso il Group Relative Policy Optimization, una tecnica di reinforcement learning nella quale il modello genera diverse risposte alla stessa richiesta e una funzione di valutazione assegna punteggi ai risultati. L’aggiornamento della politica viene quindi calcolato utilizzando le differenze relative tra i punteggi, ripetendo il procedimento per orientare progressivamente il comportamento del modello. Training Sessions permette di interrompere temporaneamente la procedura, esaminare i risultati e modificare il flusso di apprendimento senza dover ricostruire l’intero ambiente computazionale. Il modello può rimanere caricato nella memoria GPU durante le operazioni, evitando la necessità di predisporre un endpoint di inferenza separato per ogni fase sperimentale. Le tecniche di personalizzazione considerate comprendono Low-Rank Adaptation, che aggiorna un insieme limitato di parametri aggiuntivi, e il fine-tuning completo, che interviene sull’insieme dei parametri del modello. La compatibilità effettiva delle singole tecniche rimane subordinata ai modelli e alle configurazioni supportati dal servizio.
AWS ha accompagnato il lancio con esempi di utilizzo e materiali tecnici dedicati alla personalizzazione conversazionale, alla matematica, alla programmazione e all’apprendimento delle preferenze. Sono inoltre disponibili strumenti progettati per assistere i processi di preparazione, addestramento, valutazione e distribuzione attraverso ambienti di sviluppo che comprendono Kiro, Claude Code, Codex e GitHub Copilot. L’azienda ha presentato due applicazioni iniziali. ImagineSoftware ha utilizzato Training Sessions per sviluppare un modello basato sul reinforcement learning destinato alla classificazione dei casi di rigetto delle richieste di rimborso sanitario, un’attività nella quale le caratteristiche delle pratiche e le regole operative richiedono criteri di valutazione specifici. Karini AI ha invece personalizzato il modello open-weight gpt-oss-20b per realizzare un agente capace di interagire attraverso più passaggi con un knowledge graph ospitato su Amazon Neptune. In questo caso, la procedura di apprendimento riguarda non soltanto la produzione di risposte, ma anche la selezione delle operazioni, l’utilizzo delle informazioni presenti nel grafo e il completamento di una sequenza di interazioni. I primi utilizzatori hanno evidenziato la possibilità di definire direttamente le operazioni di apprendimento, conservare i progressi raggiunti e riprendere gli esperimenti senza ricostruire la configurazione delle risorse computazionali.
Training Sessions è concepito come un ambiente per il post-training e l’adattamento di modelli già preaddestrati, non come un sistema che rende superflue le attività di progettazione e verifica dell’apprendimento. La qualità dei risultati dipende ancora dalla rappresentatività dei dati, dalla corretta definizione delle ricompense e dalla capacità di valutare le prestazioni su situazioni non presenti negli esempi di addestramento. Per gli agenti aziendali è particolarmente importante distinguere la correttezza linguistica di una risposta dalla corretta esecuzione di un processo, considerando anche l’utilizzo appropriato degli strumenti, il rispetto delle autorizzazioni e il raggiungimento dello stato finale previsto. Il servizio trasferisce ad AWS la gestione operativa di una parte rilevante dell’infrastruttura necessaria agli esperimenti, lasciando agli sviluppatori la definizione della logica di apprendimento e delle condizioni di successo.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)