
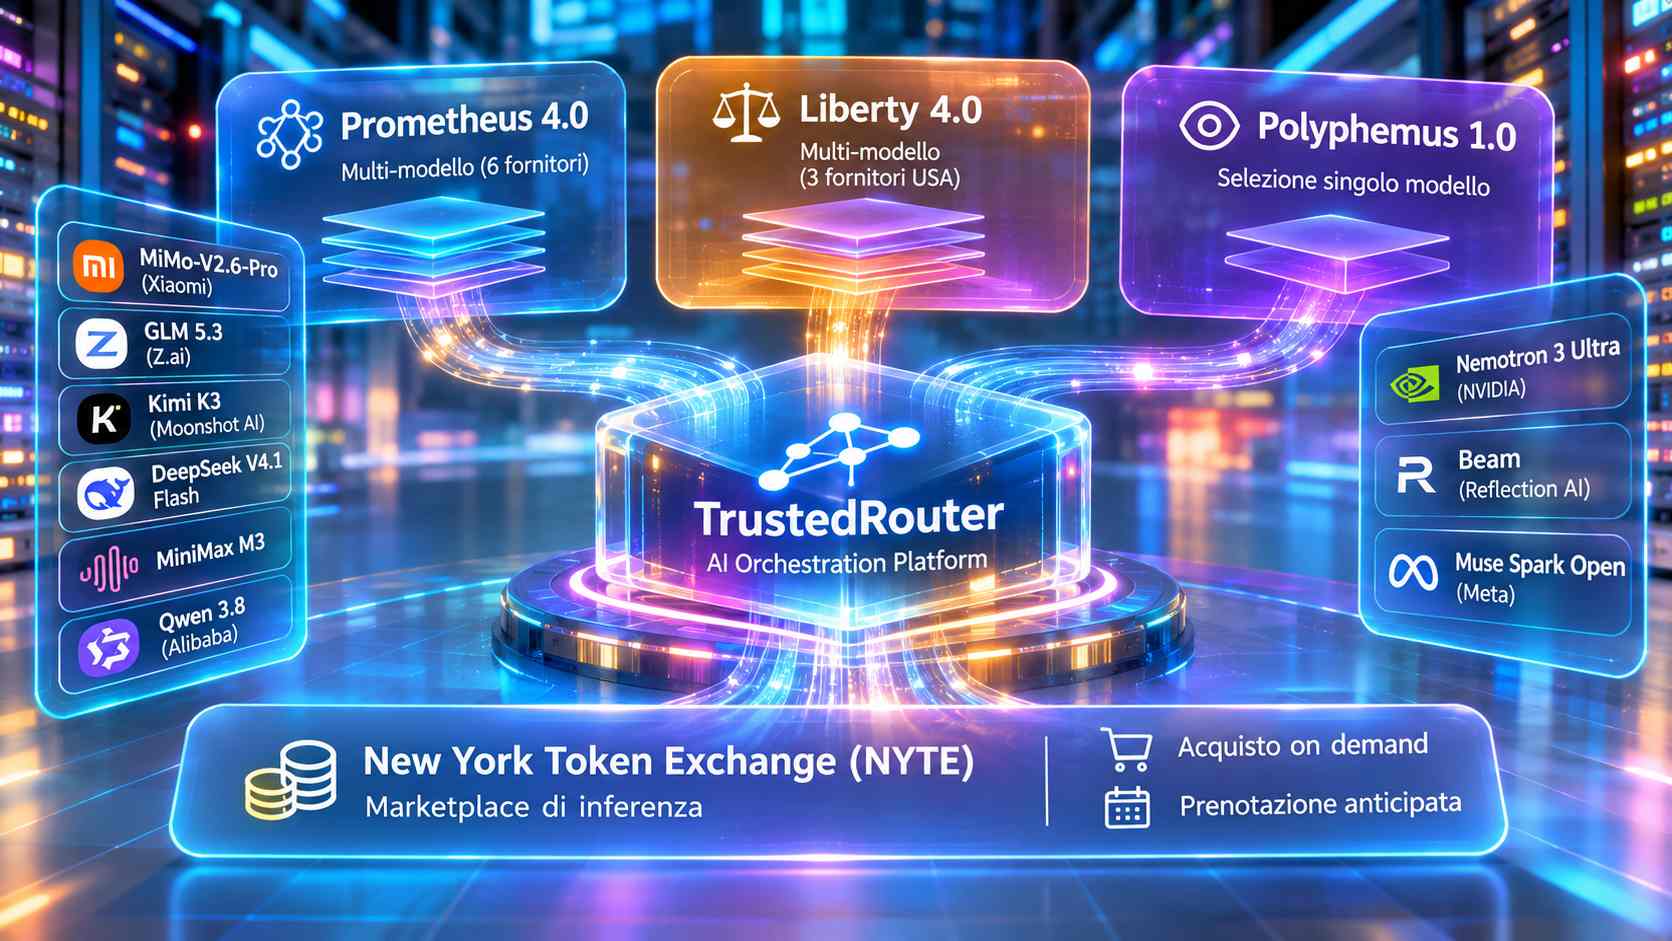
TrustedRouter, piattaforma sviluppata da Lore Hex Corp, ha annunciato l’11 novembre 2026 tre nuovi sistemi di orchestrazione dell’intelligenza artificiale, denominati Prometheus 4.0, Liberty 4.0 e Polyphemus 1.0. Le soluzioni adottano differenti strategie di elaborazione delle richieste: Prometheus e Liberty utilizzano più modelli linguistici in parallelo e combinano successivamente i risultati, mentre Polyphemus seleziona un singolo modello prima dell’esecuzione. L’architettura è integrata con New York Token Exchange (NYTE), un marketplace attraverso il quale gli sviluppatori possono acquistare capacità di inferenza su richiesta oppure prenotarla anticipatamente. TrustedRouter svolge la funzione di gateway tra applicazioni, modelli e fornitori infrastrutturali; le API di TrustedRouter e NYTE condividono credenziali, saldo dell’account e regole di instradamento, permettendo di utilizzare gli stessi preset attraverso differenti prefissi di identificazione.
Prometheus 4.0 combina modelli open-weight sviluppati da diversi fornitori. La configurazione comprende MiMo-V2.6-Pro di Xiaomi, GLM 5.3 di Z.ai, Kimi K3 di Moonshot AI, DeepSeek V4.1 Flash, MiniMax M3 e Qwen 3.8 di Alibaba. Per ogni richiesta, i modelli generano risposte indipendenti e parallele; una successiva chiamata di valutazione confronta i risultati e un modulo di sintesi produce la risposta definitiva. L’intera procedura Prometheus richiede otto chiamate ai modelli e dispone di una finestra di contesto dichiarata di un milione di token. L’alias dinamico nyte/prometheus viene aggiornato alla versione corrente, mentre nyte/prometheus-4.0 identifica specificamente questa configurazione. Liberty 4.0 applica un procedimento simile, limitando però i fornitori a tre aziende statunitensi: NVIDIA con Nemotron 3 Ultra, Reflection AI con Beam e Meta con Muse Spark Open. In questo caso il ciclo completo comprende cinque chiamate, con il modello Meta incaricato della sintesi e Beam disponibile come alternativa qualora il primo non sia raggiungibile. Il sistema può proseguire anche quando non tutti i modelli partecipanti restituiscono una risposta.
Polyphemus 1.0 utilizza invece un selettore che analizza la richiesta, individua il modello considerato più appropriato e inoltra il prompt senza ricorrere alla generazione parallela. Il servizio supporta Responses API, una finestra di contesto di 65.536 token e una tariffa per il selettore di 0,05 dollari per milione di token di input stimati, alla quale si aggiunge il costo del modello effettivamente utilizzato. Se il selettore non funziona, la richiesta viene affidata al sistema automatico generale di TrustedRouter senza addebitare la componente di selezione. Gli identificativi di sessione possono essere riutilizzati per favorire il caching dei contenuti, con scadenza dopo un’ora di inattività. Prometheus e Liberty si inseriscono inoltre nell’infrastruttura di confidential computing supportata da GPU NVIDIA, progettata per proteggere le richieste mediante cifratura anche durante l’elaborazione e verificare l’identità del modello effettivamente impiegato. Restano da precisare alcuni dettagli implementativi, tra cui il modello responsabile della sintesi definitiva in Prometheus, i criteri utilizzati da Polyphemus per scegliere i modelli e il comportamento dei limiti di contesto quando più componenti presentano capacità differenti. Le tariffe pubblicate per i componenti delle configurazioni multi-modello non equivalgono necessariamente al costo complessivo di una risposta, che dipende dal numero di chiamate, dai token elaborati e dalle operazioni di valutazione e sintesi.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)