
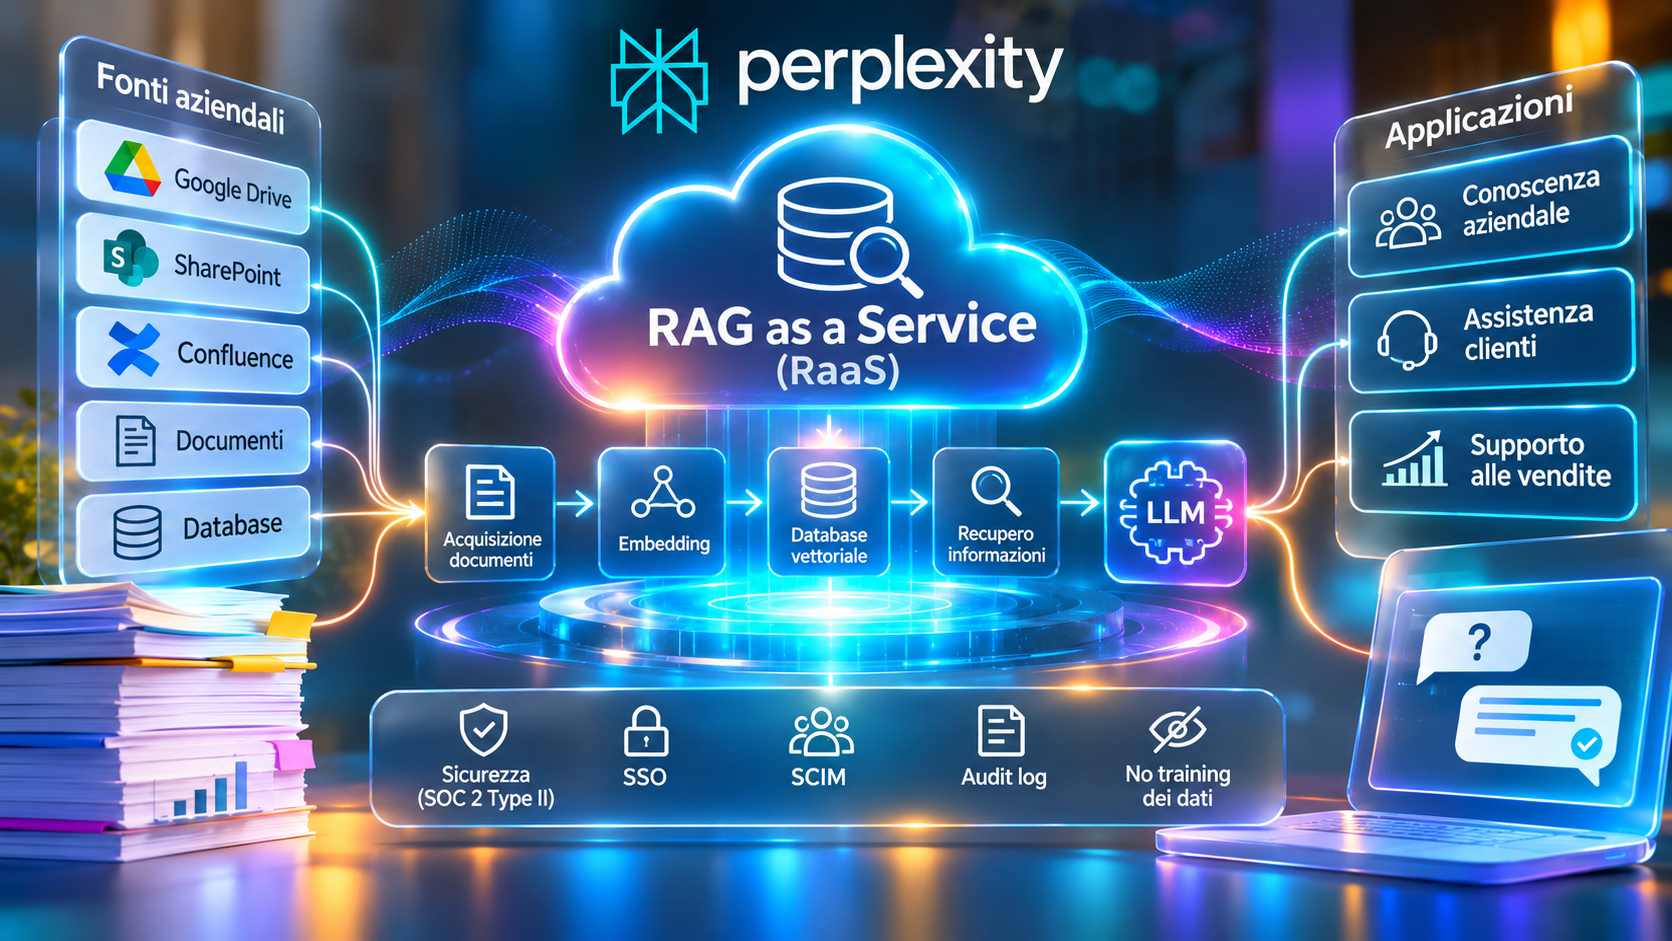
Perplexity ha pubblicato una guida tecnica dedicata al RAG as a Service (RaaS), un modello di implementazione delle architetture di Retrieval-Augmented Generation che prevede l’affidamento a fornitori esterni di parte o della totalità dell’infrastruttura necessaria per il recupero delle informazioni. La metodologia RAG consente di integrare nei processi di generazione dei modelli linguistici informazioni che non fanno parte dei rispettivi dati di addestramento, attraverso l’interrogazione di archivi documentali, database e altre risorse informative. Nell’implementazione gestita, il fornitore può assumere la responsabilità dell’acquisizione dei documenti, della loro elaborazione, della generazione degli embedding, della gestione dei database vettoriali e dei sistemi di ricerca, occupandosi anche della sincronizzazione delle informazioni, della sicurezza e dell’ottimizzazione dell’infrastruttura. Il servizio può comprendere il modello linguistico e l’interfaccia applicativa oppure limitarsi alla componente di recupero delle informazioni, integrandosi con sistemi di intelligenza artificiale già operativi presso il cliente.
Le configurazioni descritte da Perplexity comprendono tre differenti modalità di implementazione. Un sistema RAG locale concentra le operazioni di acquisizione, archiviazione e ricerca sui server dell’organizzazione, eventualmente utilizzando anche modelli linguistici e di embedding eseguiti sulla medesima infrastruttura. Una configurazione cloud sviluppata internamente utilizza invece servizi e modelli accessibili tramite API, mantenendo in capo all’impresa la gestione delle connessioni e dell’orchestrazione. Nell’architettura RaaS, queste responsabilità vengono trasferite, in misura variabile, al fornitore. Nel caso di un assistente aziendale per la consultazione della documentazione interna, il servizio acquisisce i contenuti attraverso apposite interfacce, normalizza il materiale testuale e converte le porzioni dei documenti in rappresentazioni vettoriali indicizzabili. Quando un dipendente formula una domanda, l’orchestratore trasmette la richiesta al sistema di retrieval, che individua i contenuti pertinenti e li restituisce all’applicazione. Il contesto informativo così ottenuto viene incorporato nell’input del modello linguistico prima della generazione della risposta.
Le applicazioni comprendono la realizzazione di assistenti per la gestione della conoscenza aziendale, integrati con piattaforme documentali quali Google Drive, SharePoint e Confluence, nonché sistemi di supporto alle attività commerciali e all’assistenza clienti. Un assistente destinato alla rete di vendita può consultare registrazioni delle conversazioni, richieste di supporto e informazioni sui concorrenti, mentre un’applicazione collegata ai database della clientela può fornire assistenza nella gestione degli abbonamenti, dei resi e dei dati personali. Le architetture più articolate possono integrare tecniche di ricerca ibrida, che combinano la corrispondenza lessicale con quella semantica, procedure di reranking per riordinare i risultati recuperati e strumenti per l’elaborazione di contenuti multimodali. La scelta tra sviluppo interno e infrastruttura gestita dipende dai volumi di utilizzo, dalla complessità delle operazioni e dai costi associati alla manutenzione dei componenti software e hardware.
Perplexity identifica differenti tipologie di fornitori, comprendenti piattaforme AI con funzionalità RAG integrate e servizi infrastrutturali specializzati, citando, oltre alla propria soluzione, AWS, OpenAI, Microsoft Azure, Pinecone, LlamaIndex e Vectara. Perplexity Enterprise, utilizzata secondo l’azienda da oltre 50.000 organizzazioni, comprende strumenti agentici, basi di conoscenza aziendali e di progetto, accesso a diversi modelli generativi, un modello di embedding proprietario e funzionalità di ricerca sul web. La piattaforma Computer utilizza 20 modelli avanzati per l’esecuzione delle attività. Le misure di protezione includono la certificazione SOC 2 Type II, la configurazione dei periodi di conservazione dei file, strumenti di autenticazione SSO, provisioning SCIM e registri di controllo delle attività degli utenti. Perplexity dichiara inoltre di non utilizzare i dati dei clienti Enterprise per l’addestramento dei propri modelli linguistici. Le organizzazioni possono adottare configurazioni miste, mantenendo internamente le infrastrutture dedicate alle applicazioni più circoscritte e ricorrendo a servizi gestiti per i progetti che richiedono componenti di retrieval maggiormente specializzati.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)