
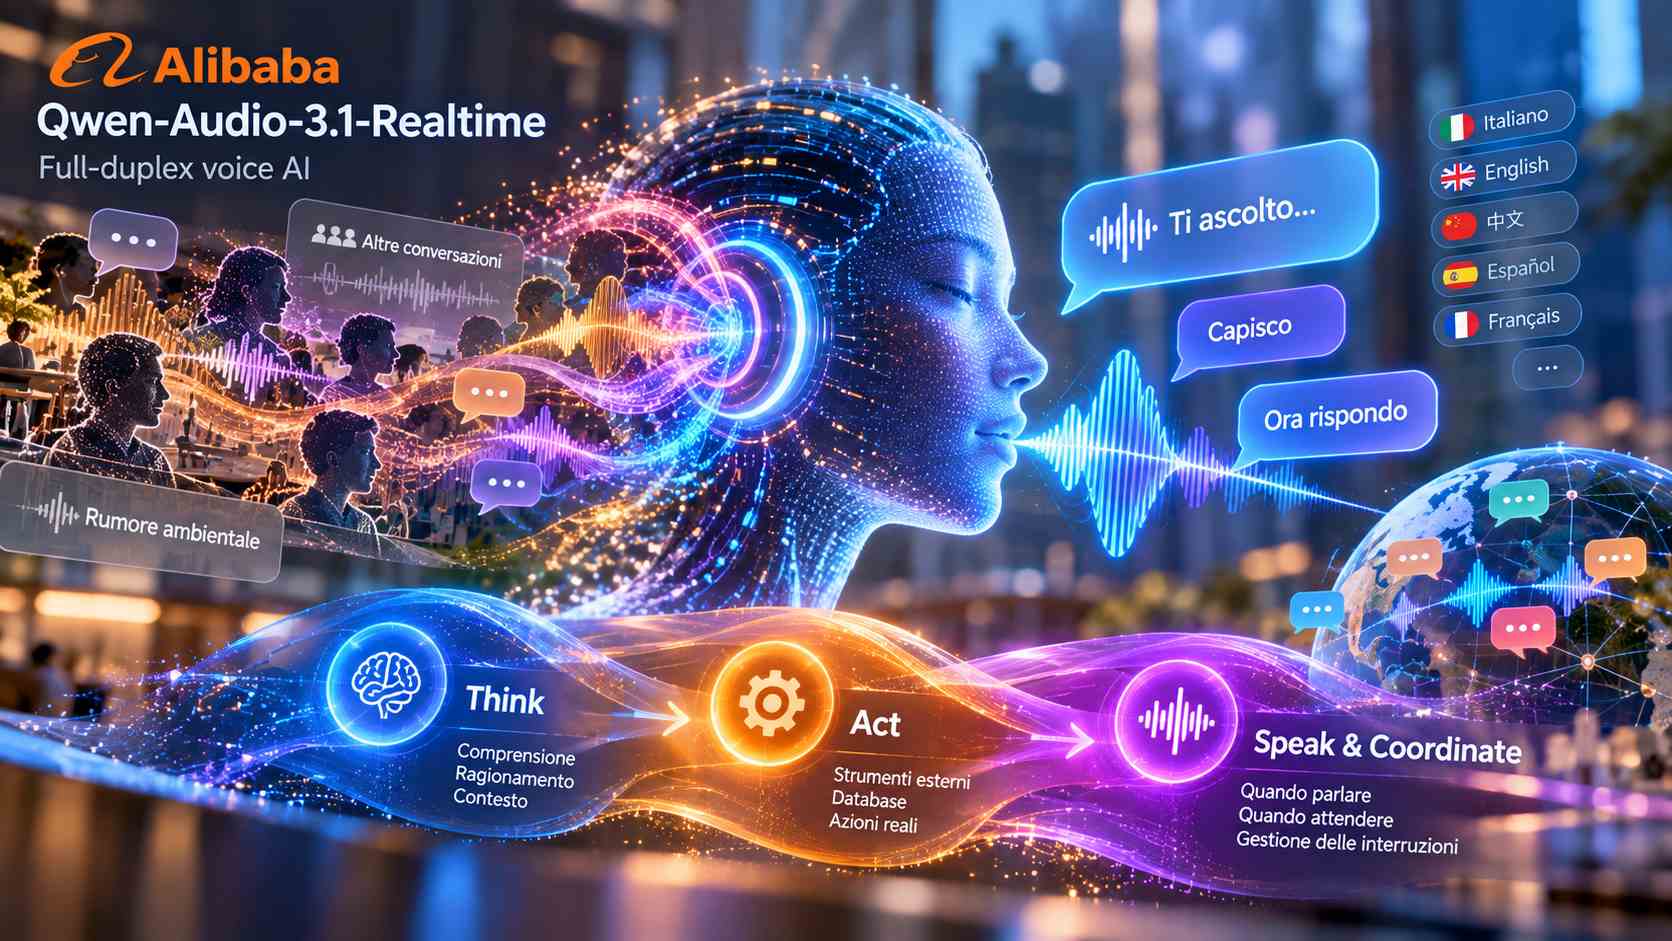
Alibaba ha presentato Qwen-Audio-3.1-Realtime, un modello vocale full-duplex progettato non soltanto per comprendere e generare parlato, ma anche per valutare il momento più adatto in cui pensare, agire e intervenire nella conversazione. La modalità full-duplex consente al sistema di ascoltare l’utente mentre continua a monitorare l’ambiente sonoro e, quando necessario, di proseguire o interrompere la propria risposta in modo dinamico. Il modello è stato migliorato nella comprensione vocale, nel ragionamento, nella gestione di istruzioni distribuite su più turni, nelle conversazioni empatiche e nel role playing. Una delle novità principali riguarda proprio la gestione del flusso dialogico: Qwen-Audio-3.1-Realtime può distinguere il rumore ambientale e le conversazioni tra altre persone, attendere che l’utente abbia concluso la propria frase, riconoscere un’interruzione e riprendere successivamente il discorso. È inoltre in grado di seguire conversazioni con più partecipanti e supporta l’interazione multilingue.
La struttura di addestramento è articolata in tre fasi denominate Think, Act e Speak & Coordinate. Nella fase Think vengono trasferite al modello vocale le capacità del modello linguistico, integrandole con una comprensione più profonda del parlato, dell’intento conversazionale, delle componenti emotive e del contesto acustico. Nella fase Act il sistema viene invece addestrato in ambienti che riproducono scenari operativi reali, utilizzando database, regole aziendali e strumenti esterni per eseguire attività e incorporarne poi il risultato nella conversazione; questo consente, per esempio, di interrogare sistemi informativi durante un’interazione di assistenza e rispondere utilizzando i dati recuperati. La fase Speak & Coordinate riguarda infine il controllo temporale della conversazione e addestra il modello a decidere non solo cosa dire, ma quando iniziare a parlare, quando attendere e come riprendere dopo un’interruzione.
Nei test interni, il tasso di successo nei compiti vocali è passato dal 78,4% di Qwen-Audio-3.0-Realtime all’82,0%. Sul Full-Duplex-Bench, la percentuale di risposte errate a conversazioni di sottofondo tra altre persone è scesa dal 73,0% al 13,0%, mentre il punteggio Audio MultiChallenge è aumentato da 47,12 a 52,21. Nella valutazione BBA su 14 lingue la media è salita dall’81,7% all’88,1% e nel benchmark di riconoscimento vocale FLEURS il word error rate è sceso da 9,01 a 3,98. Alibaba segnala comunque che alcune valutazioni non sono direttamente confrontabili: i risultati τ-Voice, per esempio, utilizzano una modalità separata voce-testo anziché una conversazione vocale full-duplex, mentre in altri test rimangono differenze nella velocità con cui il modello interrompe la propria risposta quando l’utente ricomincia a parlare e nella capacità di riprenderla successivamente.
Qwen-Audio-3.1-Realtime è già disponibile tramite Qwen Cloud sotto forma di API gestita e utilizza WebSocket per l’ingresso e l’uscita di audio e testo. Supporta inoltre function calling, ricerca sul web, output strutturati e context caching. Al momento non sono stati pubblicati pesi open source. Il rilascio fa parte di un ampliamento complessivo della famiglia Qwen-Audio-3.1, che comprende anche modelli dedicati al riconoscimento e alla sintesi vocale, mentre Alibaba ha dichiarato di avere ridotto in modo significativo i prezzi dei servizi di real-time voice, text-to-speech e speech recognition rispetto alla generazione precedente.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)