
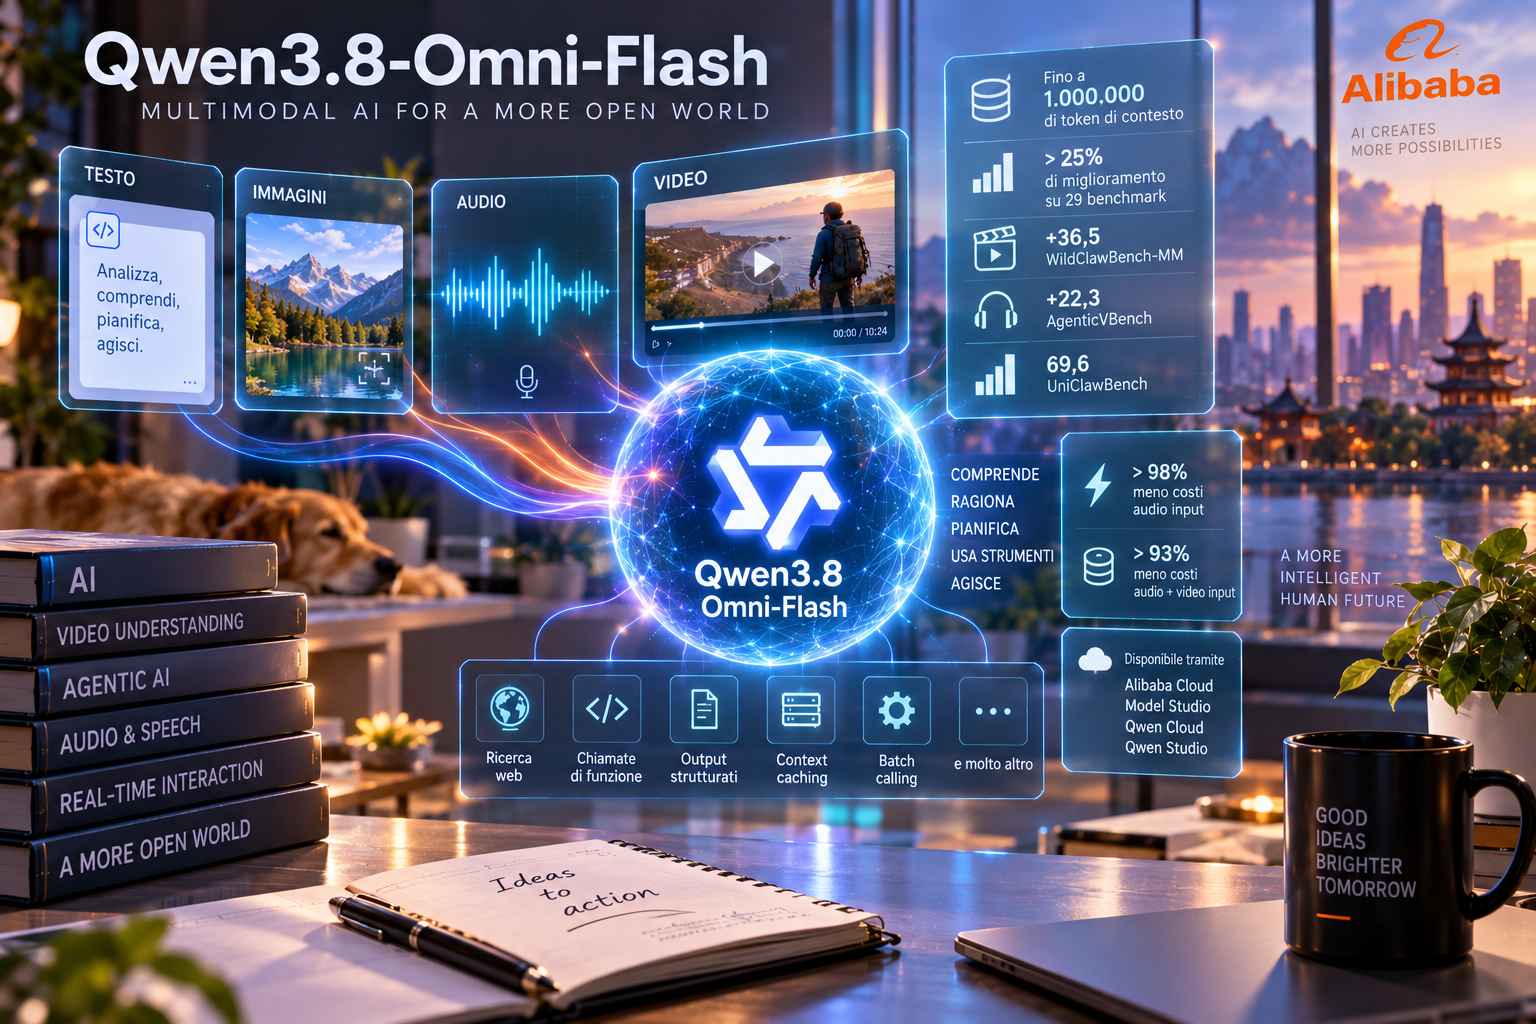
Alibaba ha presentato Qwen3.8-Omni-Flash, un modello omnmodale progettato per elaborare testo, immagini, audio e video e collegare la comprensione dei contenuti all’esecuzione di attività attraverso strumenti esterni. Il modello supporta una finestra di contesto fino a un milione di token e restituisce output testuali, ma può utilizzare chiamate di funzione, ricerca web, output strutturati, context caching e batch calling per interagire con sistemi esterni e portare avanti flussi di lavoro più lunghi. Rispetto a Qwen3.5-Omni-Plus, Alibaba dichiara un miglioramento medio superiore al 25% su 29 valutazioni, con incrementi particolarmente marcati nei benchmark dedicati ad agenti audio-video e attività prolungate: WildClawBench-MM registra un aumento di 36,5 punti, AgenticVBench di 22,3 punti, mentre UniClawBench raggiunge 69,6 punti.
Una delle differenze principali riguarda il trattamento di contenuti audio e video di lunga durata. Invece di analizzare necessariamente l’intero flusso dall’inizio alla fine, Qwen3.8-Omni-Flash parte dalla richiesta dell’utente e decide quali segmenti osservare o ascoltare, tornando più volte sul materiale per raccogliere le evidenze necessarie. Nei test interni di Alibaba su OmniVideoBench, questo approccio ha portato l’accuratezza da 63,4 a 67,8 punti riducendo al tempo stesso il consumo di token da 145.736 a 79.117, con un calo di circa il 45,7%. Il sistema può inoltre produrre descrizioni video più strutturate, adattando l’analisi al tema richiesto, all’intervallo temporale, al livello di dettaglio e al formato di output, includendo informazioni su azioni dei soggetti, inquadrature, illuminazione e componenti sonore.
Le capacità agentiche vengono estese anche alle attività operative. Su registrazioni di riunioni prolungate, il modello può combinare audio e immagini per distinguere i diversi partecipanti, ricostruire gli interventi, generare verbali, individuare attività successive e segnalare rischi di progetto; collegandolo a strumenti esterni, queste informazioni possono essere trasformate direttamente in azioni come inviare email, creare task o avviare attività di programmazione. Il modello può inoltre partire da un video per effettuare ulteriori ricerche sul web: dopo aver individuato, per esempio, una sequenza che mostra una procedura in Photoshop, può cercare documenti, immagini e altri video relativi allo stesso problema, confrontare soluzioni alternative e produrre un report di ricerca costruito attorno al materiale audiovisivo iniziale.
Alibaba indica applicazioni anche nella produzione e trasformazione dei contenuti. Qwen3.8-Omni-Flash può analizzare ritmo, atmosfera, voce e variazioni strumentali di un brano per pianificare personaggi, scene e impostazione delle riprese di un videoclip, sincronizzando inoltre testi e sottotitoli attraverso informazioni temporali. Nei flussi di traduzione video può combinare riconoscimento del parlante, traduzione, clonazione vocale, doppiaggio, modifica dell’audio e controllo finale della qualità, mentre per contenuti particolarmente lunghi può individuare le scene principali di un film di due o tre ore, preparare una sceneggiatura di commento, generare voce e musica e portare il processo fino alle fasi di montaggio e rendering.
Alibaba ha sperimentato lo stesso modello anche come agente per migliorare altri sistemi AI. A Qwen3.8-Omni-Flash è stato assegnato il compito di aumentare entro 12 ore le prestazioni di riconoscimento del dialetto del Sichuan di Qwen2.5-Omni-3B: l’agente ha definito autonomamente criteri di valutazione e dati, eseguito quattro cicli sperimentali e prodotto 3.413 nuovi esempi di addestramento. Sullo stesso set di valutazione il Character Error Rate è così sceso dal 25,79% al 15,30%, pari a una riduzione relativa di circa il 40,7%. Il dato è particolarmente interessante perché il modello non viene utilizzato soltanto come sistema di inferenza, ma anche come componente di un processo iterativo di miglioramento di un altro modello attraverso selezione dei dati, sperimentazione e verifica dei risultati.
In parallelo Alibaba ha pubblicato Qwen-MM-Plugins, un insieme di strumenti open source pensati per trasformare il contenuto di video lunghi in conoscenza riutilizzabile dagli agenti. Video2Note estrae i passaggi principali di un filmato e li organizza in note PDF contenenti immagini e testo, mentre Omni Skill Creator analizza video dimostrativi realizzati da esperti per ricavare procedure operative standard e modalità d’uso degli strumenti, convertendo quindi conoscenze presenti nei filmati in competenze che possono essere riutilizzate all’interno di flussi agentici. È stata inoltre presentata Qwen3.8-Omni-Flash-Realtime, una versione capace di ricevere flussi audio e video in tempo reale, interpretare l’ambiente circostante e chiamare strumenti mentre l’interazione è in corso. La combinazione tra informazioni visive e audio spaziale consente anche di stimare direzione e distanza delle sorgenti sonore e di collegare questi dati alla presenza di ostacoli e percorsi disponibili per attività di navigazione o movimento.
Alibaba dichiara infine una forte riduzione dei costi di utilizzo rispetto alla generazione precedente: oltre il 98% in meno per ora di input esclusivamente audio e oltre il 93% in meno per input combinati audio-video. Qwen3.8-Omni-Flash viene distribuito al momento esclusivamente tramite API ospitate su Alibaba Cloud Model Studio, Qwen Cloud e Qwen Studio; al lancio i pesi non sono stati pubblicati e non è quindi prevista l’installazione autonoma del modello su infrastrutture proprie.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)