
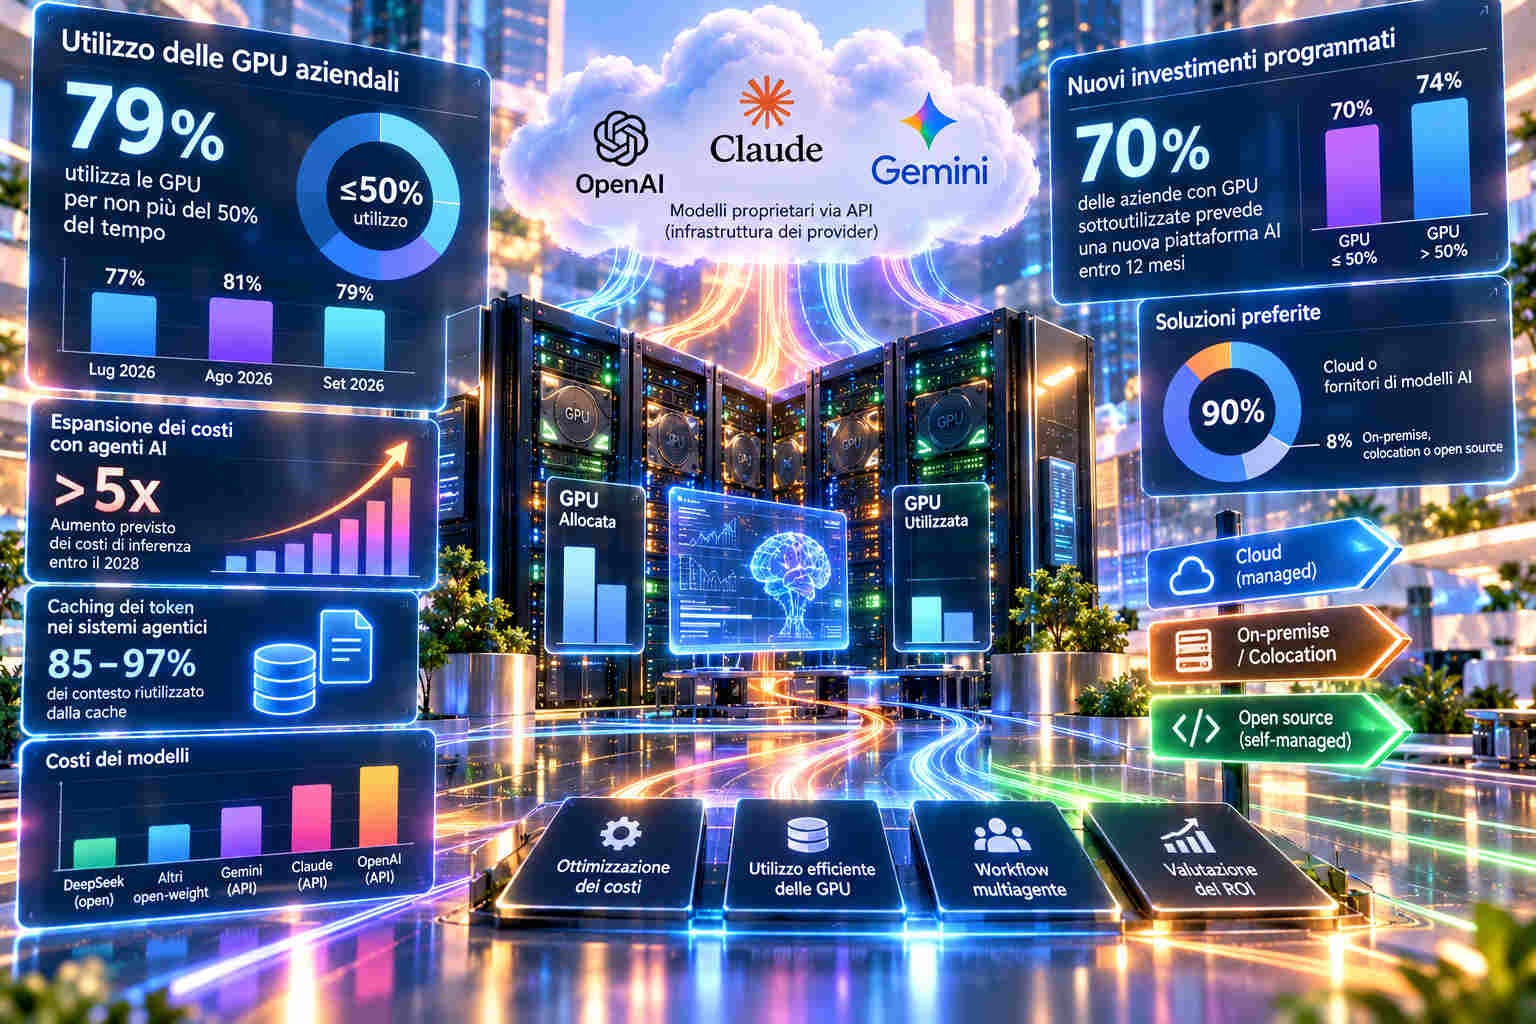
Le infrastrutture di calcolo dedicate all’intelligenza artificiale mostrano una significativa discrepanza tra capacità disponibile, utilizzo effettivo delle GPU e nuovi investimenti programmati dalle imprese. Un’indagine condotta attraverso tre rilevazioni mensili VB Pulse, tra luglio e settembre 2026, ha coinvolto complessivamente 385 rispondenti qualificati appartenenti a organizzazioni con almeno 100 dipendenti. Tra le 218 aziende che utilizzano sistemi AI in produzione e hanno fornito dati sull’impiego delle GPU, 172, pari al 79%, hanno dichiarato un utilizzo dei processori grafici non superiore al 50% del tempo. Il fenomeno è rimasto sostanzialmente stabile nei tre mesi considerati, con percentuali comprese tra il 77% e l’81%. Nonostante questa disponibilità di capacità inutilizzata, 120 delle 172 aziende interessate, equivalenti al 70%, prevedono di adottare entro i successivi dodici mesi una nuova piattaforma di calcolo AI, aggiuntiva o sostitutiva di quella già utilizzata. La propensione all’investimento risulta molto simile anche tra le imprese che dichiarano un utilizzo delle GPU superiore al 50%, delle quali il 74%, corrispondente a 34 organizzazioni su 46, sta valutando nuove infrastrutture. La differenza tra i due gruppi non è statisticamente significativa e suggerisce che la disponibilità di risorse di calcolo inutilizzate non costituisca, da sola, un fattore determinante nelle decisioni aziendali relative all’acquisizione di ulteriori piattaforme.
Una delle principali caratteristiche di questa situazione riguarda la separazione tra capacità GPU disponibile e utilizzo dei modelli proprietari più avanzati. Le aziende possono disporre di processori grafici acquistati, noleggiati o riservati attraverso infrastrutture cloud, ma continuare a utilizzare modelli di OpenAI, Anthropic e Google attraverso API commerciali, abbonamenti o servizi gestiti dai fornitori. I modelli proprietari non possono essere installati direttamente sulle GPU controllate dal cliente e richiedono quindi l’utilizzo dell’infrastruttura del produttore o di un operatore autorizzato, con fatturazione basata sui token elaborati oppure sulla capacità riservata. Ne deriva la possibilità di sostenere contemporaneamente costi per risorse GPU sottoutilizzate e costi aggiuntivi per l’inferenza attraverso servizi esterni. La diffusione di questa configurazione è riconducibile anche alla necessità, percepita durante le precedenti fasi di scarsità dei processori grafici, di assicurarsi preventivamente capacità computazionale, mentre sviluppatori e personale aziendale privilegiavano i modelli più performanti per accelerare l’implementazione delle applicazioni. Il passaggio a modelli open-weight eseguibili sulle infrastrutture già disponibili richiede tuttavia attività di integrazione, valutazione e gestione specifiche, oltre alla verifica dei requisiti di sicurezza e conformità. Nel confronto effettuato nell’ottobre 2026 su cinque modelli aperti, DeepSeek è risultato quello con i costi inferiori, ma l’adozione di modelli sviluppati in Cina continua a suscitare riserve presso una parte delle organizzazioni.
Le intenzioni di investimento confermano la prevalenza delle soluzioni gestite rispetto all’espansione delle infrastrutture autonome. Tra le 120 organizzazioni caratterizzate da GPU sottoutilizzate che prevedono l’adozione di una nuova piattaforma, 108, pari al 90%, hanno incluso tra le alternative considerate un fornitore cloud o un produttore di modelli AI, mentre soltanto nove, equivalenti all’8%, hanno indicato cluster GPU on-premise, infrastrutture in colocation oppure stack open source gestiti internamente. Le organizzazioni che utilizzano direttamente cluster locali, risorse in colocation o infrastrutture open source autogestite mostrano inoltre livelli di utilizzo mediamente superiori: tra queste, 18 aziende su 32, pari al 56%, hanno dichiarato GPU operative per non più della metà del tempo, contro 154 aziende su 186, pari all’83%, appartenenti alle altre configurazioni infrastrutturali. Il dato evidenzia una correlazione tra gestione diretta dell’infrastruttura e maggiore impiego della capacità disponibile, senza tuttavia consentire di stabilire un rapporto causale. Un ulteriore elemento riguarda la valutazione economica degli investimenti: nella rilevazione di settembre, 58 delle 64 aziende intenzionate ad adottare una nuova piattaforma, pari al 91%, non disponevano di una stima del ritorno sull’investimento formalmente esaminata dalla funzione finanziaria. Una parte della capacità inutilizzata potrebbe comunque essere mantenuta intenzionalmente per affrontare i picchi di domanda, mentre alcuni progetti di investimento potrebbero riguardare la sostituzione di infrastrutture esistenti anziché un effettivo incremento della capacità complessiva.
L’evoluzione verso sistemi agentici introduce ulteriori elementi di costo, perché l’esecuzione di un’attività può richiedere numerose chiamate ai modelli, ripetute elaborazioni del contesto e il coordinamento di più agenti. Secondo le previsioni Gartner, i costi di inferenza per workflow agentici potrebbero aumentare di oltre cinque volte entro il 2028. La riduzione progressiva dei prezzi unitari dei token non garantisce quindi una diminuzione della spesa complessiva, soprattutto quando l’aumento delle operazioni e l’impiego di modelli più costosi compensano i risparmi ottenuti sul singolo token. Nei sistemi di coding agentico, una parte rilevante dei token elaborati riguarda istruzioni, documentazione e cronologia delle operazioni già presenti nel contesto. Le analisi tecniche di NVIDIA indicano che, dopo la prima chiamata di una sessione Claude Code, le successive possono riutilizzare attraverso la cache dall’85% al 97% del contesto. Anthropic applica ai token recuperati dalla cache prezzi compresi tra un quarantesimo e un decimo di quelli ordinariamente previsti per i token di input, a seconda del modello. Anche il coordinamento multiagente richiede una valutazione economica specifica: nei test condotti da Vals AI, configurazioni con un agente principale e fino a cinque sottoagenti hanno comportato costi da 1,8 a 5,1 volte superiori rispetto all’impiego di un singolo agente, mentre soltanto una delle quattro configurazioni esaminate ha ottenuto un miglioramento statisticamente significativo nei benchmark.
L’ottimizzazione economica delle infrastrutture AI richiede pertanto di valutare il costo per attività effettivamente completata, considerando congiuntamente la capacità GPU impegnata e la spesa per le API dei modelli. La scelta del modello e del livello di elaborazione non può essere effettuata esclusivamente sulla base del prezzo per token, poiché un modello apparentemente più economico potrebbe richiedere un numero superiore di passaggi e token per completare la stessa operazione. La riduzione dei costi può inoltre derivare dalla selezione del contesto strettamente necessario, dal riutilizzo delle informazioni attraverso meccanismi di caching, dalla limitazione dell’esecuzione parallela ai compiti realmente divisibili e dall’assegnazione delle attività ripetitive ad alto volume, come classificazione, estrazione delle informazioni e sintesi documentale, a modelli aperti eseguiti sulla capacità GPU già disponibile. Le risorse residue possono essere impiegate per inferenza batch, valutazioni dei modelli e fine-tuning, distribuendo nel tempo i carichi di lavoro non urgenti. I risultati devono comunque essere interpretati tenendo conto della metodologia adottata: le tre rilevazioni hanno coinvolto campioni differenti e autoselezionati, non rappresentativi statisticamente dell’intero universo delle imprese, ed escludono dalle statistiche sull’utilizzo GPU le organizzazioni che non misurano tale parametro o non gestiscono processori grafici. I dati descrivono quindi un fenomeno osservato nel campione, senza permettere di quantificare in modo generalizzabile la capacità GPU inutilizzata nel mercato aziendale complessivo.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)