
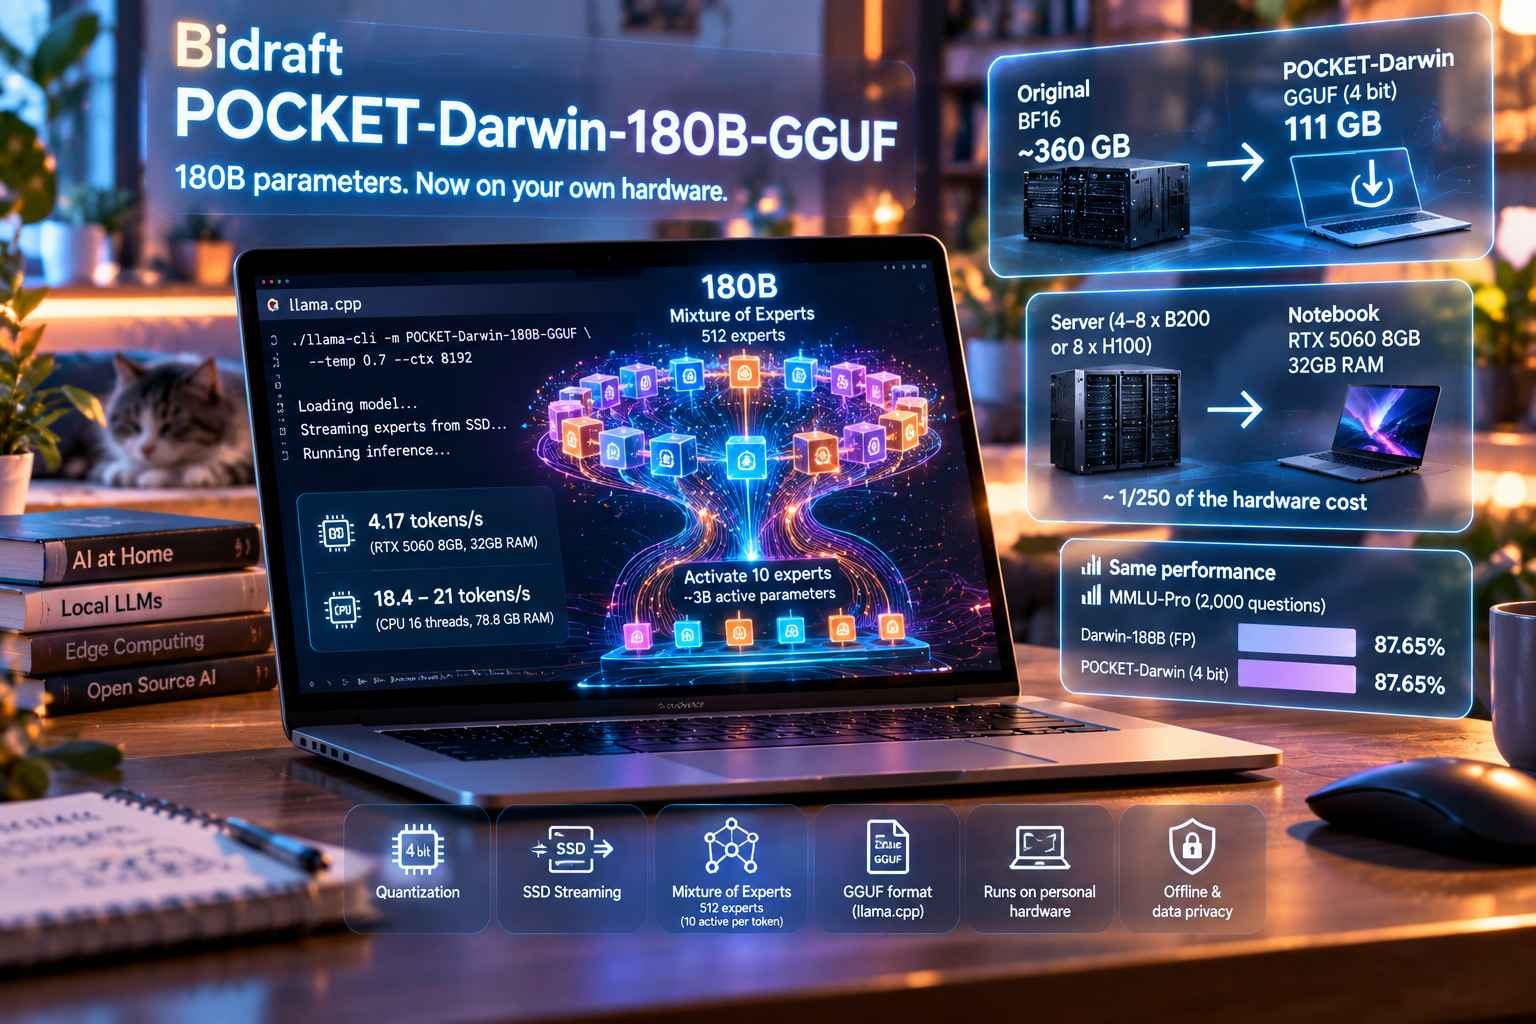
Bidraft ha pubblicato su Hugging Face e ModelScope una versione alleggerita di Darwin-180B-RSI, modello da 180 miliardi di parametri sviluppato a partire da Qwen3.8-Flash-Next, con l’obiettivo di rendere utilizzabile un sistema di questa scala anche su hardware personale. Il modello originale, in precisione BF16, occupa circa 360 GB soltanto per i file dei pesi e richiede normalmente server equipaggiati con quattro-otto GPU NVIDIA B200 oppure otto H100 da 80 GB. La nuova variante, denominata POCKET-Darwin-180B-GGUF, riduce invece la dimensione complessiva a 111 GB e può essere eseguita anche su un notebook da gaming dotato di 8 GB di memoria grafica e 32 GB di RAM, una configurazione che Bidraft colloca nella fascia di prezzo di circa 2 milioni di won e che, considerando soltanto il costo dell’hardware, rappresenterebbe circa un duecentocinquantesimo del prezzo necessario per un server tradizionalmente utilizzato con il modello completo. La riduzione dei requisiti non deriva però dalla rimozione della struttura da 180 miliardi di parametri: POCKET-Darwin conserva integralmente l’architettura del modello originale e interviene invece sulla modalità con cui i pesi vengono memorizzati e caricati durante l’inferenza, cercando quindi di abbassare drasticamente il costo di esecuzione senza trasformare Darwin-180B in un modello più piccolo nel senso tradizionale del termine.
Il principale elemento che rende possibile questa strategia è l’architettura Mixture of Experts. Darwin-180B utilizza 512 reti neurali specializzate, o expert, ma per ogni token ne attiva selettivamente soltanto 10; di conseguenza, pur mantenendo una capacità complessiva di 180 miliardi di parametri, durante una singola fase di calcolo vengono effettivamente utilizzati circa 3 miliardi di parametri attivi. POCKET-Darwin-180B-GGUF conserva lo stesso meccanismo di attivazione selettiva e vi aggiunge una quantizzazione dei pesi a 4 bit, che riduce in maniera sostanziale lo spazio necessario per memorizzare il modello. A questo si affianca un sistema di SSD streaming basato su llama.cpp, attraverso il quale i pesi degli expert necessari vengono caricati dal dispositivo di archiviazione soltanto quando devono essere utilizzati. Il modello non deve quindi risiedere interamente nella memoria principale o nella VRAM della GPU, perché le parti necessarie all’elaborazione vengono richiamate dinamicamente. Nelle misurazioni pubblicate da Bidraft, utilizzando esclusivamente una CPU server con 16 thread e senza GPU, il modello ha raggiunto una velocità compresa tra 18,4 e 21 token al secondo con un utilizzo di memoria pari a 78,8 GB. Su un mini PC dotato di 128 GB di RAM è invece possibile caricare l’intero modello in memoria ed eseguirlo senza alcuna GPU, mentre su un notebook con RTX 5060 da 8 GB di VRAM e 32 GB di RAM la velocità registrata è stata di 4,17 token al secondo.
La distribuzione avviene nel formato GGUF, comunemente utilizzato per l’esecuzione locale di modelli AI e supportato dall’engine open source llama.cpp. I file GGUF contengono sia i pesi sia le informazioni necessarie all’esecuzione e permettono quindi di utilizzare il modello direttamente su notebook, workstation e server senza dover dipendere da un’infrastruttura cloud. POCKET-Darwin-180B-GGUF viene distribuito in quattro file per un totale di 111 GB e, dopo il download, può essere avviato con una singola riga di comando utilizzando una versione recente di llama.cpp, senza necessità di creare account cloud o collegarsi a server GPU esterni. Bidraft sostiene inoltre che la quantizzazione a 4 bit non abbia prodotto una perdita significativa di qualità rispetto al modello originale: nel confronto condotto sulle stesse 2.000 domande del benchmark MMLU-Pro, la versione non compressa e quella quantizzata hanno entrambe ottenuto un’accuratezza dell’87,65%. Questo risultato è particolarmente importante perché uno dei principali compromessi della quantizzazione consiste normalmente proprio nel possibile deterioramento delle prestazioni, mentre in questo caso l’azienda dichiara di essere riuscita a mantenere invariato il risultato del benchmark pur riducendo drasticamente peso del modello e requisiti hardware. La possibilità di eseguire l’intero sistema offline viene indicata come uno dei principali scenari di utilizzo per aziende e amministrazioni pubbliche che non possono o non vogliono trasferire dati sensibili verso servizi cloud esterni.
Bidraft inserisce POCKET-Darwin all’interno di una strategia più ampia basata sull’idea di aumentare prima le capacità del modello attraverso tecniche di Recursive Self-Improvement e successivamente ridurre il costo della sua esecuzione attraverso la linea POCKET. La conversione dei pesi a 4 bit, la selezione dei moduli di calcolo rilevanti, il mantenimento della struttura Mixture of Experts e il caricamento dinamico degli expert da SSD permettono quindi di spostare un modello che normalmente richiederebbe una configurazione server di fascia molto alta verso sistemi CPU, mini PC e notebook consumer. Tecniche di quantizzazione e riduzione selettiva delle componenti computazionali vengono già adottate da diverse aziende, ma Bidraft sottolinea come siano ancora relativamente rari i casi nei quali un modello da 180 miliardi di parametri mantenga la propria architettura completa e venga contemporaneamente reso eseguibile su hardware personale grazie alla combinazione di MoE, quantizzazione e streaming dei pesi. Il modello viene quindi proposto non come una versione ridotta di Darwin nel numero complessivo dei parametri, ma come una variante capace di mantenere la stessa struttura logica limitando la quantità di calcolo e memoria richiesta in ogni singolo passaggio di inferenza, con l’obiettivo di portare modelli di fascia server in ambienti locali molto più economici e accessibili.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)