
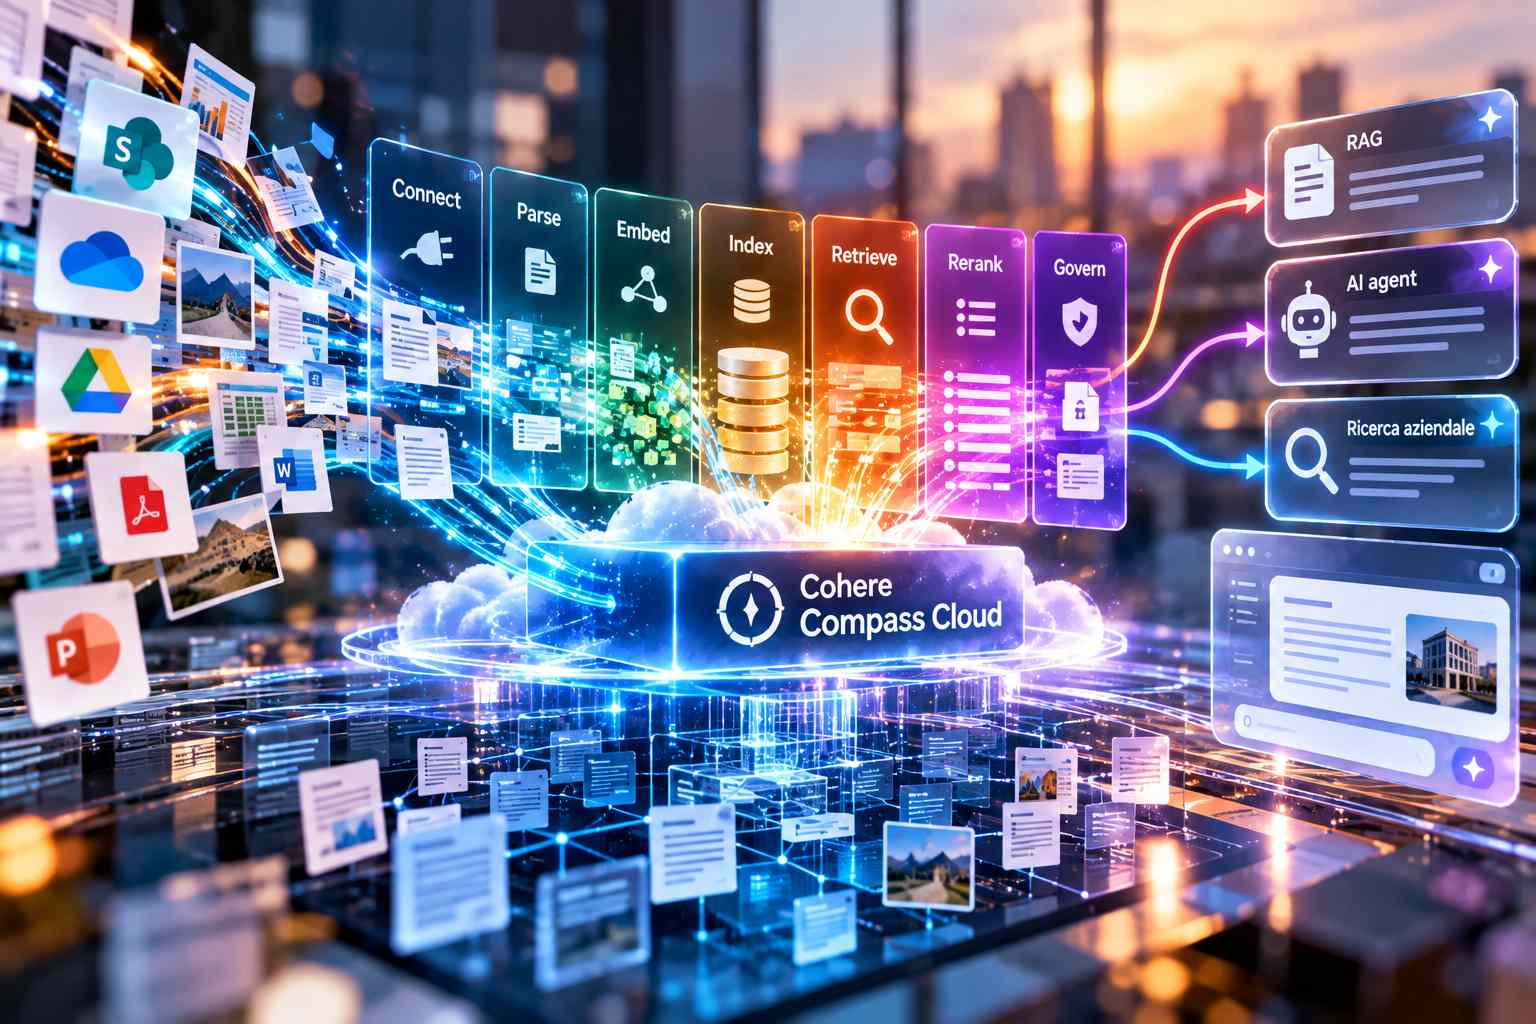
Cohere ha aperto il 25 settembre 2026 la private beta di Compass Cloud, versione completamente gestita della propria piattaforma di retrieval destinata agli sviluppatori che realizzano applicazioni AI basate su dati aziendali. Compass viene utilizzato per individuare le informazioni più rilevanti all’interno del patrimonio documentale di un’organizzazione e metterle a disposizione di sistemi RAG, motori di ricerca interni e workflow agentici; con Compass Cloud, però, Cohere assume direttamente la gestione dell’intera pipeline di retrieval e dell’inferenza dei modelli, evitando ai team di dover assemblare e mantenere autonomamente i diversi componenti dell’infrastruttura. Gli sviluppatori possono configurare il servizio attraverso API, un server MCP oppure un SDK Python, mantenendo il controllo su come i contenuti vengono rappresentati, recuperati, ordinati e utilizzati nell’esperienza finale. Fino a questo momento Compass era stato impiegato soprattutto come motore di retrieval di North, l’ambiente enterprise di Cohere per gli agenti AI, comprese le relative librerie documentali e l’ecosistema MCP, ed era stato distribuito anche in ambienti self-hosted ad alta sicurezza per clienti appartenenti a settori regolamentati che non possono trasferire i propri workload verso servizi SaaS. Questa modalità rimane disponibile per i progetti soggetti a vincoli particolarmente stringenti di privacy o controllo dei dati, mentre Compass Cloud punta a soddisfare le aziende che vogliono utilizzare le stesse capacità di ricerca senza sostenere i costi operativi e la complessità di un’installazione autonoma. La beta coinvolge inizialmente un numero limitato di team enterprise e l’accesso viene richiesto direttamente attraverso Compass.
La nuova offerta viene costruita attorno a tre cambiamenti che, secondo Cohere, stanno modificando profondamente i requisiti della ricerca aziendale nell’epoca dei sistemi generativi e degli agenti. Il primo riguarda l’economia dei token: ogni risultato irrilevante fornito a un modello occupa spazio all’interno della finestra di contesto e genera costi di inferenza, mentre un retrieval più preciso permette di inviare input più piccoli e pertinenti, riducendo sia il consumo di token sia il tempo necessario per completare un’attività. Il secondo riguarda il funzionamento degli agenti, che durante una singola operazione possono effettuare decine di query, riformulare ripetutamente le richieste e attraversare più fonti di dati; in questi cicli multi-hop la latenza può accumularsi, la pertinenza dei risultati può progressivamente deteriorarsi e i controlli di autorizzazione devono essere applicati a ogni passaggio, rendendo necessario un sistema capace di mantenere qualità e sicurezza non soltanto su una singola ricerca ma lungo sequenze di interrogazioni generate automaticamente. Il terzo elemento è la frammentazione dello stack di retrieval utilizzato normalmente negli ambienti di produzione, dove ingestion, indicizzazione, reranking, controllo degli accessi e orchestrazione vengono spesso affidati a prodotti o middleware differenti, costringendo i team a investire una parte significativa del lavoro nell’integrazione fra componenti invece che nella qualità effettiva della ricerca. Compass è progettato per riunire queste funzioni in una piattaforma unica e fornire contesto pertinente e governato sia alle applicazioni di ricerca tradizionali sia ai workload generativi e agentici.
L’architettura di Compass organizza l’elaborazione e il retrieval dei documenti in sette fasi integrate. La prima, Connect, mette a disposizione connettori già pronti per ambienti di condivisione e cloud storage come SharePoint, OneDrive e Google Drive e supporta dati che Cohere descrive come multilingue, multimodali e indipendenti dal formato dei file. Parse trasforma quindi i documenti aziendali in contenuti adatti all’elaborazione AI scegliendo una strategia di parsing per ciascun documento e utilizzando la visione artificiale soltanto nei casi in cui apporta un beneficio effettivo, così da evitare chiamate inutili ai modelli. Embed produce contemporaneamente rappresentazioni dense e sparse dei contenuti, permettendo al sistema di riconoscere sia la similarità semantica sia terminologia specifica del dominio attraverso testo e materiali multimodali. Durante la fase Index, i file originali, il contenuto risultante dal parsing e gli embedding vengono conservati come record separati: questa struttura consente, per esempio, di passare in futuro a un nuovo modello di embedding senza dover nuovamente eseguire il crawling e il caricamento degli stessi documenti, mentre al momento della ricerca tutti questi record vengono utilizzati nello stesso indice insieme ai relativi metadati. Retrieve combina nello stesso processo ricerca semantica, sparse search e keyword search, che possono funzionare separatamente oppure insieme, e applica direttamente le autorizzazioni durante il retrieval anziché delegare questo controllo all’applicazione. Rerank utilizza quindi il modello di reranking di Cohere per selezionare i passaggi realmente più pertinenti a partire da un insieme iniziale più ampio di candidati, riducendo il materiale inutile che viene successivamente fornito al modello generativo. L’ultima fase, Govern, applica controlli multi-tenant, autorizzazioni a livello di singolo documento e politiche di conservazione che possono far scadere automaticamente i contenuti e impedire che documenti eliminati vengano sincronizzati nuovamente.
Cohere ha accompagnato il lancio con i risultati di un proprio benchmark interno dedicato al settore finanziario, denominato High Finance, nel quale Compass avrebbe ottenuto un miglioramento compreso tra 14 e 16 punti rispetto ad Azure Search. Nel test l’accuratezza del retrieval, misurata attraverso nDCG@10, è passata da 64,8 per Azure Search a 81,1 per Compass. High Finance è costituito da un insieme di domande annotate da Cohere nelle quali il sistema deve individuare materiale pertinente all’interno di presentazioni provenienti da attività di investment banking e hedge fund; la procedura prevede l’embedding della query, il recupero dei documenti dal relativo indice e la valutazione dei risultati presenti nelle prime posizioni. La metodologia utilizzata non era tuttavia identica tra i due sistemi: i documenti destinati ad Azure Search erano stati sottoposti a parsing attraverso GPT-4.1 Mini, mentre Cohere Embed 4 non utilizzava una soluzione separata di parsing e incorporava direttamente i PDF sotto forma di immagini prima della ricerca. Cohere attribuisce il risultato alla combinazione fra i propri modelli per ricerca ed elaborazione documentale e il sistema di hybrid search di Compass, che integra retrieval lessicale, sparse e dense seguito da reranking; trattandosi di un benchmark costruito e riportato direttamente dalla stessa Cohere, il dato descrive le prestazioni ottenute nella metodologia dichiarata dall’azienda e non rappresenta un confronto indipendente fra le due piattaforme.
Compass Cloud mette a disposizione due percorsi principali di integrazione. Le Compass API sono rivolte ai team che costruiscono applicazioni personalizzate di ricerca e RAG e consentono di collegarsi direttamente ai modelli e ai componenti di retrieval utilizzati dalla piattaforma, lasciando agli sviluppatori il controllo sulla rappresentazione dei contenuti, sul recupero delle informazioni, sull’ordinamento dei risultati e sulla modalità con cui questi vengono poi incorporati nell’applicazione. Accanto alle API è disponibile un server MCP dedicato e versionato in maniera indipendente che espone le funzioni di retrieval sotto forma di strumenti riutilizzabili attraverso il Model Context Protocol: qualsiasi client compatibile con MCP può quindi individuare e richiamare direttamente questi strumenti senza richiedere un’integrazione proprietaria differente per ogni framework agentico. Cohere utilizza questo modello anche per quello che definisce agentic retrieval, nel quale la ricerca non consiste più in una singola domanda seguita da una risposta, ma in un processo iterativo nel quale l’agente decide autonomamente che cosa cercare, recupera informazioni, valuta i risultati ottenuti e modifica progressivamente le query fino a individuare il materiale necessario. Attraverso il server MCP di Compass, un agente può restringere gradualmente il corpus sul quale sta lavorando invece di trasferire immediatamente grandi quantità di contesto al modello, con l’obiettivo di diminuire i token superflui e accelerare le operazioni di retrieval più complesse.
La private beta è rivolta soprattutto ai team che stanno sviluppando applicazioni nelle quali retrieval e processi agentici costituiscono una parte significativa del workload. I partecipanti ricevono supporto diretto dal team di ingegneria di Cohere, accesso anticipato alla distribuzione cloud e la possibilità di influenzare lo sviluppo della roadmap attraverso il feedback raccolto durante questa fase. L’azienda continua parallelamente a offrire Compass in modalità self-hosted per i casi nei quali dati, normative o requisiti di sicurezza impediscono l’utilizzo di un servizio gestito, costruendo quindi due modalità di distribuzione basate sulla stessa infrastruttura di ricerca: una destinata alle organizzazioni che vogliono mantenere il controllo completo sull’ambiente e una nella quale ingestion, indicizzazione, retrieval, modelli e inferenza vengono gestiti direttamente da Cohere. L’azienda ha inoltre programmato per l’8 ottobre 2026 una sessione in diretta su X con responsabili dei team engineering e product dedicata all’evoluzione della ricerca enterprise e alle tecnologie sulle quali è basato Compass Cloud.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)