
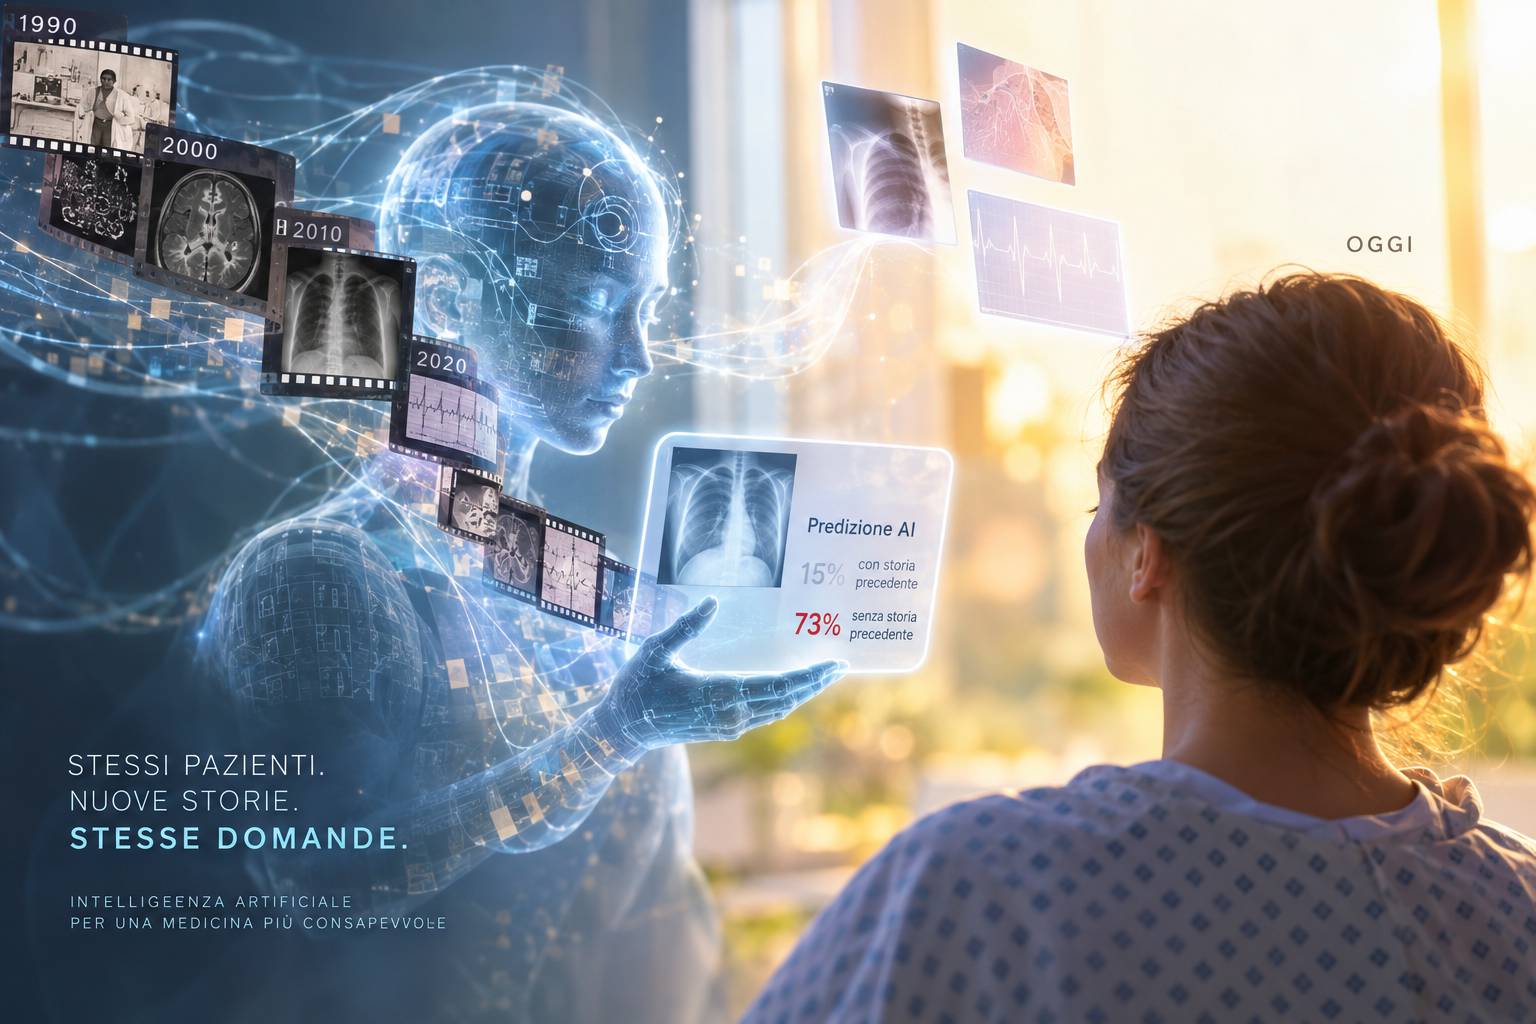
Una collaborazione di ricerca tra Germania e Regno Unito ha individuato un possibile problema nei sistemi di intelligenza artificiale medica addestrati su cartelle cliniche anonimizzate: i modelli possono memorizzare caratteristiche associate a un determinato paziente e lasciare che quelle informazioni influenzino le previsioni effettuate sullo stesso individuo molti anni dopo. I ricercatori definiscono questo fenomeno “memorisation bias”. Il rischio emerge quando un sistema viene addestrato sui dati storici di una popolazione e successivamente utilizzato sulla stessa popolazione, perché una nuova registrazione dello stesso paziente può funzionare come un richiamo parziale dei dati precedentemente appresi dal modello. Il risultato è che la previsione corrente può essere spostata verso lo stato di salute passato del paziente anziché riflettere correttamente le nuove evidenze cliniche. Lo studio mostra che l’effetto può essere rilevabile anche a distanza di decenni.
Un paziente che vent’anni prima era stato trattato per un tumore e successivamente era entrato in remissione potrebbe quindi essere valutato da un modello ancora influenzato dalla precedente condizione oncologica; all’opposto, un paziente che nei dati storici risultava sano potrebbe ricevere una valutazione eccessivamente condizionata da quella precedente situazione favorevole, con il rischio di rendere meno evidente una nuova patologia. Un esempio utilizzato nello studio riguarda una paziente i cui vecchi ECG mostravano condizioni normali: un modello che aveva già visto quei dati assegnava soltanto il 15% di probabilità a un successivo infarto, mentre un modello equivalente che non aveva mai visto la storia clinica precedente arrivava al 73%. Non si tratta quindi soltanto di un problema di privacy o di possibile re-identificazione dei dati, ma di un effetto che può modificare direttamente il comportamento diagnostico del sistema quando incontra nuovamente lo stesso paziente.
Il problema assume particolare rilevanza perché molti sistemi sanitari e le relative indicazioni regolatorie privilegiano dataset rappresentativi della popolazione nella quale il modello verrà effettivamente utilizzato. Questa scelta è utile perché permette al sistema di apprendere caratteristiche epidemiologiche, cliniche e demografiche realmente pertinenti al contesto di destinazione, ma aumenta contemporaneamente la probabilità che le persone presenti nei dati di training vengano incontrate nuovamente durante l’uso clinico. Limitare inoltre l’addestramento a dataset nazionali o regionali può ridurne la varietà e aumentare il rischio che il modello memorizzi configurazioni specifiche anziché generalizzare. Ampliare i dati con popolazioni provenienti da altri paesi non rappresenta però una soluzione automatica, perché potrebbe introdurre distribuzioni sanitarie, prevalenze delle patologie e caratteristiche della popolazione poco rappresentative del contesto nel quale il sistema verrà utilizzato. I ricercatori sottolineano quindi che una certa capacità di apprendere le caratteristiche della popolazione locale è utile, mentre il problema emerge quando questa conoscenza si trasforma nella memorizzazione di individui specifici.
Lo studio ha valutato il fenomeno su quattro grandi dataset medici comprendenti differenti tipi di informazioni cliniche: MIMIC-CXR, costituito da radiografie del torace, MIMIC-IV-ED con dati relativi alle cure di emergenza, MIMIC-ECG e HEEDB, una raccolta molto più ampia di elettrocardiogrammi. Le dimensioni dei dataset andavano da alcune decine di migliaia di pazienti a oltre 1,8 milioni di persone e permettevano di verificare se il fenomeno fosse limitato a uno specifico tipo di dato o architettura. I risultati hanno mostrato invece che il memorisation bias compare in più modalità e configurazioni dei modelli e può produrre variazioni molto rilevanti nelle probabilità diagnostiche, superiori in alcuni casi a 70 punti percentuali. Come controllo, i ricercatori hanno ripetuto le analisi utilizzando suddivisioni casuali dei modelli, senza osservare analoghi cambiamenti significativi nelle previsioni future. L’effetto tende a diventare meno frequente e meno intenso con l’aumentare del tempo trascorso, ma nel dataset HEEDB, che comprende ECG raccolti dagli anni Ottanta fino al 2025, sono rimaste osservabili alterazioni significative oltre 25 anni dopo l’ultima registrazione del paziente presente nei dati di training.
Per misurare le conseguenze cliniche, i ricercatori hanno simulato una situazione nella quale un paziente tornava successivamente a essere valutato da un modello che aveva già utilizzato i suoi vecchi dati durante l’addestramento. I nuovi casi sono stati separati tra pazienti che avevano sviluppato una condizione non presente nei precedenti record e pazienti il cui stato di salute era rimasto sostanzialmente invariato. Nel primo gruppo il memorisation bias ha prodotto un effetto sistematicamente negativo: la sensibilità diagnostica risultava inferiore nei modelli che avevano visto i dati storici dello stesso individuo, con un aumento dei falsi negativi in categorie comprendenti infarti, altre anomalie elettrocardiografiche, patologie polmonari e differenti esiti clinici critici. Quando invece la condizione attuale corrispondeva sostanzialmente a quella storica, la memoria del paziente migliorava artificialmente le prestazioni, aumentando sia sensibilità sia specificità. Questo comportamento può complicare anche la valutazione complessiva del modello, perché buoni risultati sui numerosi pazienti le cui condizioni rimangono stabili potrebbero nascondere una capacità inferiore di individuare nuove patologie negli stessi individui.
Un ulteriore elemento riguarda la natura stessa dei dati sanitari. Le cartelle cliniche elettroniche non rappresentano in maniera uniforme l’intera vita di un individuo, perché vengono generate soprattutto nei periodi in cui la persona entra in contatto con il sistema sanitario. Le persone più malate tendono quindi ad avere una quantità molto maggiore di dati rispetto a quelle sane, e determinate condizioni possono risultare sovrarappresentate nella storia disponibile per l’addestramento. Ricerche precedenti sul cosiddetto informed presence bias hanno mostrato, per esempio, che i pazienti gravemente malati possono avere oltre cinque volte più giornate associate a risultati di laboratorio e quasi sette volte più giornate con prescrizioni farmacologiche rispetto ai pazienti più sani. Di conseguenza, una persona che ha avuto una patologia importante molti anni prima potrebbe essere rappresentata nel dataset soprattutto attraverso quel periodo di malattia, senza una quantità equivalente di record successivi che documentino una lunga fase di buona salute.
Come possibile contromisura, gli autori hanno sperimentato la differential privacy durante l’addestramento, limitando la quantità di informazione relativa ai singoli esempi che il modello può conservare. Applicarla ai singoli record riduceva il memorisation bias ma non riusciva a eliminarlo neppure con le configurazioni più restrittive provate nello studio. Una protezione applicata invece a livello di paziente, considerando congiuntamente tutti i record appartenenti allo stesso individuo, si è dimostrata molto più efficace e ha quasi eliminato il fenomeno. Questa soluzione presenta però difficoltà pratiche: se i dati sono stati anonimizzati in modo irreversibile, può diventare impossibile determinare quali record appartengano alla stessa persona e quindi applicare una protezione coerente a livello individuale. La differential privacy comporta inoltre un aumento delle risorse necessarie all’addestramento, mentre il mancato utilizzo di meccanismi di questo tipo lascia aperta anche la possibilità di membership inference attack, attraverso i quali un attaccante può cercare di determinare se i dati di uno specifico individuo facevano parte del training set.
Il problema deriva quindi anche da una contraddizione tra due obiettivi normalmente considerati positivi. L’anonimizzazione protegge l’identità delle persone incluse nei dataset, ma rende allo stesso tempo più difficile riconoscere in fase di utilizzo che il paziente sottoposto a una nuova valutazione aveva già contribuito ai dati utilizzati per addestrare il modello. Non è quindi semplice escludere automaticamente quella persona dall’interpretazione AI dei propri nuovi esami. Gli autori osservano che i casi nei quali il memorisation bias provoca oggi conseguenze diagnostiche rilevanti sembrano relativamente poco frequenti, ma sottolineano che ricerche precedenti hanno mostrato una tendenza all’aumento della memorizzazione all’aumentare della capacità dei modelli. Con l’espansione contemporanea delle dimensioni dei sistemi AI e dei dataset medici utilizzati per addestrarli, potrebbe quindi crescere anche il numero assoluto di pazienti interessati dal fenomeno, rendendo necessarie modifiche ai protocolli di training, valutazione e distribuzione dei sistemi di AI medica.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)