
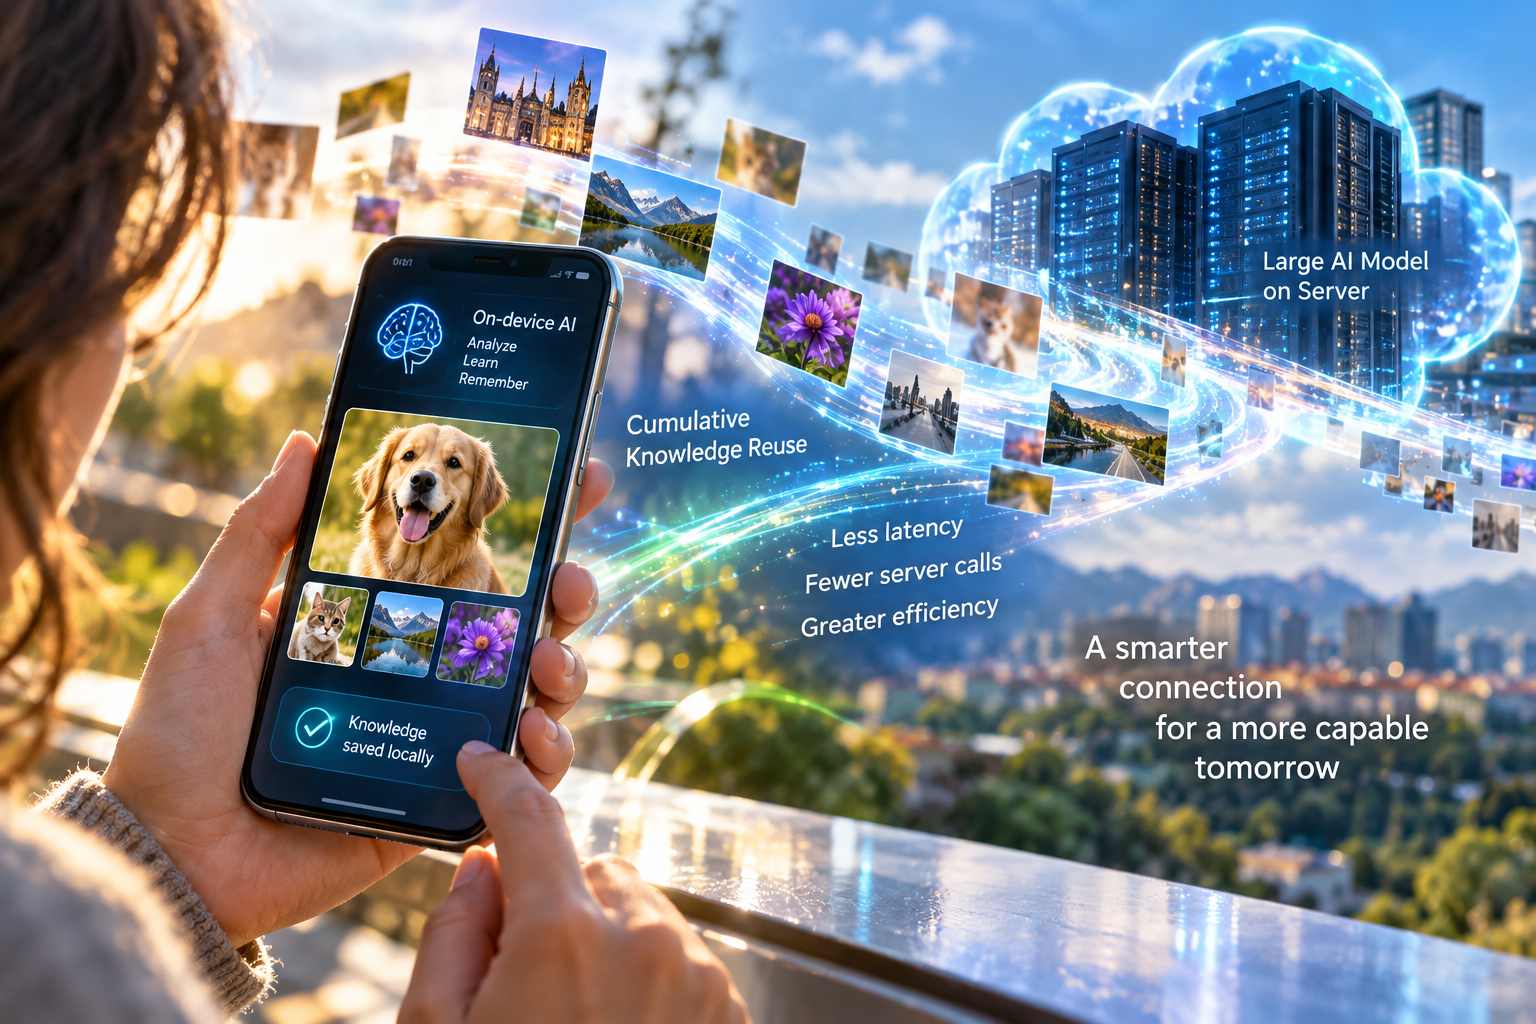
Un gruppo di ricerca del KAIST ha sviluppato CURE, acronimo di Cumulative Knowledge Reuse, un framework per l’inferenza ibrida dispositivo-server che permette a piccoli modelli eseguiti direttamente su smartphone e altri dispositivi con risorse limitate di accumulare e riutilizzare localmente le conoscenze ottenute da modelli più grandi eseguiti sui server. Il sistema è stato sviluppato dal team guidato dal professor Jae-Gil Lee della School of Computing e nasce dal problema tipico delle architetture AI ibride: i modelli compatti installati sul dispositivo possono gestire rapidamente gli input più semplici, ma tendono a perdere accuratezza quando incontrano immagini complesse o poco familiari, mentre inviare sistematicamente ogni richiesta a un modello molto più grande sul server aumenta traffico di rete, tempi di risposta e carico computazionale. Anche i sistemi di collaborazione già esistenti, che delegano al server soltanto gli input considerati difficili, presentano una limitazione precisa: una volta ottenuta la risposta del modello remoto, quella conoscenza viene normalmente utilizzata per il singolo caso e poi scartata, costringendo il dispositivo a interrogare nuovamente il server quando incontra in seguito esempi simili.
CURE introduce invece un processo decisionale progressivo nel quale il dispositivo prova innanzitutto a risolvere autonomamente il problema utilizzando il proprio modello preaddestrato; se la previsione non raggiunge un livello sufficiente di affidabilità, consulta il patrimonio di conoscenze precedentemente accumulato a partire dalle risposte del server e richiede nuovamente l’intervento del modello remoto soltanto quando anche questa seconda fonte non è sufficiente. Il meccanismo non corrisponde a una semplice cache delle risposte né alla memorizzazione delle immagini già elaborate. Il framework mantiene sul dispositivo un reservoir probabilistico costruito nello spazio delle feature del modello locale, nel quale vengono conservate informazioni statistiche utili a distinguere classi e caratteristiche visive ricorrenti. In questo modo le conoscenze ricavate da una precedente richiesta al server possono essere generalizzate anche a nuove immagini simili, anziché essere riutilizzate soltanto quando ricompare esattamente lo stesso input. Il sistema utilizza inoltre un meccanismo di routing dell’incertezza in due fasi: una prima selezione valuta la sicurezza della previsione prodotta direttamente dal modello locale, mentre una seconda verifica stabilisce se il reservoir accumulato possieda già informazioni sufficientemente affidabili per evitare una nuova delega al server.
La sperimentazione è stata condotta utilizzando MobileCLIP2 come modello leggero sul dispositivo ed EVA-CLIP da 18 miliardi di parametri come modello ad alte prestazioni sul server, all’interno di attività di classificazione delle immagini basate su modelli vision-language. Su diversi dataset CURE ha mantenuto livelli di accuratezza molto vicini a quelli ottenuti inviando sistematicamente ogni input al modello server; nel caso di ImageNet, il framework ha raggiunto un’accuratezza dell’82,43%, rispetto all’83,68% ottenuto delegando tutte le immagini al sistema remoto. Considerando l’insieme delle valutazioni, il sistema riduce in media del 55,61% il numero di chiamate al server rispetto a un approccio ibrido non cumulativo, cioè privo della capacità di conservare e riutilizzare le conoscenze ricevute in precedenza. I test end-to-end, che includono anche il tempo necessario per la comunicazione tra dispositivo e server, hanno mostrato inoltre una velocità di elaborazione fino a 2,80 volte superiore rispetto alla collaborazione ibrida tradizionale e fino a 3,67 volte superiore rispetto alla strategia che invia ogni singolo input al server. La riduzione della latenza deriva soprattutto dal minor numero di trasferimenti di dati e di attese per la risposta remota, un aspetto particolarmente rilevante perché nelle misurazioni effettuate dai ricercatori la comunicazione rappresentava una parte consistente del tempo necessario per ciascuna interrogazione.
CURE differisce inoltre dalla knowledge distillation, nonostante entrambe le tecniche possano essere descritte attraverso una relazione tra un modello grande che svolge il ruolo di insegnante e uno più piccolo utilizzato come studente. Nella distillazione tradizionale le conoscenze del modello più grande vengono trasferite al modello compatto attraverso una nuova fase di addestramento che modifica i suoi parametri; CURE, invece, non modifica né riaddestra i pesi del modello installato sul dispositivo né quelli del sistema server. Il framework aggiunge un archivio separato delle conoscenze ottenute durante l’utilizzo e può quindi essere applicato a modelli già esistenti senza richiedere nuovi dataset di training o ulteriori cicli di ottimizzazione. Le analisi di ablazione mostrano inoltre che il feedback proveniente dal server svolge un ruolo essenziale: eliminare dal reservoir gli aggiornamenti derivati dal modello remoto riduce fortemente l’accuratezza, mentre eliminare la fusione delle probabilità tra le diverse fonti lascia sostanzialmente invariato il numero di deleghe ma peggiora il risultato finale. Il funzionamento del framework dipende quindi non soltanto dalla scelta di quando interrogare il server, ma anche da come le informazioni locali e quelle accumulate vengono combinate durante la decisione.
L’obiettivo applicativo è utilizzare questo approccio su smartphone, robot, dispositivi indossabili e altri sistemi edge nei quali capacità di calcolo, memoria, consumo energetico e connettività rappresentano vincoli concreti. Ridurre il numero delle interrogazioni remote può diminuire i tempi di risposta e il traffico di rete, ma il team sottolinea che questo non significa automaticamente ottenere una riduzione equivalente dei costi complessivi di esercizio: i vantaggi reali dipendono infatti dalla potenza del dispositivo, dallo spazio occupato dal reservoir locale, dalle condizioni della rete e dalla distribuzione degli input incontrati durante l’utilizzo. I ricercatori intendono quindi verificare ulteriormente velocità di risposta, consumo energetico, requisiti di memoria e stabilità nel lungo periodo su differenti piattaforme mobili, oltre a estendere il framework a compiti vision-language più articolati e a studiare sistemi capaci di mantenere affidabile la conoscenza accumulata anche quando la distribuzione dei dati cambia sensibilmente nel tempo. Il lavoro, intitolato “CURE: Cumulative Knowledge Reuse for Efficient Device-Server Hybrid Inference in Vision-Language Models”, è stato presentato a ECCV 2026.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)