
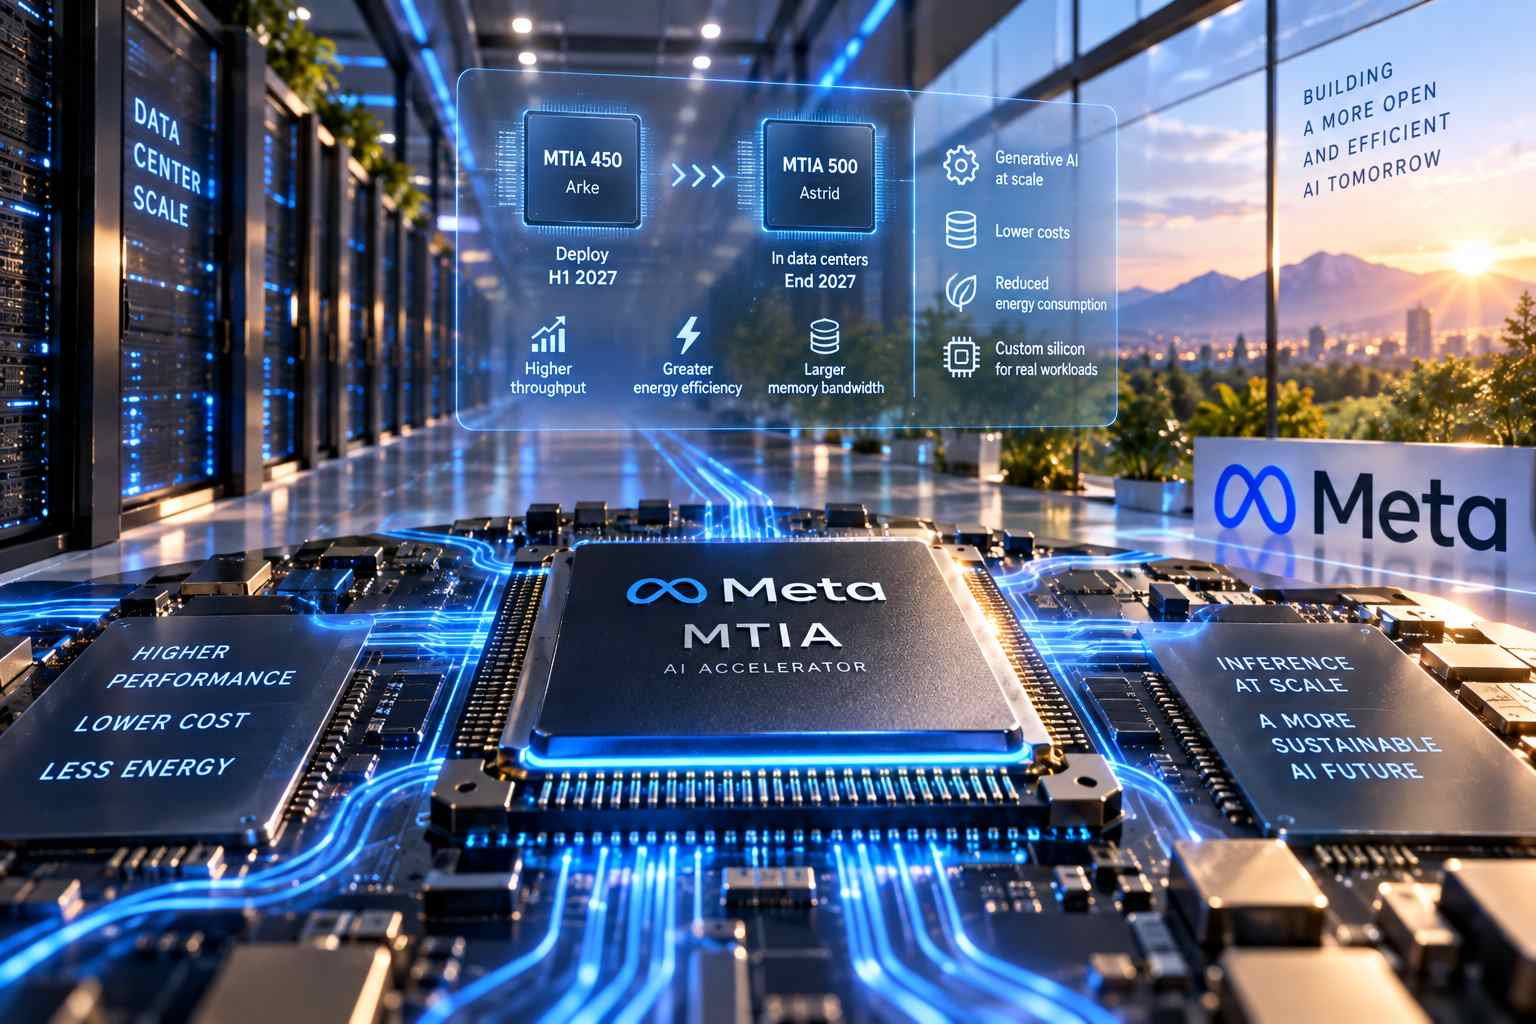
Meta sta accelerando il deployment dei propri acceleratori AI sviluppati internamente con l’obiettivo di ridurre costi ed energia necessari per l’inferenza nei data center. La società sta testando MTIA 450, nome in codice Arke, e prevede di iniziarne la distribuzione su larga scala nella prima metà del 2027. La generazione successiva, MTIA 500, nome in codice Astrid, dovrebbe invece completare la fase di progettazione nell’autunno del 2026 e raggiungere i data center entro la fine del 2027, con un impiego previsto ancora più ampio.
MTIA, Meta Training and Inference Accelerator, è la famiglia di chip personalizzati che Meta sviluppa in collaborazione con Broadcom e produce attraverso TSMC. Il programma è stato avviato per affiancare acceleratori esterni come le GPU NVIDIA con hardware progettato direttamente sulle caratteristiche dei workload interni. Meta punta in particolare a migliorare due parametri considerati centrali nell’infrastruttura su scala molto elevata: quantità di lavoro svolto per watt consumato e quantità di lavoro ottenuta per ogni dollaro speso.
La strategia adottata per le nuove generazioni MTIA prevede cicli di sviluppo molto più rapidi rispetto alla tradizionale evoluzione dei chip destinati ai data center. Meta indica intervalli di sei mesi o inferiori tra alcune generazioni, utilizzando componenti modulari e riutilizzando elementi delle architetture precedenti. In questo modo le caratteristiche dei chip possono essere aggiornate più rapidamente in funzione dei cambiamenti dei modelli AI e dei colli di bottiglia osservati direttamente nei workload di produzione.
MTIA 450 rappresenta una delle generazioni maggiormente orientate all’inferenza generativa. Il chip supporta calcolo a bassa precisione e introduce ottimizzazioni specifiche per aumentare il throughput senza richiedere conversioni software continue tra diversi formati numerici. Meta ha dichiarato che, rispetto al calcolo FP16/BF16, MTIA 450 può fornire una capacità MX4 significativamente superiore, sfruttando formati a precisione ridotta sviluppati per preservare la qualità dei modelli mantenendo basso l’impatto sull’area del chip.
Un elemento rilevante riguarda l’avvicinamento tra simulazione e silicio reale. Dodici prototipi MTIA 450 prodotti da TSMC sono arrivati a Meta il 1° settembre 2026 e, secondo i test interni, le prestazioni misurate si sono discostate soltanto del 2-3% rispetto a quanto previsto dalle simulazioni precedenti alla produzione. Già nel primo giorno di test i chip sono riusciti a eseguire sia modelli interni di Meta sia modelli sviluppati da DeepSeek e Alibaba, mostrando che l’architettura non è limitata esclusivamente ai modelli proprietari dell’azienda.
Il programma MTIA non è infatti pensato per un unico tipo di rete neurale. Le generazioni più recenti sono progettate per coprire ranking, recommendation, inferenza generativa e, in misura crescente, workload AI più generali. Nel breve periodo Meta intende tuttavia utilizzare MTIA 400, 450 e 500 principalmente per la produzione di inferenza generativa, dove la possibilità di ottimizzare costo e consumo energetico su volumi molto elevati può incidere direttamente sui costi operativi dei servizi.
MTIA 500 prosegue questa impostazione incrementando ulteriormente capacità di memoria e throughput. Rispetto a MTIA 450, Meta indica un aumento del 50% della larghezza di banda HBM, una capacità HBM fino all’80% superiore e un incremento del 43% delle prestazioni MX4. L’architettura utilizza una configurazione composta da quattro chiplet di calcolo disposti in una struttura 2×2, circondati da stack HBM, chiplet di rete e un chiplet SoC incaricato della connettività PCIe verso la CPU host e verso le interfacce di rete scale-out.
Dal passaggio tra MTIA 300 e MTIA 500, Meta dichiara un aumento complessivo di 4,5 volte della larghezza di banda HBM e fino a 25 volte della capacità di calcolo, considerando il passaggio dalle operazioni MX8 della generazione 300 alle operazioni MX4 della generazione 500. L’aumento non deriva quindi soltanto dalla crescita delle unità computazionali, ma anche dall’evoluzione della gerarchia di memoria, del networking e dei formati numerici utilizzati durante l’inferenza.
La scelta di progettare chip specifici per l’inferenza deriva anche dalla diversa struttura economica dei workload. Gli acceleratori più generali vengono spesso progettati per soddisfare i requisiti molto elevati del pre-training dei grandi modelli e vengono successivamente utilizzati anche in inferenza. Meta punta invece a costruire hardware che non debba necessariamente sostenere tutte le caratteristiche richieste dal training più pesante e che possa quindi offrire un rapporto migliore tra costo, consumo e throughput nei carichi utilizzati quotidianamente dai propri servizi.
La società prevede di installare oltre 1 gigawatt di capacità basata su chip proprietari nell’arco dei prossimi dodici mesi e di aumentare ulteriormente il ritmo in seguito se continuerà a crescere la domanda di inferenza. A queste dimensioni, anche piccole differenze nel costo per acceleratore, nell’efficienza energetica o nel numero di token elaborati per unità di potenza possono tradursi in variazioni rilevanti della spesa complessiva dell’infrastruttura.
La progettazione dei chip viene inoltre collegata direttamente allo sviluppo dei modelli. Meta Superintelligence Labs partecipa alla definizione dei requisiti delle generazioni successive, permettendo ai progettisti hardware di utilizzare informazioni sui workload futuri anziché basarsi esclusivamente sui modelli già in produzione. L’obiettivo è ridurre il divario temporale tipico del settore, nel quale un processore può arrivare sul mercato diversi anni dopo l’inizio della progettazione e trovarsi a dover eseguire modelli molto differenti da quelli per cui era stato originariamente dimensionato.
Meta aveva valutato anche un progetto più ampio denominato Olympus, destinato a gestire sia training sia inferenza e inizialmente previsto per il periodo 2028-2029. Il programma è stato però cancellato e la società ha scelto di concentrare maggiormente lo sviluppo interno sull’inferenza. Uno dei motivi indicati riguarda il costo: quando l’infrastruttura raggiunge una scala di diversi gigawatt, una variazione percentuale significativa nel prezzo degli acceleratori può incidere per miliardi di dollari sul costo complessivo del sistema.
Gli MTIA attuali non sono progettati principalmente per workload che richiedono la minima latenza possibile. Meta li considera piuttosto motori destinati all’inferenza general purpose, nei quali efficienza, throughput e costo assumono maggiore importanza rispetto al raggiungimento della latenza assoluta più bassa. Le generazioni successive ad Astrid dovrebbero aumentare ulteriormente velocità e capacità di elaborazione e utilizzare anche collegamenti ottici per migliorare la comunicazione tra gli acceleratori.
La strategia non prevede comunque l’eliminazione degli acceleratori esterni. Meta continua a utilizzare un portafoglio eterogeneo di GPU e altri sistemi commerciali, mentre MTIA costituisce una componente aggiuntiva destinata ai workload nei quali l’hardware sviluppato internamente può risultare economicamente più efficiente. La possibilità di spostare una parte crescente dell’inferenza sui propri chip permette inoltre alla società di ridurre la dipendenza da un singolo fornitore e di decidere direttamente caratteristiche hardware, formati numerici, networking e roadmap delle future generazioni.
Con MTIA 450 e MTIA 500, Meta sta quindi trasformando il programma di silicio interno da progetto sperimentale a componente strutturale dei propri data center. Il primo dovrebbe entrare nella fase di deployment su larga scala nella prima metà del 2027, mentre MTIA 500 è previsto entro la fine dello stesso anno con maggiori capacità di memoria, banda e calcolo. L’obiettivo rimane utilizzare hardware costruito intorno ai workload reali dell’azienda per aumentare il numero di inferenze eseguite a parità di energia e investimento infrastrutturale.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)