
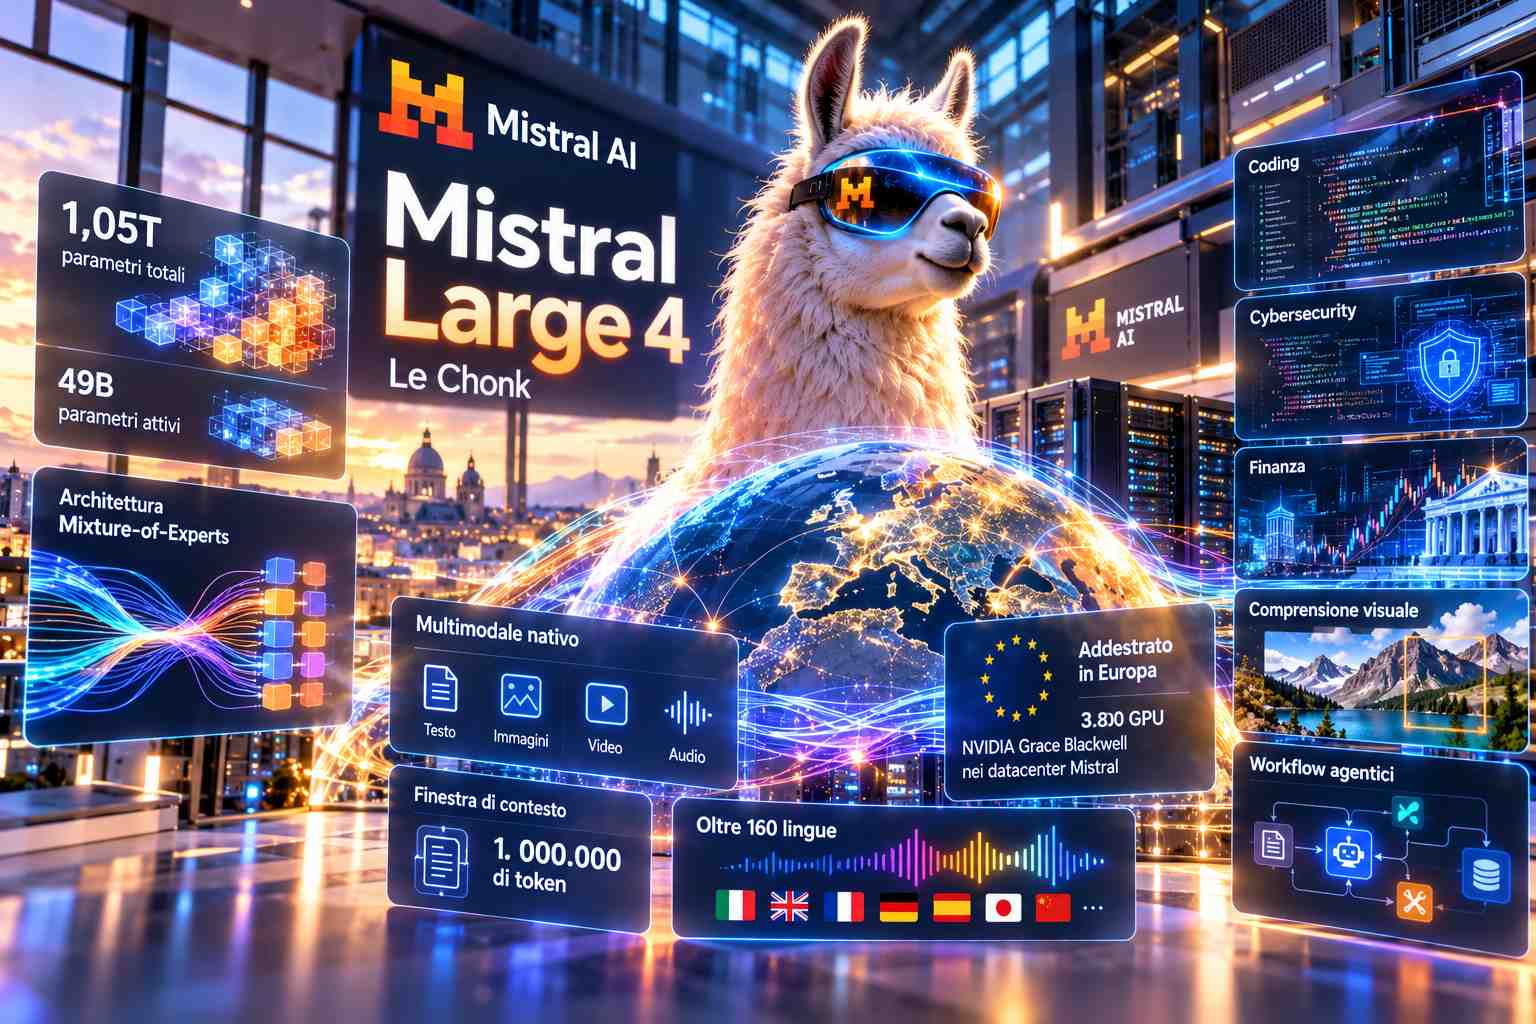
Mistral AI ha annunciato la disponibilità dei pesi scaricabili di Mistral Large 4, modello di intelligenza artificiale noto anche con il nome informale Le Chonk, completando il rilascio avviato con la versione preliminare presentata il 6 ottobre. Il sistema adotta un’architettura Mixture of Experts con 1,05 trilioni di parametri complessivi e circa 52 miliardi di parametri attivi nel conteggio che include anche embedding e livelli di output. La documentazione distingue questo valore dai circa 49 miliardi di parametri attivati per singolo token, evitando di attribuire la differenza a una modifica necessariamente intervenuta nell’architettura durante il periodo di sviluppo. Il modello supporta input testuali e visivi, produce output testuali e dispone di una finestra contestuale dichiarata fino a un milione di token. La versione definitiva incorpora ulteriori attività di reinforcement learning e riscontri ottenuti da clienti e partner specializzati in sicurezza nelle settimane successive alla presentazione iniziale. La data di pubblicazione dei pesi, inizialmente prevista per il 27 ottobre, è stata spostata al 29 ottobre. Mistral ha specificato di aver utilizzato 3.800 GPU NVIDIA Grace Blackwell per l’addestramento, aggiornando la precedente indicazione approssimativa di 4.000 acceleratori. I pesi sono disponibili su Hugging Face con la Mistral Ecosystem Open-Weight License, mentre il modello può essere utilizzato attraverso Mistral Studio e le relative API, OpenRouter, Vibe Code, Microsoft Foundry con possibilità di distribuzione privata su Azure e servizi NVIDIA comprendenti endpoint ospitati e container NIM ottimizzati. Per l’esecuzione autonoma dei pesi scaricati, la società indica il supporto di framework quali vLLM e SGLang.
La valutazione indipendente pubblicata il 29 ottobre da Artificial Analysis attribuisce a Mistral Large 4, nella configurazione di ragionamento high, un punteggio di 26 nell’Intelligence Index v5, rispetto ai 25 punti ottenuti dalla versione preliminare. Il risultato colloca il modello un punto sopra Muse Spark Open nella configurazione xhigh e lo rende, in questa specifica valutazione, il modello con pesi disponibili sviluppato al di fuori della Cina con il punteggio più elevato. Il primato riguarda tuttavia questo segmento geografico e non l’intera categoria dei modelli open-weight, nella quale risultano presenti sette sistemi con punteggi superiori. DeepSeek V4.1 Flash 1017 e GLM-5.3 raggiungono entrambi 32 punti nelle configurazioni di ragionamento massimo, mentre MiMo-V2.6-Pro ottiene 30 punti. Le differenze devono inoltre essere interpretate considerando gli ambienti di prova, le configurazioni di ragionamento e i programmi che coordinano le chiamate agli strumenti. Mistral Large 4 introduce tre livelli di ragionamento: low, che sostituisce la precedente modalità None, medium, destinato alle attività ordinarie, e high, previsto per le richieste più complesse. Le nuove opzioni consentono di selezionare livelli differenti di elaborazione, con effetti sul numero di token utilizzati, sui tempi di risposta e sul costo delle operazioni. Artificial Analysis indica che i miglioramenti più consistenti rispetto alla versione preliminare riguardano l’efficienza nell’utilizzo dei token, il costo delle attività e la riduzione delle risposte contenenti informazioni inventate, mentre l’incremento del punteggio generale rimane relativamente contenuto.
La riduzione dei costi rappresenta uno dei principali cambiamenti della versione definitiva. Mistral ha fissato per le API una tariffa di 0,70 dollari per milione di token di input, 0,07 dollari per milione di token di input recuperati dalla cache e 2,10 dollari per milione di token di output. I prezzi precedenti erano rispettivamente di 1,36, 0,14 e 4,18 dollari, determinando una riduzione approssimativa della metà delle tariffe unitarie. Nelle misurazioni di Artificial Analysis, il costo medio per attività dell’Intelligence Index è passato da 5,54 dollari della versione preliminare a 2,06 dollari nella configurazione high, con una riduzione del 63%. Muse Spark Open presenta un costo comparabile di 2,02 dollari, mentre DeepSeek V4.1 Flash 1017 registra 0,60 dollari e MiMo-V2.6-Pro 0,26 dollari nelle rispettive configurazioni valutate. Il risultato economico di Mistral Large 4 risulta quindi sensibilmente migliorato rispetto alla versione precedente, ma non corrisponde al costo più basso dell’intera categoria. Il numero di token prodotti, le tariffe in ingresso e in uscita, l’utilizzo della cache e la frequenza delle ripetizioni influenzano il costo effettivo di una procedura. Le misurazioni dell’Intelligence Index non comprendono inoltre tutte le spese legate all’esecuzione su infrastrutture proprie, alla personalizzazione del modello, alla supervisione operativa e all’eventuale revisione umana dei risultati.
Le valutazioni dedicate alla programmazione mostrano risultati particolarmente rilevanti per le applicazioni agentiche. Nel Coding Agent Index di Artificial Analysis, Mistral Large 4 nella configurazione high, associato a Mistral Vibe, ha raggiunto 48 punti, collocandosi al secondo posto tra le configurazioni open-weight considerate, a un punto da GLM-5.3 con OpenCode, che registra 49 punti, e davanti a DeepSeek V4.1 Flash 1017 con DeepSeek Harness, che ottiene 46 punti. L’esecuzione dei compiti ha richiesto mediamente 8,5 milioni di token per attività con Mistral Large 4, rispetto ai 15,9 milioni della configurazione GLM-5.3 e ai 16,7 milioni della configurazione DeepSeek, corrispondenti a un consumo inferiore di circa il 47% rispetto a GLM-5.3. Questi risultati riguardano configurazioni agentiche complete, nelle quali il modello opera insieme a software che gestisce strumenti, ambiente di programmazione e sequenza operativa, e non misurano esclusivamente le capacità del modello isolato. Il Coding Agent Index comprende prove come FrontierCode v1.1, Terminal-Bench 4.0 e SWE-Atlas-QnA-AA, mentre l’Intelligence Index utilizza una composizione differente di attività, comprendente FrontierCode 2.0. Le due valutazioni non sono quindi intercambiabili e possono produrre risultati diversi anche per lo stesso modello.
Mistral dichiara che la versione definitiva di Large 4 ha raggiunto il 41% in Terminal-Bench 4.0, rispetto al 28% della versione preliminare, riducendo contemporaneamente del 30% il consumo dei token di output. Artificial Analysis ha tuttavia registrato il 25% sullo stesso benchmark nel proprio ambiente di valutazione, evidenziando una differenza che non può essere attribuita con precisione a un singolo elemento della configurazione. Una situazione analoga riguarda FrontierCode 2.0, per il quale Mistral comunica un risultato del 19,7%, superiore al 19,3% indicato per DeepSeek nella propria comparazione, mentre Artificial Analysis attribuisce a Mistral Large 4 il 15%, a DeepSeek il 29% e a GLM-5.3 il 22%. La società ha inoltre presentato uno studio di preferenza cieca denominato Surge Code, nel quale Large 4 è stato preferito nel 64% dei confronti rispetto a GLM-5.3 e Kimi K3, nel 56% rispetto a DeepSeek V4.1 Flash e nel 22% rispetto a Claude Opus 5.5. Questi risultati misurano preferenze espresse nei confronti presentati e non costituiscono una valutazione equivalente alla percentuale di attività completate correttamente. Nelle prove più ampie di conoscenza e attività agentiche, Artificial Analysis segnala ulteriori differenze rispetto ai modelli open-weight cinesi: nel benchmark AA-Briefcase, Large 4 registra un punteggio Elo di 1.349, contro 1.570 di DeepSeek e 1.504 di GLM-5.3. Nel confronto con Muse Spark Open, invece, Terminal-Bench rappresenta uno degli ambiti in cui Mistral presenta il vantaggio più evidente, con il 25% rispetto all’8% misurato nell’Intelligence Index.
La distribuzione dei pesi è regolata dalla Mistral Ecosystem Open-Weight License, una licenza derivata dalla MIT ma integrata con una specifica condizione commerciale. Il testo consente di eseguire, copiare, modificare, riaddestrare, distribuire, concedere in sublicenza e commercializzare il modello e le sue versioni derivate, mantenendo le comunicazioni relative al copyright e alle autorizzazioni previste. Tuttavia, per determinati utilizzi commerciali è richiesto un accordo separato con Mistral. La condizione si applica quando il licenziatario o una società affiliata gestisce un’attività di model-as-a-service che mette il modello o le sue versioni derivate a disposizione di terzi per inferenza o post-training, attraverso API, endpoint ospitati o altre modalità nelle quali i clienti dispongano di un controllo significativo su input, parametri o dati di addestramento. La licenza non prevede soglie di fatturato e distingue quindi le attività in base alle modalità del servizio, non alla dimensione economica dell’operatore. Sono previste esclusioni per i prodotti destinati agli utenti finali nei quali le capacità del modello sono integrate esclusivamente in funzionalità applicative specifiche e per i servizi che si limitano a inoltrare richieste verso modelli ospitati da altri operatori. L’utilizzo interno del modello, senza rendere il modello o i suoi derivati disponibili a terzi, è inoltre esentato dalla condizione relativa alla licenza commerciale separata, anche quando l’azienda o una sua affiliata opera nel settore model-as-a-service. Risultano esclusi dalla medesima condizione anche gli utilizzi effettuati attraverso i prodotti ufficiali Mistral. La disponibilità dei pesi scaricabili permette pertanto alle organizzazioni di mantenere un maggiore controllo sull’installazione, sulla personalizzazione e sulla continuità di utilizzo del sistema, fermo restando il rispetto delle condizioni di licenza e la necessità di sostenere autonomamente i costi dell’infrastruttura quando si sceglie un’installazione privata.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI).