
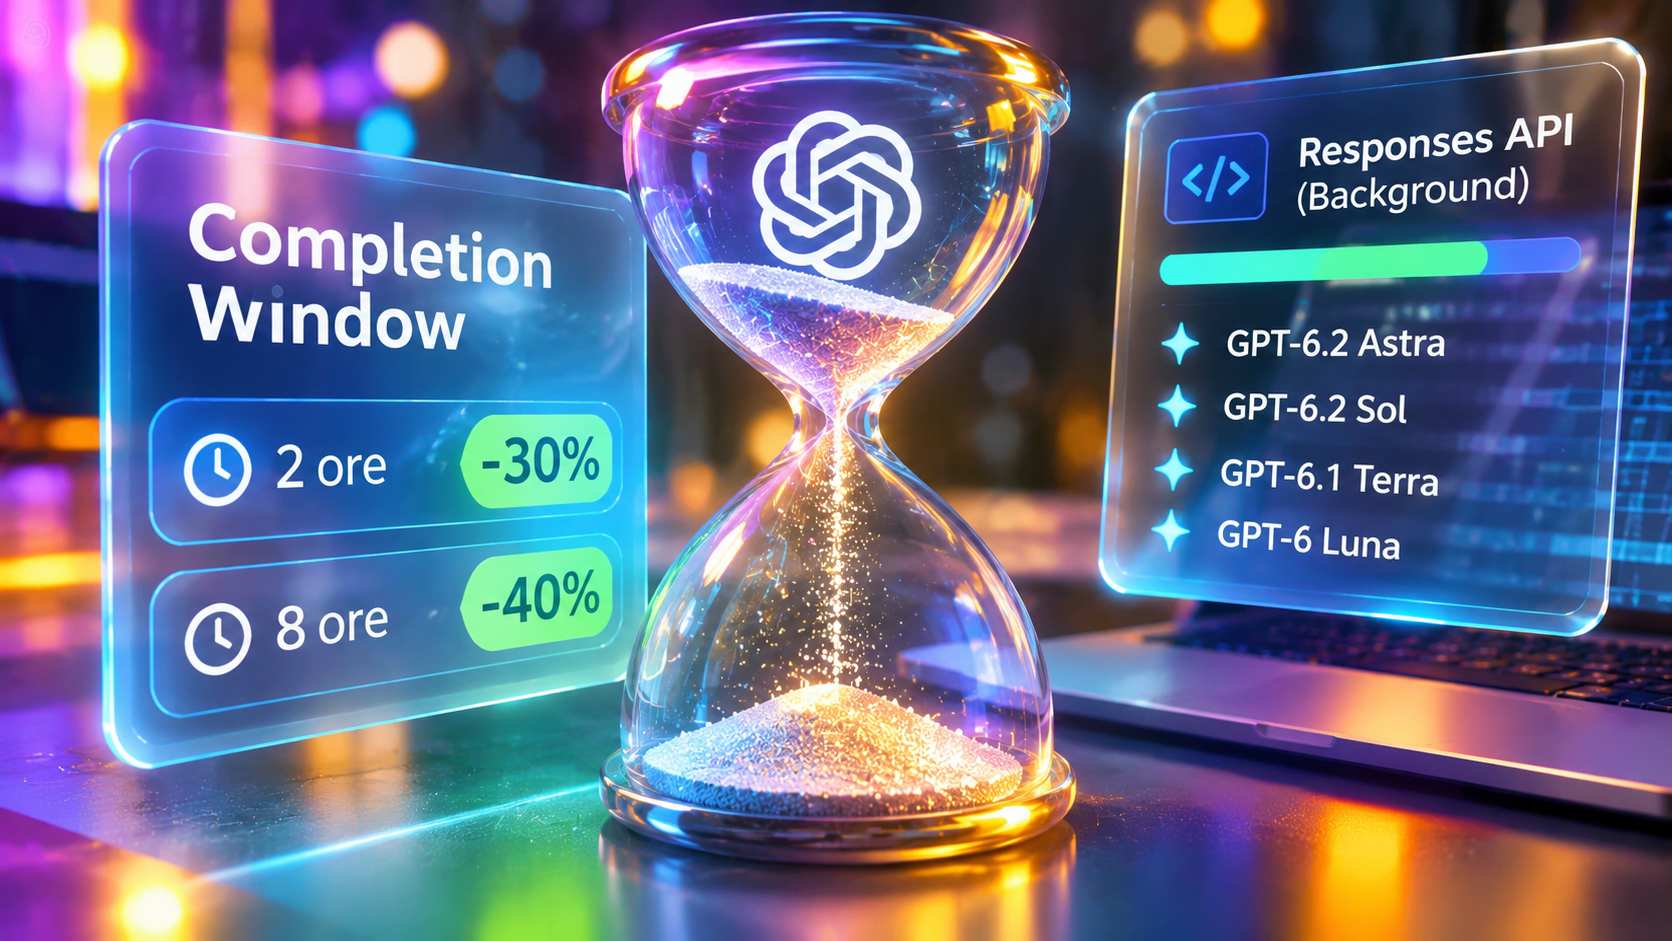
OpenAI ha introdotto il 18 novembre 2026 una nuova modalità di tariffazione delle API che permette agli sviluppatori di ridurre i costi delle elaborazioni di intelligenza artificiale accettando tempi di completamento più lunghi rispetto alle richieste standard. La funzionalità, denominata Completion Window, è disponibile in versione beta pubblica all’interno della modalità Background della Responses API e consente di scegliere una finestra temporale di due oppure otto ore. Nel primo caso viene applicato uno sconto del 30% sulla tariffa ordinaria per token, mentre nel secondo la riduzione raggiunge il 40%. Il sistema è destinato alle applicazioni che non richiedono risposte immediate e che possono quindi distribuire il lavoro su intervalli temporali più estesi, utilizzando una modalità di esecuzione differita.
La nuova opzione è disponibile per quattro modelli: GPT-6.2 Astra, GPT-6.2 Sol, GPT-6.1 Terra e GPT-6 Luna. L’impostazione della finestra temporale indica il periodo entro il quale OpenAI punta a completare la richiesta e non introduce necessariamente un ritardo artificiale nella restituzione dei risultati. Un’elaborazione configurata con una finestra di otto ore può quindi terminare molto prima, qualora le risorse computazionali siano disponibili. Gli sviluppatori possono continuare a utilizzare la modalità standard per le operazioni che richiedono tempi di risposta ridotti, mentre la Completion Window offre una possibilità di ottimizzazione economica per i processi che possono essere pianificati senza vincoli di immediatezza.
Il funzionamento è stato integrato nella Responses API, che permette di gestire richieste strutturate e processi comprendenti più interazioni con il modello. In modalità Background, l’elaborazione può proseguire indipendentemente dalla connessione immediata utilizzata per avviarla, consentendo all’applicazione di recuperare successivamente il risultato. La Completion Window aggiunge a questa architettura un criterio temporale che influisce sul prezzo dell’elaborazione. La scelta tra due e otto ore consente di distinguere attività che richiedono un completamento relativamente rapido da operazioni che possono essere eseguite nell’arco di una parte consistente della giornata.
Tra le applicazioni previste figurano l’elaborazione di grandi raccolte documentali, la produzione di report, l’analisi di informazioni aziendali e le attività affidate ad agenti AI che eseguono sequenze operative prolungate. Un sistema incaricato di analizzare centinaia di documenti durante la notte, ad esempio, può utilizzare la finestra di otto ore per ottenere un risultato entro il periodo previsto, riducendo il costo dei token elaborati rispetto alla tariffa standard. La modalità è applicabile anche ai flussi multi-turno, nei quali una richiesta iniziale viene seguita da ulteriori interrogazioni, ricerche documentali o chiamate a strumenti esterni. Quando le richieste successive rispettano le condizioni della modalità differita, possono beneficiare della medesima struttura tariffaria.
La differenziazione economica assume particolare rilievo per i carichi di lavoro basati su modelli avanzati, nei quali il costo complessivo dipende dal volume dei token utilizzati e dal numero di interazioni necessarie per completare un’attività. La possibilità di ottenere una riduzione del 30% o del 40% non comporta necessariamente una diminuzione del consumo computazionale effettivo, ma permette al fornitore di organizzare l’esecuzione delle richieste in modo meno vincolato ai picchi di domanda immediata. Per gli sviluppatori, l’ottimizzazione consiste nel definire correttamente quali operazioni possono essere elaborate in maniera differita senza compromettere le esigenze applicative.
La nuova modalità si collega inoltre alla progressiva sostituzione di Flex, il sistema di elaborazione a costo ridotto che consentiva di accettare tempi di risposta variabili e possibili indisponibilità temporanee delle risorse in cambio di tariffe inferiori. OpenAI ha comunicato che Flex non verrà offerto per i nuovi modelli a partire da GPT-6.2 Astra e GPT-6.2 Sol. La Completion Window introduce quindi un’alternativa basata su intervalli temporali espliciti, attraverso i quali lo sviluppatore può associare direttamente il livello di sconto al tempo disponibile per l’esecuzione.
La disponibilità in beta pubblica riguarda attualmente i modelli indicati e non implica automaticamente l’applicazione degli stessi sconti a tutte le API o alle precedenti modalità di elaborazione. La funzionalità definisce una distinzione operativa tra richieste interattive e processi differibili, consentendo di pianificare il consumo delle risorse AI in funzione delle effettive esigenze temporali delle applicazioni.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)