
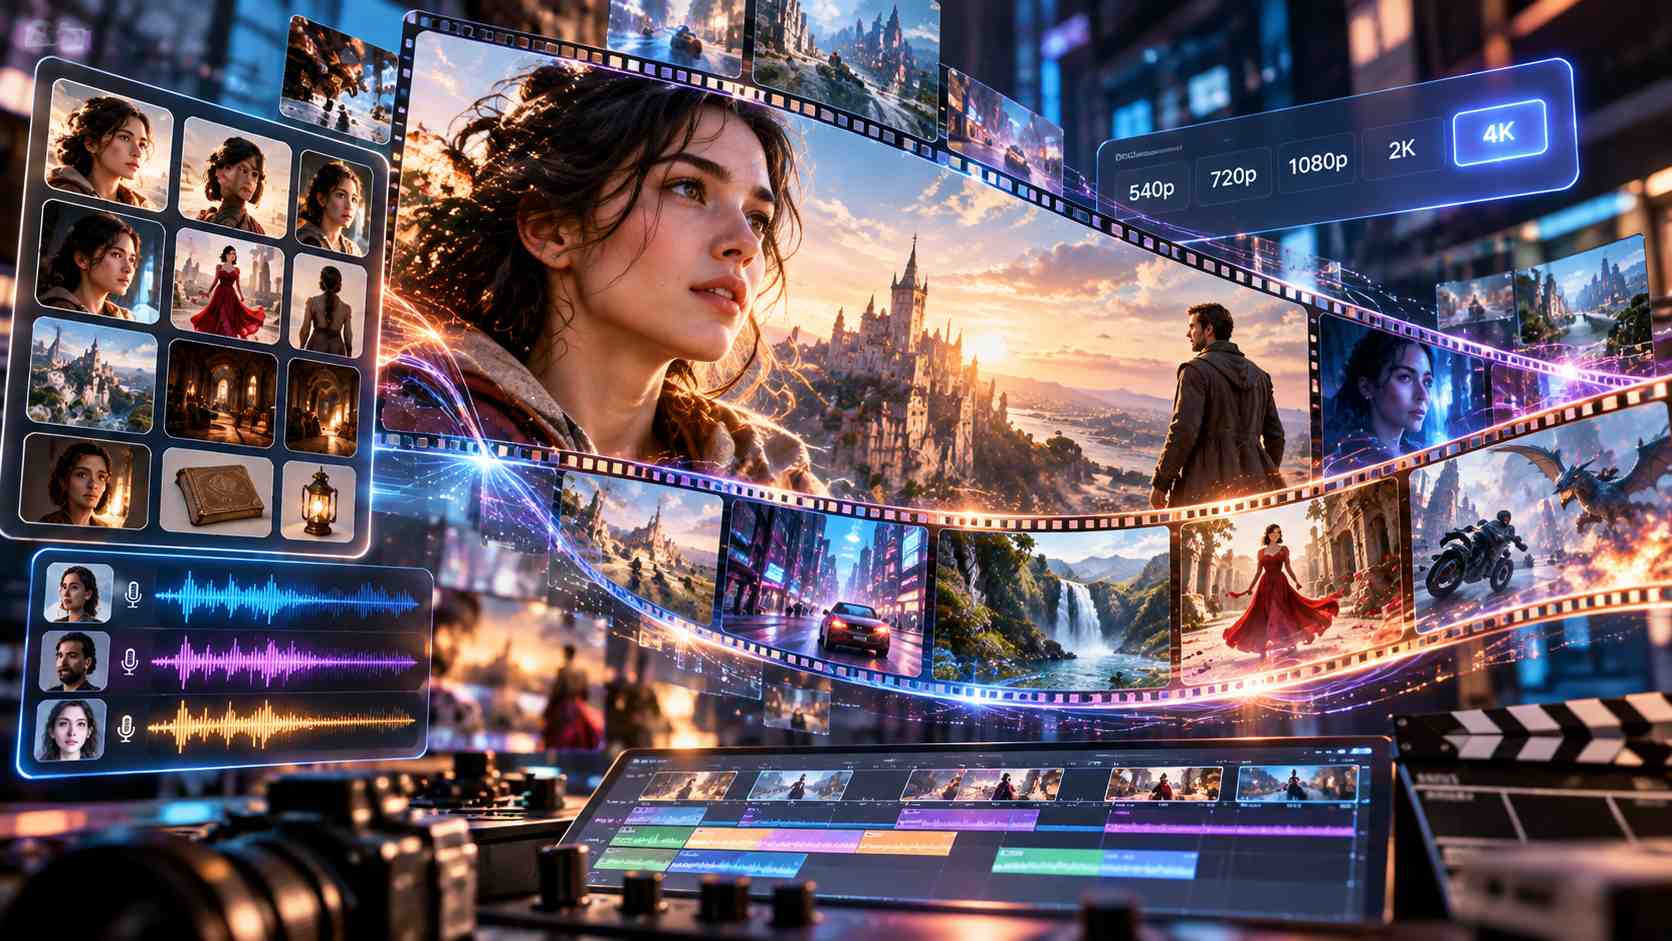
ShengShu Technology ha presentato Vidu Q4 Preview, la prima versione pubblicamente accessibile della nuova generazione del proprio modello di punta per la produzione di contenuti audiovisivi mediante intelligenza artificiale. Il sistema, disponibile dal 7 ottobre 2026 attraverso la piattaforma web Vidu e le relative API, è stato sviluppato per migliorare il controllo sulla recitazione dei personaggi sintetici, sulla continuità visiva delle scene, sui movimenti di macchina e sulla sincronizzazione tra immagini e audio. Una delle caratteristiche principali consiste nella possibilità di utilizzare contemporaneamente fino a quindici immagini e tre riferimenti audio, consentendo di definire in maniera più precisa l’aspetto dei soggetti, gli abiti, gli oggetti presenti nella scena, gli ambienti e le caratteristiche vocali dei personaggi. Il modello supporta generazioni con risoluzioni fino a 4K e profondità colore a 10 bit, caratteristiche destinate a offrire una maggiore ricchezza tonale e una qualità visiva adatta anche a produzioni che richiedono successivi interventi di montaggio o postproduzione. Il prezzo iniziale annunciato parte da 0,014 dollari per secondo di video generato, con condizioni che possono variare in funzione della risoluzione, delle funzionalità selezionate, dell’abbonamento e del mercato di riferimento.
L’architettura di Vidu Q4 Preview è stata progettata per coordinare in modo più stretto l’espressione facciale, lo stato emotivo, il movimento corporeo e la voce dei personaggi. Nelle precedenti generazioni di video sintetici, la conservazione della coerenza tra queste componenti poteva risultare complessa, soprattutto in presenza di movimenti articolati o di sequenze che richiedevano variazioni emotive durante il dialogo. Il nuovo modello introduce un’elaborazione congiunta destinata a rendere più sottili le espressioni del volto, più riconoscibili le intenzioni emotive e maggiormente naturali i movimenti del corpo. I riferimenti vocali consentono di associare fino a tre campioni audio alla generazione, contribuendo a mantenere costante l’identità della voce e ad allineare l’intonazione allo sviluppo della scena. Parallelamente, i riferimenti visivi permettono di stabilire quali elementi debbano rimanere riconoscibili nella composizione: un personaggio può essere definito attraverso immagini che ne mostrano abbigliamento e caratteristiche fisiche, mentre altri riferimenti possono descrivere prodotti, oggetti di scena oppure ambientazioni. Questa modalità è stata pensata per fornire ai creatori una forma di controllo più strutturata rispetto alla semplice descrizione testuale, soprattutto quando una produzione richiede di conservare la stessa identità visiva attraverso diverse generazioni.
ShengShu Technology ha inoltre lavorato sul coordinamento tra regia virtuale e azione rappresentata. Il modello è progettato per mantenere una relazione più coerente tra movimento della telecamera, cambi di inquadratura e comportamento dei soggetti, compresi scenari caratterizzati da spostamenti rapidi come inseguimenti e combattimenti. La generazione di effetti visivi, tra cui esplosioni, fuochi d’artificio e particelle, è stata modificata per migliorarne l’integrazione con l’ambiente e l’illuminazione della scena. L’obiettivo consiste nel ridurre le discontinuità che possono emergere quando elementi generati separatamente devono apparire come parte di una stessa ripresa. Le modalità 2K e 4K si accompagnano a miglioramenti relativi alla resa luminosa e all’estetica complessiva, mentre le risoluzioni inferiori rimangono disponibili per le fasi preliminari di sperimentazione. La piattaforma supporta infatti output a 540p, 720p, 1080p, 2K e 4K, permettendo di utilizzare formati meno onerosi durante la valutazione di una scena e di scegliere una risoluzione superiore quando il risultato è pronto per una produzione più rifinita.
Le modalità operative comprendono Image-to-Video e Reference-to-Video. La prima utilizza una singola immagine iniziale, associata a un prompt testuale, per produrre una sequenza animata della durata compresa tra tre e sedici secondi. La seconda permette invece di combinare da una a quindici immagini di riferimento e da zero a tre riferimenti audio, con video di durata compresa tra uno e sedici secondi. In entrambi i casi, la piattaforma mira a preservare il rapporto d’aspetto del materiale fornito, evitando modifiche arbitrarie del formato durante la generazione. L’API destinata alla modalità Image-to-Video rende disponibile il modello con l’identificativo viduq4-preview attraverso l’endpoint POST https://api.vidu.com/ent/v2/img2video. La richiesta accetta un’immagine iniziale nei formati PNG, JPEG, JPG o WebP, con dimensione massima di 50 MB, e una descrizione testuale fino a 20.000 caratteri. La durata predefinita è di cinque secondi, mentre la risoluzione standard è 720p; entrambi i parametri possono essere modificati nei limiti previsti dal servizio. Un parametro audio, attivo per impostazione predefinita, consente di generare filmati sonori comprendenti dialoghi ed effetti, sfruttando le capacità di sincronizzazione audiovisiva e commutazione automatica delle inquadrature.
ShengShu Technology ha accompagnato il lancio con una revisione della struttura economica, dichiarando che, a parità di specifiche di output e condizioni di fatturazione comparabili, Q4 Preview può permettere di produrre fino a cinque volte la quantità di video ottenibile con il medesimo budget. Il miglioramento è stato collegato soprattutto alla necessità di effettuare numerose iterazioni prima di ottenere una sequenza utilizzabile. La realizzazione di una scena può infatti richiedere varianti della recitazione, della disposizione dei soggetti, dell’apertura narrativa o dei movimenti della telecamera, e il costo di ciascuna generazione incide direttamente sul numero di alternative che il gruppo creativo può esaminare. I principali ambiti applicativi individuati comprendono produzione pubblicitaria, commercio elettronico, contenuti per i social network, serie audiovisive e sperimentazione cinematografica. I team pubblicitari possono confrontare differenti impostazioni di uno spot, mentre le attività di e-commerce possono produrre versioni adattate a prodotti e pubblici differenti; nelle produzioni narrative, invece, il sistema può essere utilizzato per verificare interpretazioni, storyboard e ritmo delle sequenze prima di avviare fasi più costose di realizzazione. Il modello rimane distribuito come preview, pertanto disponibilità delle funzioni, risoluzioni supportate, prezzi definitivi e condizioni d’uso possono variare secondo il piano sottoscritto e l’area geografica.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)