
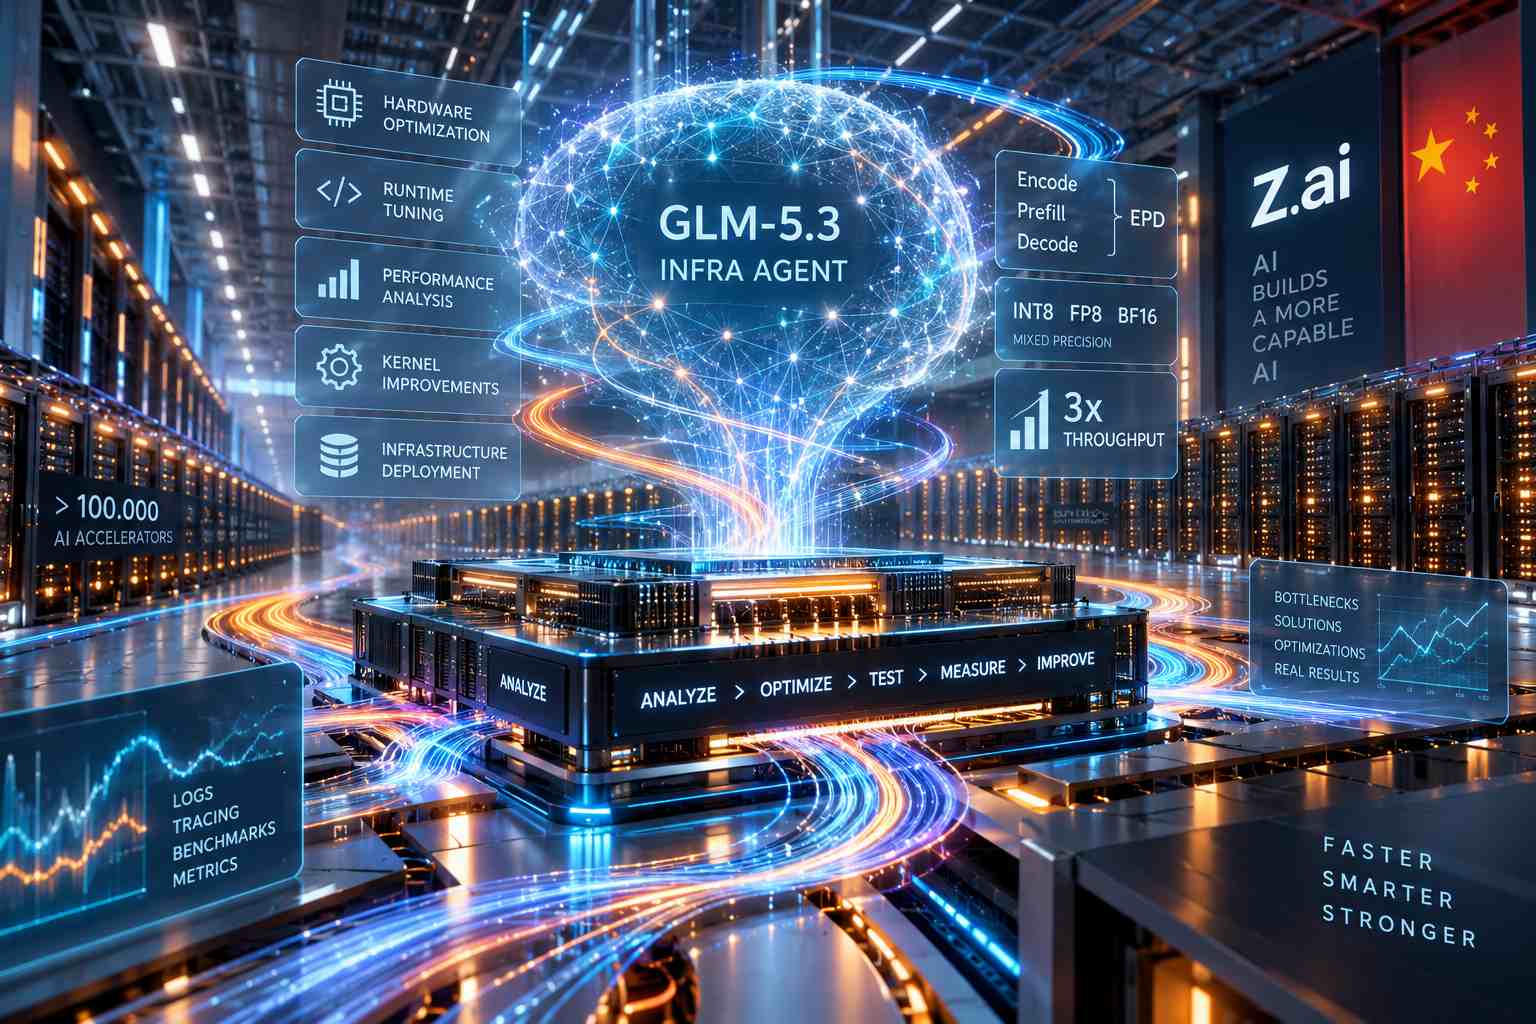
Z.ai ha utilizzato GLM per costruire e ottimizzare direttamente l’infrastruttura necessaria all’esecuzione dei propri modelli, estendendo l’impiego dell’intelligenza artificiale oltre la semplice generazione di codice applicativo e portandolo fino al livello dei sistemi che gestiscono hardware, runtime e prestazioni dell’inferenza. La società ha impiegato un Infra Agent basato su GLM-5.3 per realizzare il sistema destinato a eseguire GLM-5.3-Flash su un cluster composto da oltre 100.000 acceleratori AI di produzione cinese. Il contesto presentava difficoltà particolari, legate sia alle restrizioni statunitensi sui semiconduttori sia alla minore maturità dell’ecosistema software e della documentazione disponibile per questi acceleratori. L’agente è stato quindi utilizzato non soltanto per scrivere o modificare codice, ma anche per analizzare l’infrastruttura esistente, misurare le prestazioni, individuare le cause dei colli di bottiglia, formulare ipotesi di ottimizzazione e verificarle direttamente. Secondo Z.ai, il sistema ha permesso di portare GLM-5.3-Flash in produzione in meno di due settimane e di aumentare di circa tre volte il throughput complessivo rispetto alle prime esecuzioni funzionanti.
Z.ai considera particolarmente rilevante il fatto che il modello sia intervenuto su un ambito tradizionalmente affidato a ingegneri specializzati nell’infrastruttura, ripetendo autonomamente un ciclo composto da analisi del sistema, modifica del codice, esecuzione di test e misurazione dei risultati. La società descrive questo meccanismo come un circuito nel quale il modello ottimizza il sistema che, a sua volta, viene utilizzato per eseguire lo stesso modello. Non si tratta ancora di RSI recursive self-improvement in senso stretto, perché la definizione degli obiettivi, la valutazione dei rischi e le decisioni finali rimangono affidate agli esseri umani, ma il processo può essere considerato una forma embrionale di RSI: il modello contribuisce infatti a migliorare direttamente l’infrastruttura da cui dipendono le proprie prestazioni, creando un primo ciclo di miglioramento ricorsivo. Il caso non equivale quindi all’autoprogettazione o all’autoaddestramento autonomo di una generazione successiva del modello, ma mostra già come attività infrastrutturali che in precedenza avrebbero richiesto settimane di lavoro specializzato possano essere automatizzate, misurate e iterate in tempi molto più brevi.
Una componente centrale del processo è stata la struttura definita da Z.ai come Dense Feedback, progettata per collegare in un unico ciclo operativo test dei kernel, log del runtime, tracing delle esecuzioni, microbenchmark e misurazioni delle prestazioni dell’intero servizio. In questo modo l’agente poteva restringere progressivamente il campo di analisi fino a identificare il componente responsabile di un problema, modificare una parte limitata del sistema e verificare immediatamente il risultato senza dover ridistribuire ogni volta l’intera infrastruttura. Questo approccio ha consentito di intervenire anche su problemi molto specifici. Durante il controllo di un kernel KDA, per esempio, il sistema ha rilevato che l’operazione tl.dot utilizzava di default calcoli TF32 anche in presenza di input FP32, con un accumulo dell’errore che diventava significativo nelle elaborazioni con contesti lunghi; la precisione delle operazioni è stata quindi corretta. In un altro caso, durante il trasferimento della KV cache, alcune funzioni C++ non rilasciavano il Global Interpreter Lock di Python, introducendo latenze che determinavano una differenza prestazionale nell’ordine del 20%. La modifica del comportamento di queste funzioni ha ridotto tale divario a meno dell’1%.
L’Infra Agent ha inoltre analizzato progetti open source dedicati all’ottimizzazione delle prestazioni, tra cui SGLang, Flash Linear Attention e DeepGEMM, individuando schemi ricorrenti e trasformandoli in strutture di ottimizzazione riutilizzabili. A questi interventi si sono aggiunte tecniche più ampie di progettazione dell’infrastruttura, compresa la separazione delle fasi di encode, prefill e decode attraverso un’architettura EPD e l’uso di quantizzazione a precisione mista della cache con formati INT8, FP8 e BF16. Nel kernel di decodifica KDA, la rimozione di operazioni ridondanti ha prodotto un incremento della velocità pari a 1,71 volte. La combinazione dei diversi interventi ha portato il sistema di inferenza di GLM-5.3-Flash a raggiungere un throughput circa triplo rispetto alla configurazione iniziale. Poco dopo essere stato reso disponibile con il nome anonimo Ox-Alpha, il modello è diventato nell’arco di una settimana uno dei più utilizzati sulle principali piattaforme considerate da Z.ai, elaborando oltre 62.000 miliardi di token in sei giorni.
Z.ai considera particolarmente rilevante il fatto che il modello sia intervenuto su un ambito tradizionalmente affidato a ingegneri specializzati nell’infrastruttura, ripetendo autonomamente un ciclo composto da analisi del sistema, modifica del codice, esecuzione di test e misurazione dei risultati. La società descrive questo meccanismo come un circuito nel quale il modello ottimizza il sistema che, a sua volta, viene utilizzato per eseguire lo stesso modello. Non viene tuttavia presentato come un esempio completo di recursive self-improvement, perché la definizione degli obiettivi, la valutazione dei rischi e le decisioni finali rimangono affidate agli esseri umani. Il caso viene piuttosto indicato come una prima forma di coinvolgimento diretto dell’AI nel miglioramento della propria infrastruttura di esecuzione: un passaggio diverso dall’autoprogettazione o dall’autoaddestramento di un modello successivo, ma già sufficiente a mostrare come attività infrastrutturali che in precedenza avrebbero richiesto settimane di lavoro specializzato possano essere automatizzate e iterate in tempi molto più brevi.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)