
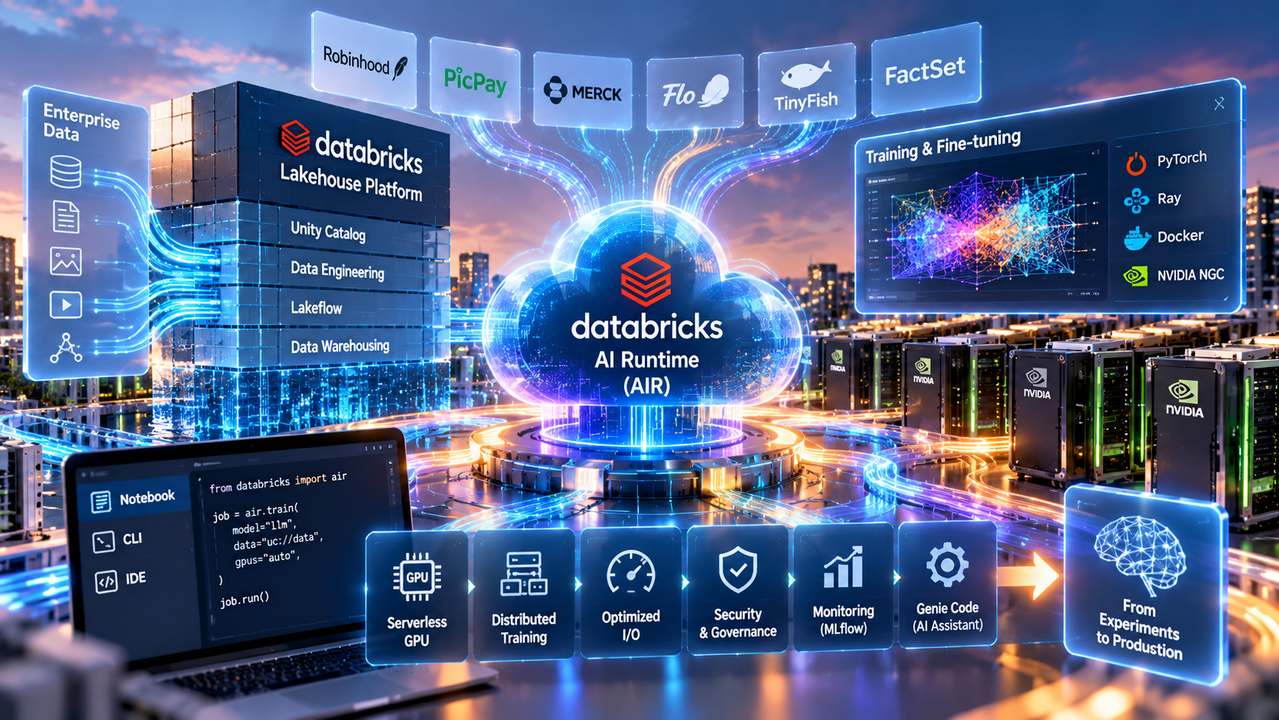
Databricks ha annunciato a disponibilità generale di AI Runtime, denominato AIR, un ambiente GPU completamente gestito e serverless integrato nella piattaforma Databricks Lakehouse per l’addestramento e il fine-tuning di modelli di deep learning sui dati aziendali. L’architettura elimina per gli sviluppatori la necessità di acquistare o gestire direttamente risorse GPU, configurare cluster di calcolo e amministrare le relative reti, consentendo di avviare gli esperimenti mediante interfaccia a riga di comando, notebook o ambienti IDE. Databricks dichiara che centinaia di aziende, tra cui Robinhood, PicPay, Merck, Flo Health, TinyFish e FactSet, utilizzano già AIR per realizzare modelli destinati alla produzione. Anche il gruppo interno Databricks AI Research impiega la piattaforma per addestrare modelli alla base di KARL e AI Parse. Secondo i dati comunicati, l’infrastruttura è stata impiegata in esecuzioni di addestramento per oltre 100.000 ore GPU. Il servizio include controlli di integrità dell’hardware e della rete, con verifiche prima dell’allocazione delle GPU, monitoraggio durante le elaborazioni e analisi periodiche dei nodi inattivi per individuare dispositivi non funzionanti.
AIR supporta l’addestramento distribuito su più GPU e nodi, utilizzando reti RDMA gestite, checkpoint ottimizzati e container Docker personalizzati, compresi quelli NVIDIA NGC. I sistemi di caricamento integrati trasferiscono e memorizzano temporaneamente i dati per ridurre i tempi di attesa dovuti alle operazioni di input/output, mentre UCVolumeDataset permette di aumentare il throughput senza realizzare pipeline di caricamento dedicate. L’integrazione con Lakeflow collega gli incarichi GPU ai processi di preparazione e trasformazione dei dati, consentendo di coordinare le dipendenze fra addestramento e altri workflow. Sono previsti controlli di priorità e pre-emption per gestire l’utilizzo delle risorse e strumenti come AIR Skills per agevolare la migrazione di carichi provenienti da Kubernetes o cluster SLURM mediante istruzioni in linguaggio naturale. L’avvio dei processi è accelerato attraverso pool GPU serverless già disponibili e caricamento progressivo delle immagini dei container, mentre il riutilizzo delle configurazioni memorizzate evita preparazioni ripetitive degli ambienti. In un caso comunicato da Superhuman, il passaggio da un nodo con otto GPU A100 a un sistema multinodo con 16 GPU H100 ha ridotto il tempo di addestramento da circa sette giorni a 48 ore, corrispondente a un’accelerazione di 3,5 volte per il carico specifico.
Le attività possono essere monitorate attraverso l’integrazione con MLflow, che rende disponibili i log pochi secondi dopo l’avvio e include una visualizzazione dedicata ai processi distribuiti. Genie Code fornisce strumenti agentici per diagnosticare errori e ottimizzare le prestazioni, utilizzando competenze operative maturate dai gruppi di ricerca Databricks. La piattaforma supporta framework come PyTorch e Ray e consente di portare in produzione i carichi di addestramento attraverso configurazioni YAML. Sul piano della sicurezza, AIR opera all’interno dei controlli di Databricks e Unity Catalog, applicando autorizzazioni coerenti a dati, checkpoint e registrazioni. L’isolamento avviene a livello di macchina virtuale e sono supportati PrivateLink e controlli di uscita dalla rete per gli ambienti serverless. L’utilizzo delle GPU e i relativi costi vengono registrati nelle tabelle di fatturazione Databricks, consentendo di attribuire il consumo alle singole attività. Fra gli altri utilizzatori citati figurano Sonar, che impiega AIR per sperimentare pipeline di addestramento di modelli linguistici, FactSet, che ha ridotto da giorni a ore la configurazione e distribuzione di un modello Text To Formula, e QuantHealth, che utilizza l’addestramento distribuito su milioni di record all’interno dei propri workflow di dati.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)