
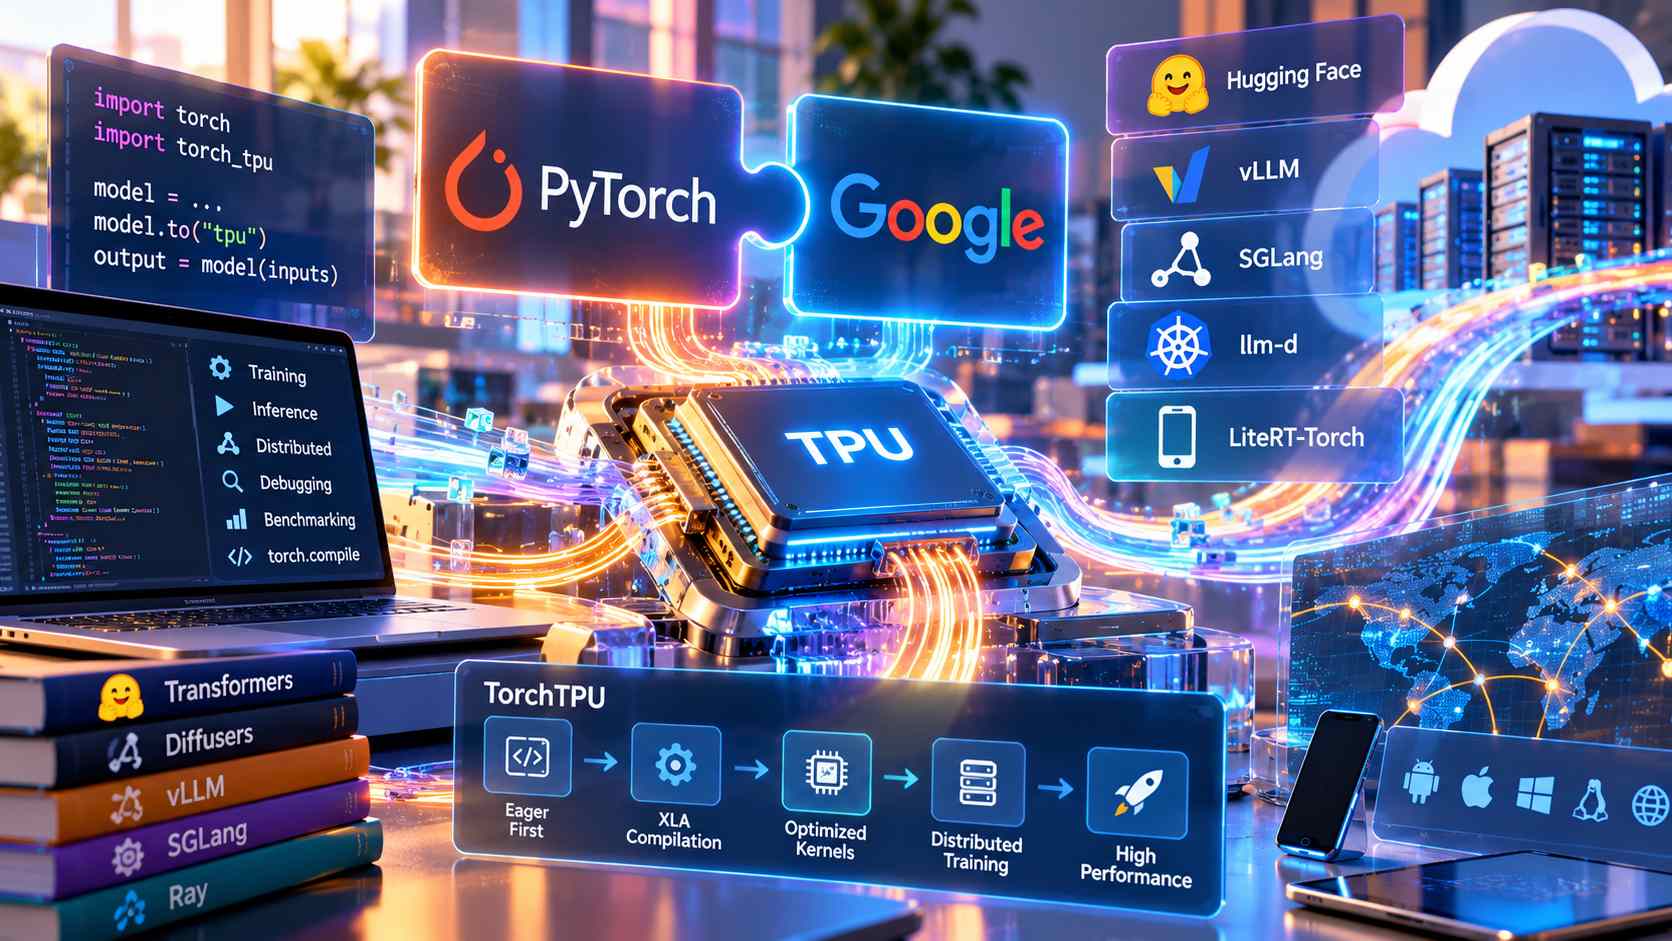
Google ha annunciato, durante PyTorch Conference 2026, la disponibilità open source di TorchTPU, uno stack software sviluppato insieme al gruppo PyTorch di Meta per eseguire direttamente sulle Tensor Processing Unit i carichi di lavoro costruiti con il framework PyTorch. Il progetto punta a ridurre le modifiche necessarie per trasferire modelli, applicazioni di inferenza e pipeline di addestramento dalle infrastrutture GPU alle TPU Google, mantenendo le API e gli strumenti comunemente utilizzati dagli sviluppatori. TorchTPU era stato presentato pubblicamente nell’aprile 2026 come architettura Eager First basata sull’interfaccia PrivateUse1 di PyTorch, progettata per consentire l’integrazione di backend hardware esterni. La nuova distribuzione include il repository pubblico google-pytorch/torch_tpu su GitHub con licenza Apache 2.0, kernel ATen specializzati, cache di compilazione XLA, supporto all’addestramento distribuito, strumenti di debugging e benchmarking, esempi applicativi e integrazione con torch.compile. Il pacchetto torch-tpu 0.2.0 è stato pubblicato su PyPI il 19 ottobre, con distribuzioni Linux x86-64 per Python dalla versione 3.11 alla 3.14.
Il funzionamento di TorchTPU combina modalità di esecuzione eager e compilazione dei grafi computazionali. Le modalità Debug, Strict e Fused Eager utilizzano una cache condivisa delle compilazioni per ridurre la duplicazione del lavoro e permettere differenti compromessi tra osservabilità, compatibilità e prestazioni. Google aveva precedentemente indicato miglioramenti dal 50% a oltre il 100% per Fused Eager rispetto a Strict Eager, valori riferiti ai confronti presentati dall’azienda e non necessariamente generalizzabili a tutti i modelli. Quando viene utilizzato torch.compile, Torch Dynamo cattura i grafi FX che vengono successivamente trasformati attraverso XLA e StableHLO, mentre i kernel specializzati possono essere sviluppati mediante Pallas e JAX. L’implementazione comprende supporto a Distributed Data Parallel, FSDPv2 e DTensor, così da coprire attività di addestramento distribuito, parallelismo dei dati e dei tensori e configurazioni caratterizzate da percorsi di esecuzione differenti tra acceleratori.
L’integrazione con Hugging Face costituisce uno degli elementi principali dell’apertura dell’ecosistema. Google ha collaborato con Hugging Face per consentire l’esecuzione nativa dei modelli a pesi aperti presenti nell’Hub attraverso TorchTPU. Con Transformers v5 è possibile indicare direttamente la TPU come dispositivo di destinazione utilizzando il parametro device_map=”tpu”, mentre Diffusers supporta eager mode, torch.compile e parallelismo tensoriale su più acceleratori. Google ha inoltre realizzato pipeline CI/CD dedicate alla verifica notturna della compatibilità della suite Transformers con l’infrastruttura TPU. Sul versante dell’inferenza, TorchTPU comprende un backend PyTorch nativo per vLLM, sviluppato insieme a Inferact, con supporto a continuous batching, quantizzazione e parallelismo multi-chip attraverso kernel Pallas personalizzati. L’obiettivo è conservare i modelli di worker, gli scheduler e gli API server di vLLM, evitando di richiedere modifiche all’infrastruttura applicativa già costruita attorno al motore di serving.
Un’ulteriore integrazione riguarda SGLang, sviluppata insieme a RadixArk per applicazioni con output strutturati e sistemi agentici. Il backend utilizza RadixAttention per riutilizzare la cache key/value fra richieste che condividono prefissi di prompt, limitando i calcoli ripetuti, e comprende un sistema di trasferimento disaggregato utilizzabile anche come backend I/O per HiCache. A livello di orchestrazione Google ha presentato llm-d 1.0, progetto sviluppato con Red Hat, IBM e una comunità di oltre 500 contributori appartenenti a 25 organizzazioni, distribuito come progetto Sandbox della Cloud Native Computing Foundation. L’architettura collega i motori di inferenza PyTorch agli ambienti Kubernetes mediante un router consapevole della cache dei prefissi, capace di indirizzare le richieste verso le repliche che possiedono già il contesto necessario, e separa la fase di prefill, caratterizzata da un maggiore carico computazionale, dalla fase di decode, maggiormente vincolata alla memoria. Secondo i risultati comunicati da Zenteiq, l’impiego di GKE Inference Gateway con llm-d ha incrementato di oltre quattro volte il throughput aggregato di generazione di dati sintetici, passando da 1,47 a 5,97 miliardi di token giornalieri per mille acceleratori TPU v6e.
Per l’addestramento su larga scala, TorchTPU viene integrato in TorchTitan mediante torch.compile, SimpleFSDP, kernel Pallas e ottimizzazioni a livello di grafo. Le ricette distribuite comprendono modelli densi quali Llama 3 da 70 e 405 miliardi di parametri, Qwen 3 da 8 e 32 miliardi, MuseGlimmer 30B, oltre al modello mixture-of-experts Qwen 3 235B e al diffusion transformer FLUX.1 12B. Google dichiara di aver verificato l’integrazione su configurazioni fino a 8.000 TPU Ironwood, mentre i test di scalabilità arrivano fino a 8.192 acceleratori TPU v7x. Su Qwen 3 8B è stata riportata una Model FLOPs Utilization fino al 52%, con una crescita delle prestazioni prossima alla linearità nelle configurazioni distribuite considerate. Anche VeRL, framework per il reinforcement learning, riceve un backend TPU e una ricetta GRPO basata sulla separazione tra trainer e sampler, mentre Ray introduce supporto nativo per coordinare elaborazione dei dati, training, reinforcement learning e serving attraverso CPU, GPU e TPU all’interno dello stesso workflow.
L’annuncio comprende infine LiteRT-Torch, libreria che permette di convertire modelli PyTorch per l’esecuzione attraverso LiteRT, già conosciuto come TensorFlow Lite, mediante una singola chiamata a litert-torch.convert(). I modelli convertiti possono essere distribuiti su Android, iOS, macOS, Windows, Linux, dispositivi IoT e web, collegando così lo sviluppo su acceleratori cloud alle esigenze di inferenza locale. Google ha pubblicato anche una suite sperimentale di agenti TPU destinati ad automatizzare configurazione iniziale, diagnostica e ottimizzazione delle prestazioni di inferenza. La disponibilità del codice, della documentazione e dei pacchetti software rende TorchTPU accessibile agli sviluppatori, pur richiedendo per l’esecuzione effettiva un ambiente dotato di TPU, come le macchine virtuali Google Cloud con acceleratori v6e.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)