
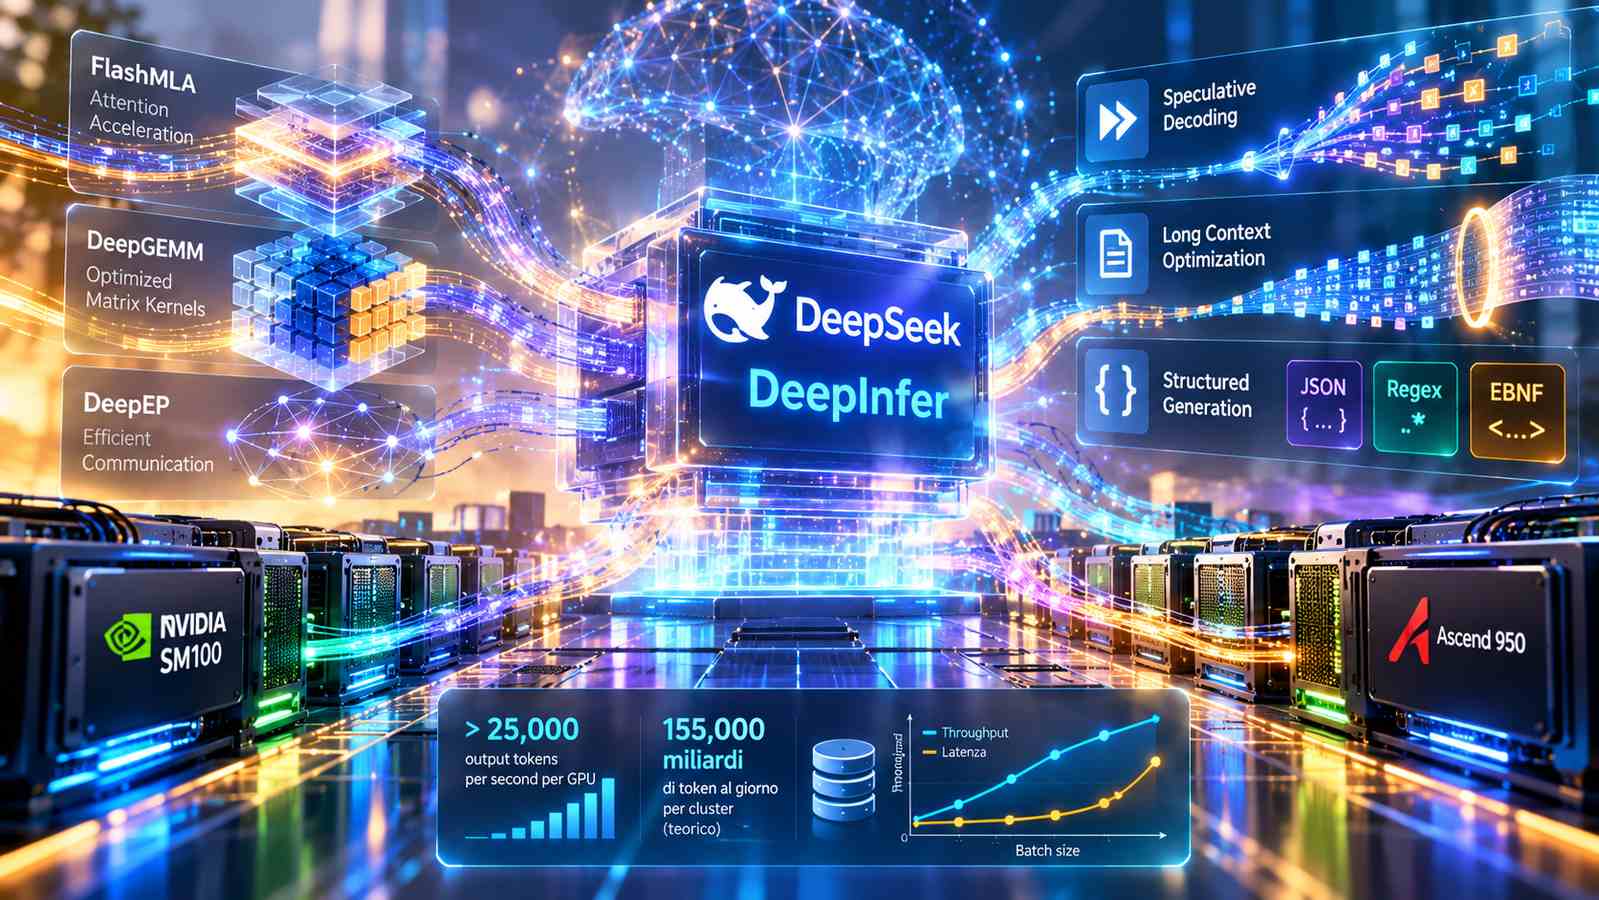
DeepSeek ha pubblicato DeepInfer, un framework open source per l’esecuzione di modelli di intelligenza artificiale progettato per aumentare il throughput delle operazioni di inferenza e migliorare l’utilizzo delle risorse di calcolo. Il progetto, distribuito su GitHub con licenza Apache 2.0, rende disponibili componenti tecnologici utilizzati nell’ottimizzazione dell’esecuzione dei modelli DeepSeek, compreso DeepSeek-V4.1-Flash. La versione iniziale supporta GPU NVIDIA SM100 e acceleratori Huawei Ascend 950, con un’architettura che combina kernel specializzati, gestione delle operazioni distribuite e tecniche di generazione ottimizzata dei token. Il framework è rivolto agli sviluppatori e alle organizzazioni che desiderano eseguire autonomamente modelli linguistici su infrastrutture di calcolo specializzate, riducendo il costo computazionale delle operazioni. Il codice pubblicato costituisce tuttavia un motore per l’inferenza offline e non comprende ancora tutti i componenti normalmente richiesti da un servizio di produzione esposto agli utenti.
La versione distribuita non include infatti un sistema completo di gestione della cache key/value tra le richieste, la separazione operativa tra prefill e decode all’interno di un servizio distribuito né i componenti di bilanciamento del carico. Per realizzare un ambiente di serving destinato a ricevere e processare richieste in tempo reale è quindi necessario integrare ulteriori servizi infrastrutturali. La distinzione è rilevante perché le prestazioni di un motore di inferenza misurate in condizioni controllate non coincidono automaticamente con quelle osservabili attraverso un’API pubblica. Un servizio completo deve gestire ricezione delle richieste, tokenizzazione, code, allocazione delle risorse, recupero delle informazioni dalla cache e comunicazioni di rete, oltre al tempo effettivamente impiegato dal modello per elaborare i token. DeepInfer fornisce principalmente le componenti ottimizzate del percorso computazionale, lasciando agli utilizzatori la progettazione e l’integrazione di parte dell’infrastruttura operativa.
DeepSeek ha pubblicato benchmark separati per le fasi di prefill e decode. La prima comprende l’elaborazione dei token iniziali del prompt e la preparazione dello stato utilizzato durante la generazione, mentre la seconda consiste nella produzione progressiva dei token di risposta. Le misurazioni sono state effettuate utilizzando quattro GPU per il prefill e 64 GPU per il decode. Nei test di generazione, con 256 richieste contemporanee per rank, DeepInfer ha raggiunto un throughput dichiarato superiore a 25.000 token di output al secondo per GPU. L’azienda ha inoltre indicato una capacità teorica di elaborazione pari a 155.000 miliardi di token al giorno per un singolo cluster. Questi valori derivano da misurazioni interne e non rappresentano un confronto indipendente con altri framework di inferenza sottoposti alle stesse condizioni sperimentali. La capacità effettiva di un’installazione dipende dall’architettura hardware, dalla configurazione dei modelli e dai requisiti di latenza imposti dal servizio.
Le prove mostrano anche il compromesso tra dimensione dei batch, throughput e tempo di attesa. Aumentando la quantità di lavoro elaborata simultaneamente da 4.096 a 65.536 unità, il throughput nella fase di prefill è cresciuto da circa 60.000 a 89.000 token al secondo per GPU. Nello stesso esperimento la latenza è però aumentata da 70 a 730 millisecondi. Il miglioramento della quantità complessiva di lavoro processato non comporta quindi necessariamente una riduzione del tempo percepito dall’utente: oltre determinate dimensioni, batch più ampi permettono di utilizzare efficientemente gli acceleratori ma introducono attese maggiori. I dati si riferiscono specificamente alla fase misurata e non comprendono necessariamente tutto il percorso di una richiesta, dall’arrivo al sistema fino alla disponibilità del primo token della risposta. Le scelte di dimensionamento devono pertanto considerare separatamente throughput aggregato e latenza del servizio.
L’architettura di DeepInfer integra diverse tecnologie di ottimizzazione già sviluppate nell’ecosistema DeepSeek. FlashMLA è utilizzato per accelerare le operazioni di attention, DeepGEMM fornisce kernel dedicati alle moltiplicazioni matriciali, mentre DeepEP gestisce comunicazioni efficienti tra acceleratori, particolarmente importanti per i modelli mixture-of-experts. In questi modelli soltanto alcuni esperti vengono attivati per ciascun token e le operazioni devono essere distribuite tra differenti dispositivi. Il framework cerca di ridurre i tempi non produttivi sovrapponendo attività di scheduling sulla CPU ed esecuzione sulla GPU, così da evitare che la gestione dei compiti interrompa inutilmente l’attività degli acceleratori. Queste tecniche vengono combinate con procedure specifiche per ottimizzare le operazioni di inferenza a elevata concorrenza.
Un’altra componente riguarda lo speculative decoding, nel quale un modello ausiliario produce anticipatamente candidati per i token successivi e il modello principale li verifica, con l’obiettivo di accelerare la generazione senza alterare i criteri di accettazione dei risultati. DeepInfer introduce una gestione dinamica della verifica che considera la probabilità di accettazione dei token proposti. Il vantaggio dipende dal comportamento del modello, dal numero di richieste concorrenti e dalla configurazione dell’infrastruttura. Per i contesti lunghi viene utilizzata inoltre una tecnica che ricostruisce parte dello stato necessario a partire dai 128 token più recenti della sliding-window attention, riducendo il lavoro richiesto durante alcune operazioni di prefill. Il framework supporta anche la generazione vincolata mediante espressioni regolari, schemi JSON e grammatiche EBNF, strumenti utili quando il risultato del modello deve rispettare una struttura sintattica definita prima dell’esecuzione.
La pubblicazione del progetto permette a sviluppatori e imprese di ispezionare, modificare e integrare direttamente il codice nelle proprie infrastrutture, rispettando le condizioni della licenza Apache 2.0. DeepSeek presenta l’iniziativa come un contributo alla riduzione dei costi computazionali ed energetici dell’inferenza, attraverso la condivisione di tecnologie di ottimizzazione già impiegate per i propri modelli. Il rilascio riguarda però una versione non ancora completa dal punto di vista delle funzionalità di serving, e i risultati prestazionali comunicati devono essere interpretati in relazione all’hardware e ai benchmark utilizzati. DeepInfer mette a disposizione componenti specifici per l’esecuzione efficiente dei modelli, mentre la realizzazione di un’infrastruttura multiutente affidabile richiede ulteriori sistemi per gestione delle richieste, distribuzione dei carichi e controllo operativo.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)