
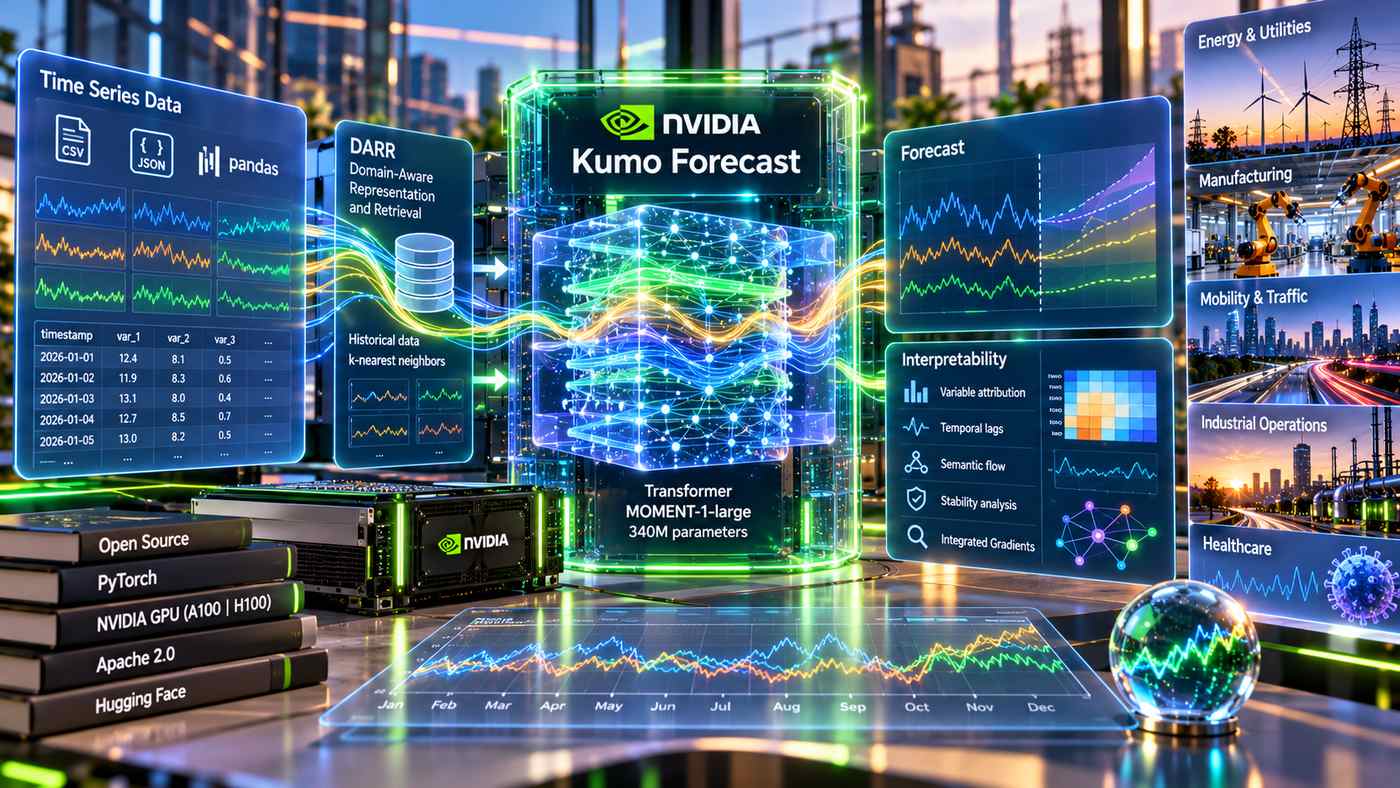
NVIDIA ha presentato Kumo Forecast, un modello aperto per la previsione di serie temporali multivariate che combina un’architettura Transformer preaddestrata, un sistema opzionale di recupero di informazioni storiche e strumenti per interpretare i risultati prodotti. Precedentemente denominato NV-Tesseract Forecasting, il modello viene distribuito con licenza Apache 2.0 attraverso la libreria NVIDIA/Kumo-TS su GitHub, mentre i pesi preaddestrati sono disponibili su Hugging Face. La scheda del modello riporta una prima pubblicazione dei pesi il 7 aprile 2026. L’architettura utilizza MOMENT-1-large, un encoder Transformer con circa 340 milioni di parametri, mantenendo congelati i pesi dell’encoder e del componente di embedding durante l’addestramento della testa di previsione. Questa separazione permette di utilizzare rappresentazioni temporali già apprese, adattando il livello finale alla produzione dei valori futuri richiesti. Il sistema accetta dati numerici organizzati per timestamp e una o più variabili, attraverso DataFrame pandas oppure file CSV e JSON, supportando finestre di ingresso da 256, 512, 1.024 e 2.048 osservazioni. Le previsioni sono restituite come DataFrame con date e valori stimati, mentre per orizzonti superiori a quelli gestiti direttamente è prevista un’estensione autoregressiva che produce nuove stime utilizzando ricorsivamente le precedenti.
Una componente specifica del modello è Domain-Aware Representation and Retrieval, denominata DARR, che combina la previsione diretta con il recupero dei vicini più simili da una raccolta separata di dati storici. Il parametro context_df permette di fornire al sistema un archivio temporale supplementare rispetto alla finestra recente da prevedere, mentre i parametri configurabili stabiliscono il peso relativo della previsione ottenuta dal modello e delle informazioni recuperate. Nell’esempio pubblicato nella libreria NVIDIA, il parametro alpha è fissato a 0,2, corrispondente al 20% di contributo della previsione diretta e all’80% della componente k-nearest neighbors, con 64 vicini e temperatura pari a 0,05. NVIDIA precisa che le dimensioni del contesto utilizzato per il recupero devono essere compatibili con quelle delle sequenze di ingresso. Kumo Forecast include inoltre un sistema di interpretabilità indipendente dall’architettura del previsore, capace di produrre attribuzioni relative alle variabili e ai ritardi temporali, analisi del flusso semantico, verifiche della stabilità delle traiettorie e, facoltativamente, Integrated Gradients sulle rappresentazioni vettoriali. L’attivazione della modalità interpretability genera risultati in JSON e CSV e un rapporto PDF, senza richiedere modifiche interne al modello.
L’addestramento documentato comprende circa tre milioni di punti dati e utilizza un’impostazione di suddivisione 80/20 per i dataset, a partire dal Monash Time Series Forecasting Archive, che raccoglie 30 dataset principali. Le valutazioni riportate comprendono ECL, con consumi elettrici di 370 clienti rilevati ogni 15 minuti tra il 2011 e il 2014, Traffic, relativo all’occupazione delle strade nell’area della baia di San Francisco, ETTh, che raccoglie temperatura dell’olio dei trasformatori e variabili di carico elettrico, e ILI, contenente dati settimanali statunitensi sulle sindromi simil-influenzali. Il modello è basato su PyTorch, richiede Python 3.10 o successivo e PyTorch 2.7 o successivo ed è progettato per infrastrutture accelerate NVIDIA Ampere e Hopper, con prove di inferenza documentate su GPU A100 e H100. La libreria supporta anche un ripiego su CPU e fornisce esempi per il fine-tuning a partire da file CSV. NVIDIA raccomanda di confrontare le modalità diretta e DARR sugli stessi periodi di verifica e di valutare il comportamento sui diversi orizzonti previsionali. Kumo Forecast è inoltre integrato nell’iniziativa Factory Operations Blueprint, che prevede un modulo di manutenzione predittiva in accesso anticipato nel quale Kumo Anomaly e Kumo Forecast analizzano dati operativi in tempo reale e stimano l’insorgenza di anomalie future.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)