
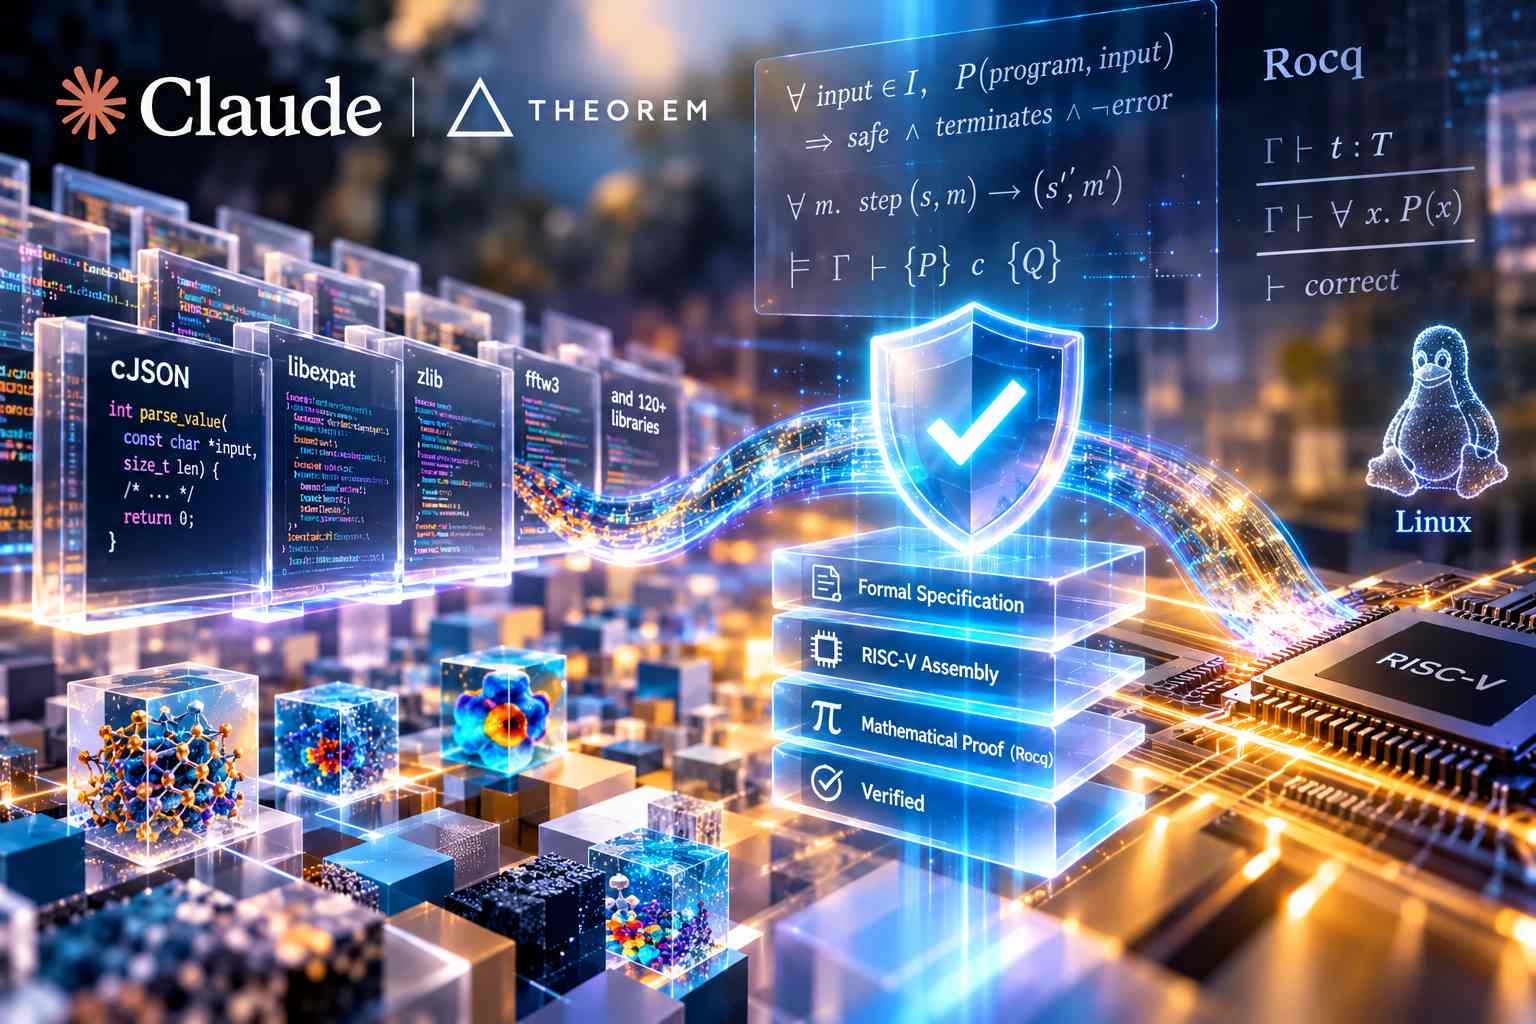
Anthropic ha presentato i risultati di una ricerca condotta in collaborazione con Theorem sull’impiego di Claude nella verifica formale della sicurezza del software. Il sistema ha prodotto dimostrazioni matematiche controllate automaticamente per 239 punti di ingresso di fuzz test appartenenti a 123 librerie open source, lavorando direttamente sul codice assembly RISC-V ottenuto dalla compilazione dei programmi. L’obiettivo della sperimentazione consisteva nel dimostrare, anziché verificare soltanto attraverso esecuzioni di prova, che determinati programmi non potessero provocare errori di accesso alla memoria, terminazioni anomale o violazioni delle condizioni specificate per nessuno degli input ammessi dal modello formale. Le dimostrazioni riguardano input inferiori a 64 MiB e considerano le possibili configurazioni di memoria e le risposte del sistema operativo Linux rappresentate nella specifica. Il modello di esecuzione prevede programmi binari statici a singolo thread, una quantità di memoria prestabilita e un processore compatibile con l’architettura RISC-V. Claude è stato inoltre autorizzato a correggere i difetti individuati prima di produrre le dimostrazioni, introducendo un collegamento diretto tra individuazione delle vulnerabilità, modifica del codice e verifica matematica del risultato.
L’architettura sviluppata trasforma i fuzz test compilabili già disponibili nei progetti software in specifiche formali che descrivono le proprietà da garantire per tutti gli input compresi nell’intervallo definito. Il codice viene analizzato a livello di istruzioni macchina, utilizzando la semantica formale dell’architettura RISC-V e dei processi Linux sviluppata da Theorem. Claude genera quindi le dimostrazioni nel linguaggio Rocq, sottoponendole a un verificatore indipendente che ne controlla la correttezza rispetto agli enunciati matematici. Il sistema riduce così la base di componenti da considerare affidabili alla semantica formale dell’hardware e del sistema operativo, agli enunciati dei teoremi e al verificatore Rocq. L’attività è stata applicata a progetti presenti nell’iniziativa OSS-Fuzz di Google, che utilizza test automatizzati e strumenti come AddressSanitizer per individuare accessi illegali alla memoria nei programmi C e C++. Le dimostrazioni coprono sia i binari con strumentazione AddressSanitizer sia quelli privi di strumentazione, richiedendo l’assenza di errori, interruzioni e comportamenti non modellati, oltre all’equivalenza delle tracce di lettura e scrittura, della terminazione e dello stato finale del file system. La dimensione del lavoro è particolarmente significativa: Claude ha generato complessivamente circa un miliardo di righe di codice Rocq, delle quali circa 180 milioni hanno superato il controllo formale. Una dimostrazione tipica comprende circa 600.000 righe per programmi con una lunghezza mediana di 18.000 istruzioni RISC-V. Per il parser cJSON, costituito da un punto di ingresso di 391 righe, sono state necessarie circa 630.000 righe di dimostrazione, mentre per fftw3, con 51.000 righe di codice collegate, ne sono state prodotte circa 480.000.
Durante i tentativi di dimostrazione Claude ha individuato centinaia di difetti, compresi problemi difficilmente rilevabili con il fuzzing tradizionale. Tra questi figurano un underflow di contatore in un decompressore, capace di provocare una scrittura fuori dai limiti della memoria soltanto con input di circa 20 MB e una particolare disposizione dei dati, e un accesso di lettura fuori dai limiti in un decoder di immagini che richiedeva input di 64 MB e oltre 2 GB di memoria. Sono stati inoltre identificati errori dipendenti da sequenze specifiche di chiamate su due handle dello stesso file e riscoperta la vulnerabilità CVE-2026-56132 nella libreria libexpat, associata a strutture di input profondamente annidate. Le verifiche hanno fatto emergere anche errori logici che non provocano necessariamente arresti del programma, tra cui l’applicazione incompleta di restrizioni sui file caricabili. Anthropic ha riferito di aver individuato in applicazioni critiche un problema rimasto inosservato per oltre dieci anni e, nell’analisi di un lettore PDF ampiamente utilizzato, un numero di vulnerabilità in una settimana paragonabile a quello normalmente segnalato nell’arco di un anno. Per impedire che il modello aggirasse la complessità delle verifiche modificando eccessivamente i programmi, il processo ha previsto penalizzazioni per le patch, controlli delle modifiche e incentivi a dimostrare quali input fossero effettivamente interessati dalle correzioni.
La ricerca comprende ulteriori esperimenti su architetture e linguaggi differenti. Claude ha formalizzato le specifiche del formato di compressione zlib descritto nella RFC 1950 e verificato direttamente una versione compilata per x86 dell’implementazione presente nel kernel Linux, utilizzando una semantica delle istruzioni x86 generata dal modello. Il lavoro è stato ripetuto su altre librerie diffuse, individuando errori marginali non sfruttabili. Anthropic ha inoltre riferito che la formalizzazione della semantica x86 ha consentito di identificare numerose inesattezze nella documentazione tecnica ufficiale e alcuni difetti hardware. Un esperimento separato ha riguardato la realizzazione in Rust di un interprete per un ampio sottoinsieme di Python, verificato attraverso lo strumento Verus rispetto a una semantica formale di CPython. Nei test empirici su 1,7 milioni di programmi Python generati casualmente, il comportamento è risultato identico a CPython nel 99,95% dei casi. Sette errori introdotti intenzionalmente hanno invalidato tutti le dimostrazioni formali, mentre cinque non erano stati individuati dai test casuali. Anthropic ha annunciato la pubblicazione di una parte delle dimostrazioni, delle specifiche e dei componenti di verifica, mantenendo riservati i materiali che potrebbero rivelare vulnerabilità non ancora corrette. I risultati costituiscono dimostrazioni matematiche rispetto a ipotesi di esecuzione esplicite, non una garanzia indiscriminata di assenza di ogni possibile vulnerabilità nelle applicazioni considerate.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)