
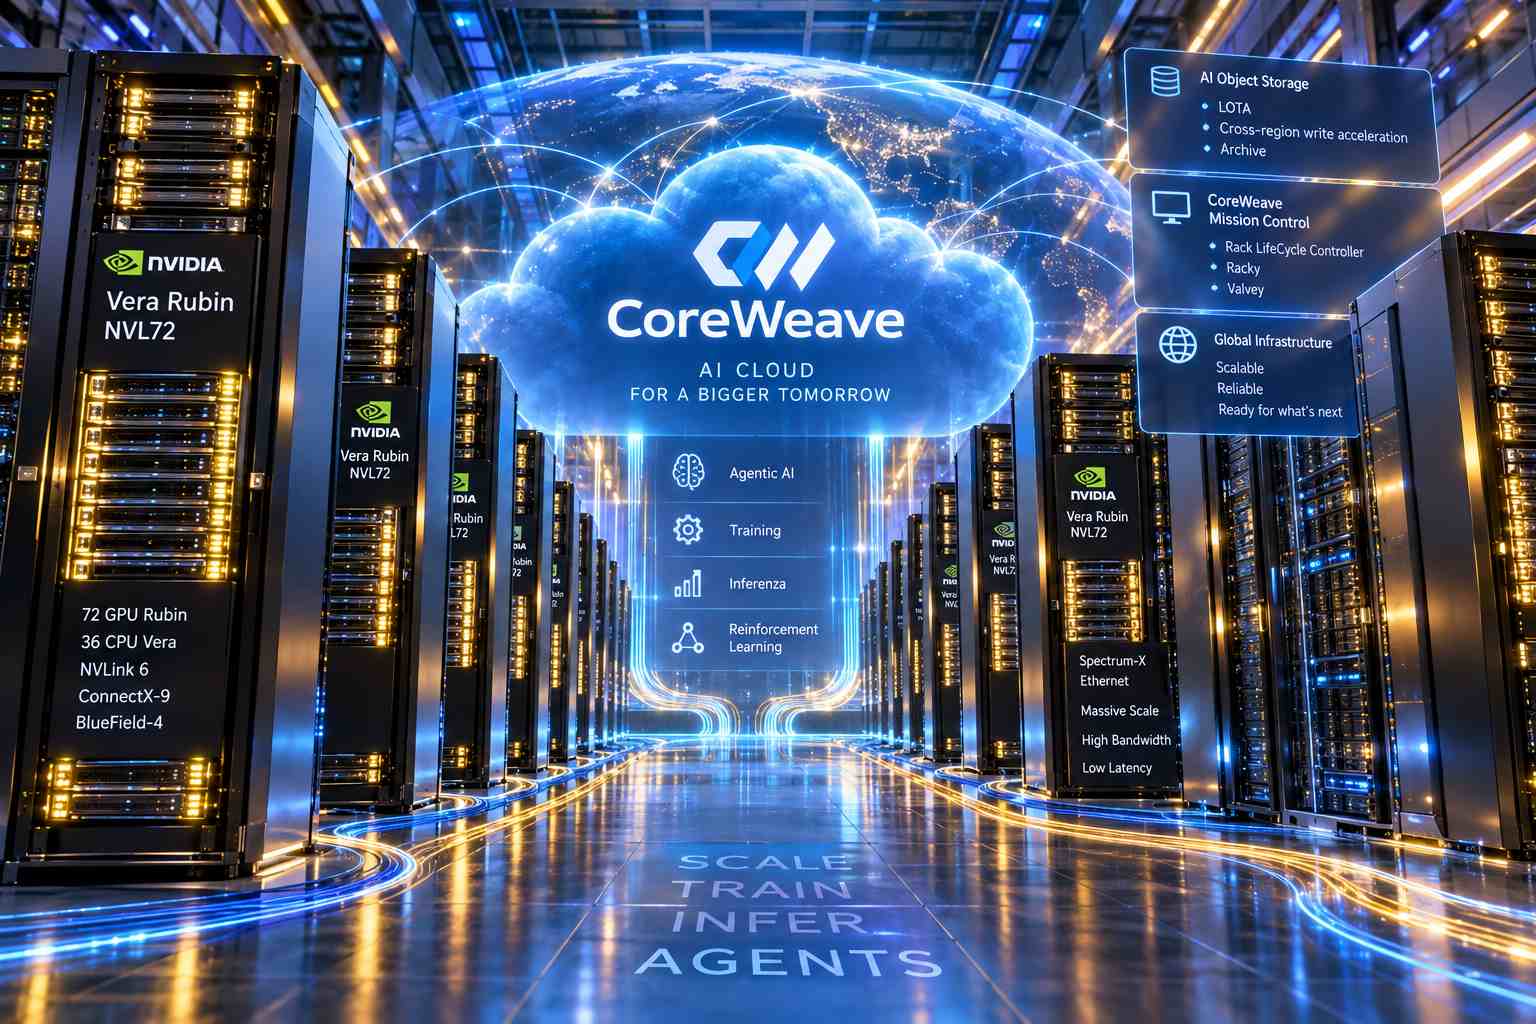
CoreWeave ha completato il bring-up di una configurazione multi-rack NVIDIA Vera Rubin NVL72 sul proprio cloud, collegando centinaia di GPU Rubin in un unico cluster scale-out destinato a carichi di lavoro di agentic AI, training, inferenza e reinforcement learning su larga scala. Un singolo rack Vera Rubin NVL72 combina 72 GPU Rubin con 36 CPU Vera, NVLink di sesta generazione, ConnectX-9 SuperNIC e DPU BlueField-4; nella configurazione multi-rack, più sistemi NVL72 vengono unificati attraverso la rete NVIDIA Spectrum-X Ethernet per operare come un’unica infrastruttura distribuita. CoreWeave presenta questa architettura come adatta ai workload agentici multi-step, nei quali la latenza di accesso ai dati può diventare particolarmente critica perché ogni ritardo tende ad accumularsi attraverso chiamate ripetute al modello, interazioni con strumenti e passaggi successivi di inferenza.
La gestione operativa del cluster è automatizzata attraverso CoreWeave Mission Control, che utilizza il Rack LifeCycle Controller per coordinare rilevamento dell’hardware, aggiornamenti firmware, validazione, alimentazione e raffreddamento. Il controllo a livello di rack viene gestito da Racky, mentre Valvey esegue le operazioni relative al sistema di raffreddamento. Prima di entrare in produzione, ogni rack viene sottoposto sia alla diagnostica NVIDIA sia a test di workload a pieno rack, e soltanto i sistemi che superano la validazione come unità completa vengono aggiunti all’ambiente operativo. Questa impostazione serve a trattare il rack non come una semplice raccolta di acceleratori indipendenti, ma come un singolo sistema validato prima della sua integrazione nel cluster più ampio.
Sul piano della rete, ogni GPU Rubin dispone di due ConnectX-9 SuperNIC che forniscono complessivamente 1,6 Tb/s di connettività scale-out per GPU attraverso percorsi multiplane e multirail. Secondo CoreWeave, la topologia supporta circa 128.000 GPU per rail all’interno di un fabric non-blocking e consente di aggiungere nuovi rack senza dover ridisegnare l’intera infrastruttura di rete a ogni espansione. Il multi-rack Vera Rubin NVL72 viene quindi costruito con l’obiettivo di mantenere elevate larghezza di banda e scalabilità anche quando il numero degli acceleratori cresce da decine a centinaia e, potenzialmente, a configurazioni molto più estese.
Alle novità sul compute CoreWeave ha affiancato due nuove funzioni per AI Object Storage. Il sistema utilizza LOTA, Local Object Transport Accelerator, che applica una cache gestita su ciascun nodo CoreWeave Kubernetes Service per avvicinare i dati ai workload; l’azienda dichiara velocità di lettura paragonabili a quelle degli NVMe locali, una riduzione della latenza fino a otto volte rispetto alla lettura da un cluster storage tradizionale e un throughput fino a 7 GB/s per GPU, con crescita lineare al crescere del cluster. Questo meccanismo è progettato per evitare che il sottosistema di storage diventi un collo di bottiglia proprio quando il numero di GPU e la quantità di dati elaborati aumentano.
La prima nuova funzione è la cross-region write acceleration, che permette di scrivere checkpoint localmente all’interno della regione in cui viene eseguito il workload, mantenendo la latenza locale, mentre il trasferimento verso una seconda regione avviene in background. L’applicazione continua a vedere un singolo bucket e non richiede modifiche al codice, mentre autorizzazioni e regole di conservazione rimangono coerenti indipendentemente dalla regione nella quale è stata effettuata la scrittura. CoreWeave indica questa soluzione come un modo per ridurre le pause durante il training e sostituire le procedure manuali necessarie per copiare o spostare checkpoint e altri dati tra regioni differenti.
La seconda novità è Archive, un tier di storage a costo inferiore destinato ai dati che devono essere conservati ma vengono consultati raramente. CoreWeave dichiara che il livello non applica commissioni per il recupero dei dati, per la lettura o per l’eliminazione anticipata e lo propone per elementi come checkpoint di esperimenti quasi riusciti, dataset necessari a riprodurre un risultato o versioni di modelli che potrebbero dover essere recuperate mesi dopo. Cohere utilizza già CoreWeave AI Object Storage per mantenere dataset distribuiti tra più regioni con letture memorizzate localmente, evitando che la pianificazione del training dipenda dai tempi di recupero attraverso la rete geografica.
Vera Rubin NVL72 è basato sulla terza generazione dell’architettura rack MGX NVL72 e NVIDIA lo indica ora come in piena produzione. Le specifiche pubblicate comprendono 20,7 TB di memoria HBM4 per rack con 1.400 TB/s di bandwidth, 216 TB/s di bandwidth NVLink attraverso NVLink 6 e 3.600 PFLOPS di capacità di inferenza sparse NVFP4. Le 36 CPU Vera forniscono complessivamente 3.168 core Olympus custom e fino a 54 TB di memoria LPDDR5X. NVIDIA dichiara inoltre che Vera Rubin NVL72 può addestrare modelli mixture-of-experts utilizzando un quarto delle GPU necessarie rispetto a GB200 NVL72 e ridurre fino a un decimo il costo per milione di token nell’inferenza agentica altamente interattiva e orientata al deep reasoning, con una produzione fino a dieci volte superiore di token per megawatt; NVIDIA specifica però che le cifre relative all’inferenza possono cambiare e che il confronto sul training è basato su prestazioni previste.
CoreWeave collega il nuovo cluster anche ai risultati ottenuti dalla propria infrastruttura nei benchmark precedenti, citando record MLPerf nell’inferenza e nel training e il livello Platinum ottenuto sia in SemiAnalysis ClusterMAX 1.0 sia in ClusterMAX 2.0. L’azienda segnala inoltre primi posti per velocità di inferenza e rapporto prezzo-prestazioni sui modelli Kimi K2.6 e Kimi K2.7 Code di Moonshot AI nelle misurazioni indipendenti di Artificial Analysis. Con la configurazione multi-rack Vera Rubin, l’obiettivo non è quindi soltanto aumentare il numero di acceleratori disponibili, ma farli operare come un singolo sistema cloud validato, con rete, gestione automatizzata e storage distribuito progettati per mantenere continuità operativa anche nei workload AI più grandi e sensibili alla latenza.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)