
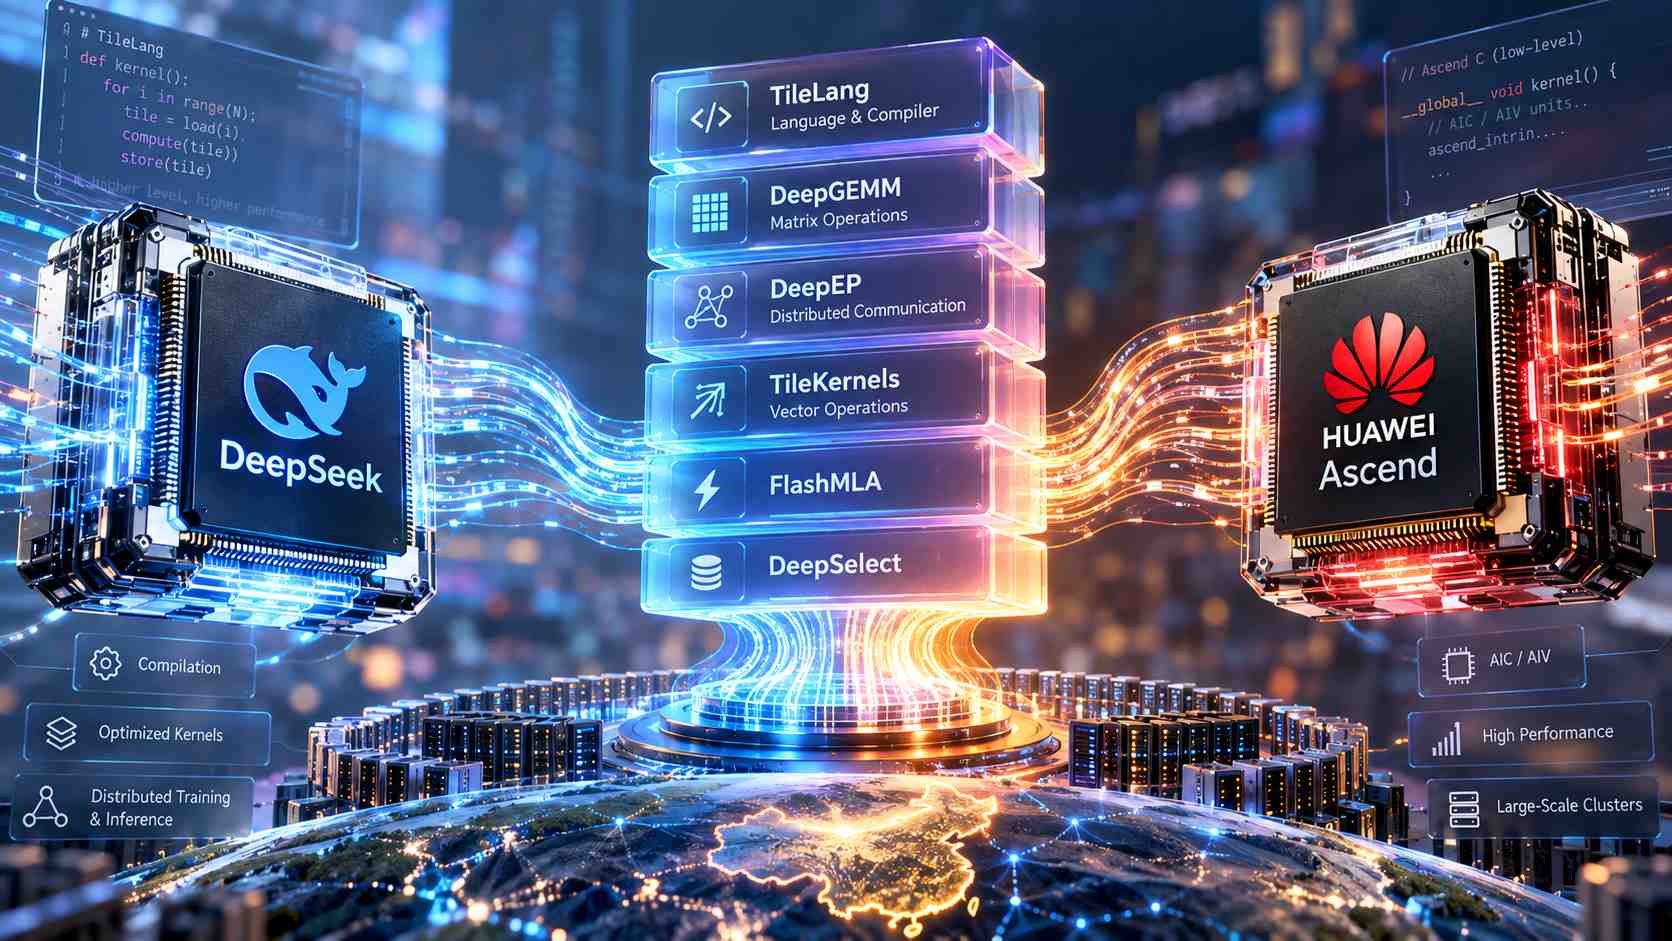
DeepSeek ha pubblicato in open source una serie di componenti software ottimizzati per la piattaforma AI Huawei Ascend, trasferendo sull’hardware cinese tecnologie che in precedenza erano state sviluppate principalmente per l’ambiente Nvidia. Il pacchetto comprende TileLang, un linguaggio e compilatore di alto livello per la programmazione dei chip Ascend, insieme a DeepGEMM per le operazioni matriciali, DeepEP per la comunicazione distribuita tra numerosi dispositivi, TileKernels per le operazioni vettoriali standard, FlashMLA e DeepSelect.
L’obiettivo è fornire uno stack capace di sfruttare in modo più efficace le unità AIC e AIV dei processori Ascend senza costringere gli sviluppatori a lavorare direttamente con Ascend C, il livello di programmazione più vicino all’hardware. TileLang agisce infatti come livello di astrazione sopra Ascend C e permette di implementare logiche complesse con un codice più semplice, mantenendo allo stesso tempo l’accesso alle prestazioni del chip. Secondo DeepSeek, un linguaggio di livello più alto e sufficientemente generale è una componente necessaria per costruire un ecosistema GPU autonomo che consenta di utilizzare in modo efficiente hardware non Nvidia.
La collaborazione tra DeepSeek e Huawei si è intensificata anche per effetto delle restrizioni che limitano l’accesso cinese ai processori Nvidia più avanzati. TileLang era già stato utilizzato nell’implementazione di operatori per DeepSeek-V4, presentato nell’aprile 2026, mentre le due aziende stanno lavorando anche a infrastrutture di calcolo di dimensioni molto maggiori. Tra i progetti citati figura la realizzazione in Mongolia Interna di un grande cluster per l’inferenza basato su 160.000 chip Huawei Ascend 950DT. Huawei ha inoltre sviluppato per i modelli DeepSeek configurazioni supernode basate su Ascend 950 con 128 schede, pensate per sostenere operazioni su contesti estremamente lunghi e per ottimizzare congiuntamente hardware e software. La pubblicazione dei nuovi componenti rafforza quindi uno stack che non riguarda soltanto il singolo acceleratore, ma comprende compilazione, kernel specializzati, comunicazione distribuita e infrastrutture su larga scala, con l’obiettivo di rendere più praticabile l’esecuzione di workload AI avanzati senza dipendere direttamente da CUDA.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)