
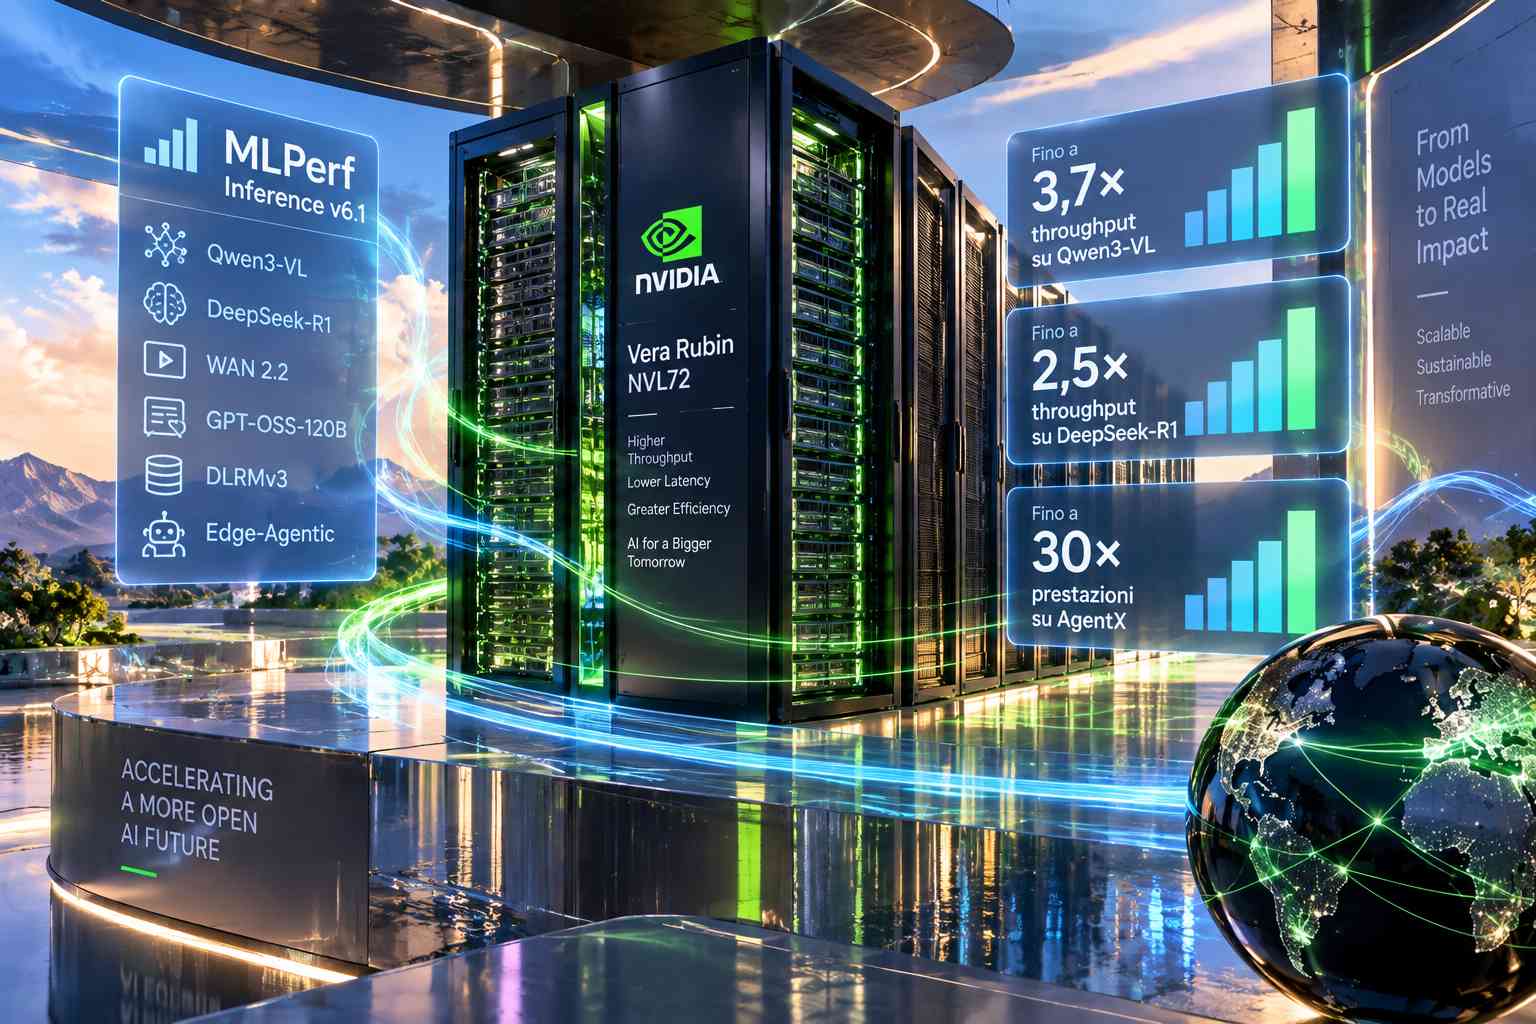
NVIDIA ha pubblicato i primi risultati preliminari di Vera Rubin NVL72 in MLPerf Inference v6.1, segnando il debutto della nuova piattaforma rack-scale nei benchmark standardizzati per l’inferenza AI. MLPerf Inference: Datacenter, sviluppato da MLCommons, misura la velocità con cui un sistema elabora gli input e produce risultati utilizzando modelli già addestrati; i dati citati da NVIDIA appartengono alla divisione Closed, nella quale deve essere utilizzato lo stesso modello della reference implementation per permettere confronti più omogenei tra hardware e stack software differenti. I sistemi classificati come Preview devono inoltre poter essere presentati come Available nella successiva tornata di benchmark. Nei test preliminari Vera Rubin NVL72 è stato sottoposto a Qwen3-VL e DeepSeek-R1, due dei workload più impegnativi della suite v6.1, ottenendo secondo NVIDIA fino a 3,7 volte il throughput di GB300 NVL72 su Qwen3-VL nei profili offline, server e interactive, con vLLM e il framework open source NVIDIA Dynamo, e fino a 2,5 volte il throughput su DeepSeek-R1 utilizzando TensorRT-LLM. I risultati citati corrispondono alle submission 6.1-0106 e 6.1-0074 pubblicate da MLCommons.
Secondo NVIDIA, il vantaggio prestazionale deriva dal codesign tra hardware e software adottato nella piattaforma Vera Rubin. I nuovi Tensor Core e il Transformer Engine sono stati progettati per accelerare sia la fase di prefill sia quella di decode dell’inferenza, mentre la precisione NVFP4 riduce l’occupazione di memoria dei pesi del modello, dei meccanismi di attention e della KV cache, aumentando il throughput con quella che l’azienda descrive come una perdita minima della qualità dell’output. I test sono stati eseguiti utilizzando anche il disaggregated serving, che separa prefill e decode, e una forte parallelizzazione degli expert nelle architetture mixture-of-experts adottate da modelli come DeepSeek-R1 e Qwen3-VL. L’infrastruttura NVL72 sfrutta inoltre NVLink di sesta generazione e NVLink Switch: NVIDIA dichiara un packet rate fino a 10 volte superiore e una latenza tre volte inferiore rispetto a Ethernet standard, caratteristiche pensate per sostenere queste tecniche su scala rack.
Vera Rubin NVL72 è stato inoltre sottoposto a test preliminari sul benchmark SemiAnalysis AgentX, destinato ai carichi di lavoro agentici, nel quale NVIDIA dichiara prestazioni fino a 30 volte superiori rispetto a GB300 NVL72. Questo tipo di test cerca di rappresentare scenari differenti dai benchmark di throughput tradizionali, nei quali un agente può eseguire molte fasi successive di inferenza e interagire con strumenti o servizi esterni. NVIDIA segnala che MLPerf introdurrà anche un nuovo benchmark Endpoints specificamente rivolto all’inferenza agentica, con l’obiettivo di fornire misurazioni standardizzate per questo genere di workload.
La stessa tornata MLPerf v6.1 ha fornito nuovi dati anche sull’attuale piattaforma GB300 NVL72. Nel benchmark DeepSeek-R1, NVIDIA ha scalato il sistema da un singolo rack con 72 GPU a quattro rack per un totale di 288 GPU, ottenendo il 99% di efficienza di scaling nello scenario offline, con una crescita del throughput quasi proporzionale all’hardware aggiunto. Nel benchmark WAN 2.2 per la generazione text-to-video, GB300 NVL72 ha raggiunto 0,65 video 720p al secondo con un tempo di generazione di 5,7 secondi per video, valori che NVIDIA confronta con un miglioramento di nove volte del throughput e una riduzione della latenza di 7,5 volte rispetto a un singolo nodo. Su Qwen3-VL, le prestazioni di GB300 NVL72 sono inoltre cresciute fino a 1,6 volte rispetto ai risultati MLPerf v6.0 grazie a interventi software come riduzione della precisione della KV cache, maggiore kernel fusion, nuovi kernel e utilizzo del disaggregated serving attraverso vLLM e NVIDIA Dynamo.
NVIDIA ha precisato che l’ottimizzazione software è proseguita anche dopo la chiusura delle submission ufficiali e ha riportato ulteriori miglioramenti su GPT-OSS-120B e DLRMv3, risultati che però non sono ancora stati verificati da MLCommons. Oltre ai sistemi da data center, l’azienda ha presentato anche risultati di Jetson AGX Thor sul nuovo benchmark Edge-Agentic, utilizzando la libreria TensorRT Edge-LLM e il modello Qwen3.6-27B, estendendo quindi la valutazione dei workload agentici anche alle piattaforme edge.
La tornata v6.1 ha coinvolto complessivamente 19 partner NVIDIA, otto dei quali hanno presentato risultati su sistemi Blackwell NVL72 multi-node. Tra i partecipanti figurano ASUS, Microsoft Azure, Cisco, CoreWeave, Crusoe, Dell Technologies, Fujitsu, Giga Computing, HPE, Inventec, Lambda, MiTAC Computing, Nebius, Oracle Cloud Infrastructure, Quanta Cloud Technology, Red Hat, ScitiX, Supermicro e Wiwynn. Anche Nebius ha presentato risultati preliminari con Vera Rubin NVL72 nella stessa tornata, mentre NVIDIA interpreta i dati complessivi come un’indicazione della capacità del nuovo sistema di aumentare il numero di token prodotti e di utenti serviti per rack, riducendo al tempo stesso il costo per token rispetto a GB300 NVL72. MLCommons ricorda comunque che i risultati pubblicati possono essere successivamente modificati o invalidati e che eventuali variazioni vengono registrate nel relativo change log.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)